Mac Studio M5 Ultra протыраўся з DGX Spark: швальнасць локальных LLM на тых сабе моделях.
Mac Studio M5 Ultra 256 GB протыраўся з аднай, двумя і чатырма прыстроямі DGX Spark на платформах Nemotron, Qwen3.8 і DeepSeek-V4.1-Flash: декодаванне, падзаполненне, групаванне дадзеных і обробка зяўроў.
Якщо модель не пасуее на графічныя процэсоры для гэмінгу, то наступныя два прылады, якія часта рассматрываюць, — это Mac Studio M5 Ultra і DGX Spark ад NVIDIA. Обе прылады выкарыстоўваюць аб’еднаную памяць, стояць на столе і продаюцца як прылады для роботы з ШІ. Їхня робота сутэчна разлічна, калі ўпорацаваць іх з аднаковымі моделямі.
У нашым прыкладзе Mac — цэе Mac Studio M5 Ultra з 256 ГБ аб’еднанай памяці. У разе Spark мова йде пра прылады на 1, 2 або 4 ГБ10, кожная з якіх мае 128 ГБ памяці; яны з’ѐднаны прямымі кабелямі ConnectX-7 для реалізацыі паралелізма тэнзораў; па-разна з НВДИЯ-ўласнай прыладай, такія багатокорпусныя прылады выкарыстоўваюць прылады ASUS Ascent GX10, Gigabyte AI TOP ATOM і Lenovo ThinkStation PGX, побудаваныя на тым жа чыпе. Кожны запуск выкарыстоўвае аднаковы набор параметраў: адпаведзі на 512 токенав, перыяд падготовкі, вычысленне медыан, періяд размышлення.
Аднаковая модель, две прылады
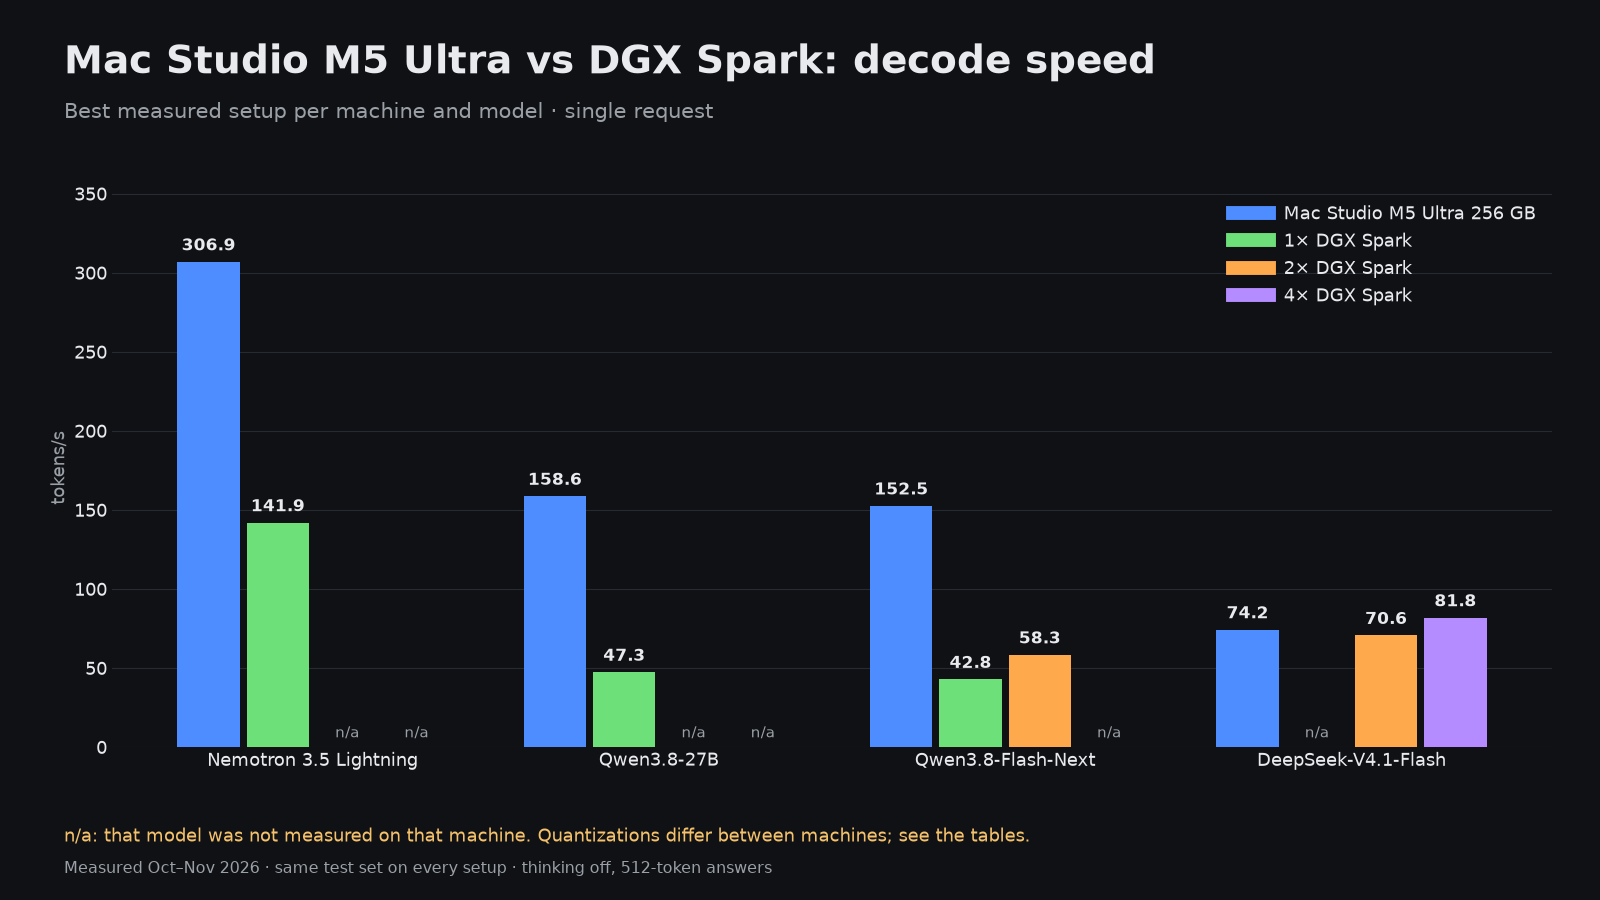
| Модэль | Mac Studio M5 Ultra | 1× DGX Spark | 2× DGX Spark | 4× DGX Spark |
|---|---|---|---|---|
| Nemotron 3.5 Lightning 30B-A3B, MLX 4-bit, TensorFold 1.2.5 | 306,9 tok/s | 141,9 tok/s | n/a | n/a |
| Qwen3.8-27B з DFlash2, TensorFold | 158,6 tok/s (MLX 4-bit) | 47,3 tok/s (EXL3 4,0 bpw) | n/a | n/a |
Nemotron 3.5 Lightning ўтварае найсправедлівейшыя умовы для парабярання: тая ж версія TensorFold 1,2.5, тыя ж 4-бітныя вагі MLX, тыя ж праекты MTP. Mac декодуе на 306,9 tok/s, адзін Spark — на 141,9. Якосьць на обох апаратах аднаковая (51,4 % проты 51,9 %), што і як і магчыма для ідэнтычных ваг. У цых тэстах GPU Sparkа мае частоту, обмежаную до 2200 МГц.
У версіі Qwen3.8-27B з высокай ўтрамбоўкай разлік ўсё большы: 158,6 tok/s на Mac проты 47,3 на аднам Spark. Шырыня пасекі памяці вялікага значэнняя для процэса декодавання, і M5 Ultra мае значна большую яе, чым адзін GB10. Qwen3.8-Flash-Next паказвае той самы патэрн – нават два Spark у режыме тэнзорнага паралелізма (58,3 tok/s) застаюцца далека ад аднаго Mac (152,5 tok/s).
DeepSeek-V4.1-Flash – гэта там, дзе кластэр Spark наздаганяе
Большы модэльы з тэхнологіяй MoE зміняюць ситуацыю. На Mac двіжак Metal ад TensorFold запускае версію з 2/3 бітамі з шырошчынай потоку 74,2 tok/s і выкарыстоўвае 206,3 GiB з 256 GB памяці. Два Spark з версіяй EXL3 з шырошчынай потоку 2,5 bpw досягаюць 70,6 tok/s, а чатыры Spark з версіяй 4,0 bpw – 81,8 tok/s; гэта ўсё, што можа перагнаць Mac у цім модэлі, пры чым вяршыцца таксама з вялікім квантаваннем.
Якасць працы ўсіх прыстроёў падобная: 67,4 % на Mac, 66,1 % на двух Spark-ах, 66,6 % на чатырох. На Mac таксама запускаюцься іншыя версіі DeepSeek: двыжок ds4 з квантаваннем Q2 дае 69,7 % з шырохватам 54,5 tok/s, а oMLX з LSQ3 — 60,0 % з шырохватам 63,8 tok/s, пры чым викорыстоўваецца 225,6 GiB.
Обробка запитаў
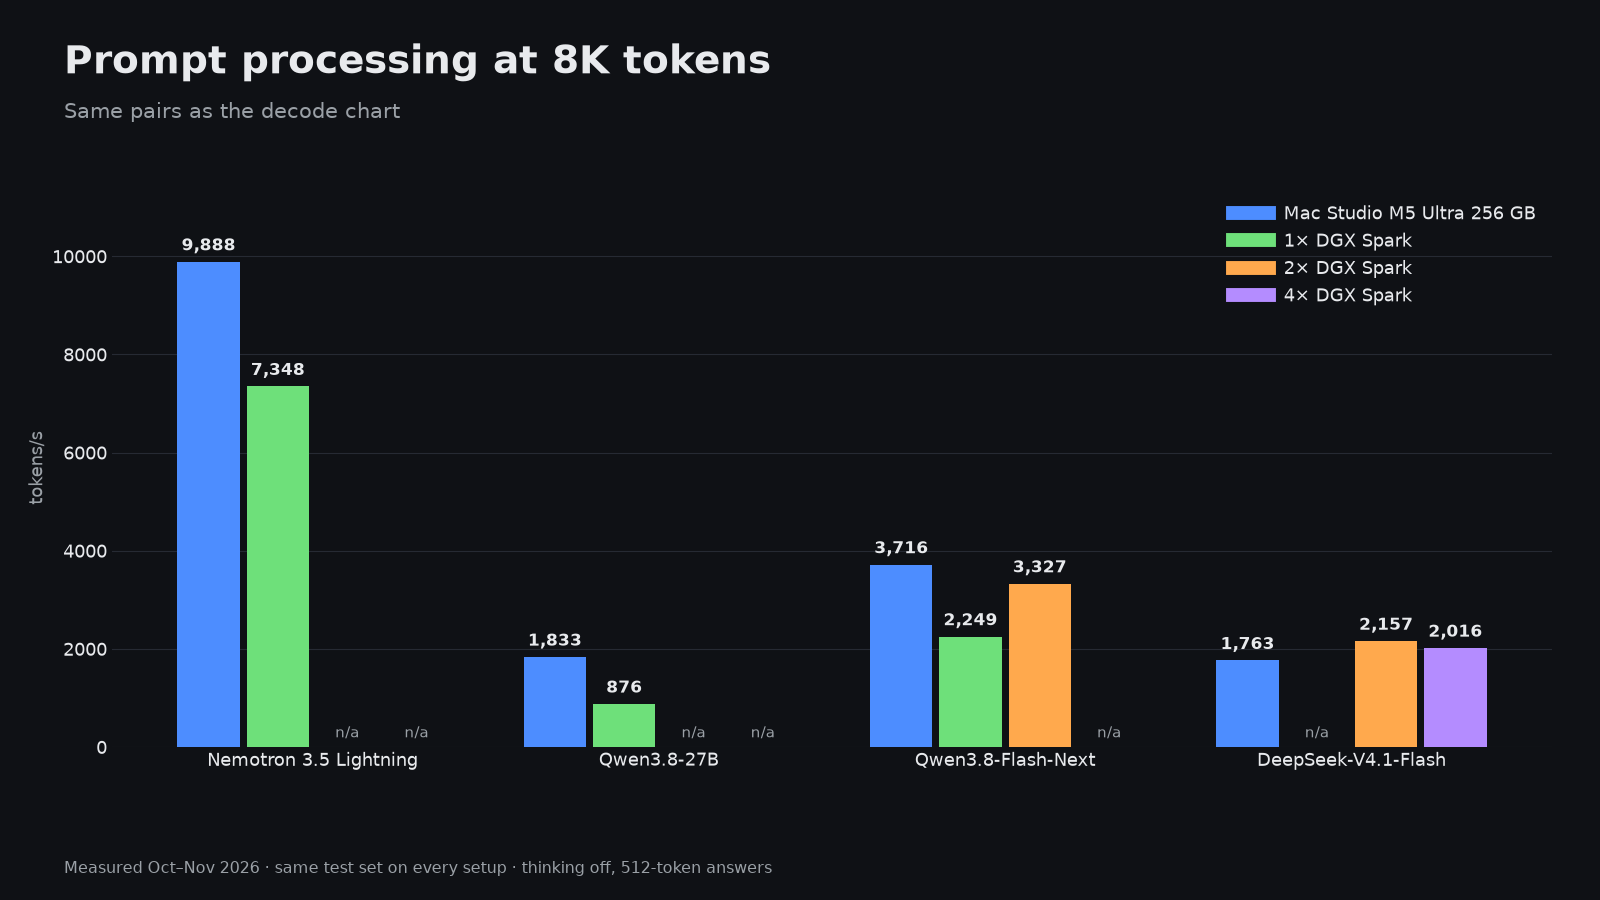
Пры заполнэнні памяці раней выконваецца задача, чым декодаванне. У Nemotron Lightning Mac чытае 8K запрос за 9,888 tok/с, а ў Spark — за 7,348 tok/с. У ўщэ болей ўплотненай версіі Qwen3.8-27B ці гэты показнік становіць 1,833 проты 876. У DeepSeek-V4.1-Flash перавагу мае версія Spark: 2,157 tok/с на двух прыстроях і 2,016 tok/с на чатырох, проты 1,763 tok/с у Mac. Час обробкі першага токена для 32K запросу у DeepSeek на Mac станавіць 18,3 секунды, на двух прыстроях Spark — 17,9 секунды, а на чатырох — 15,8 секунды.
Паралельныя запросы
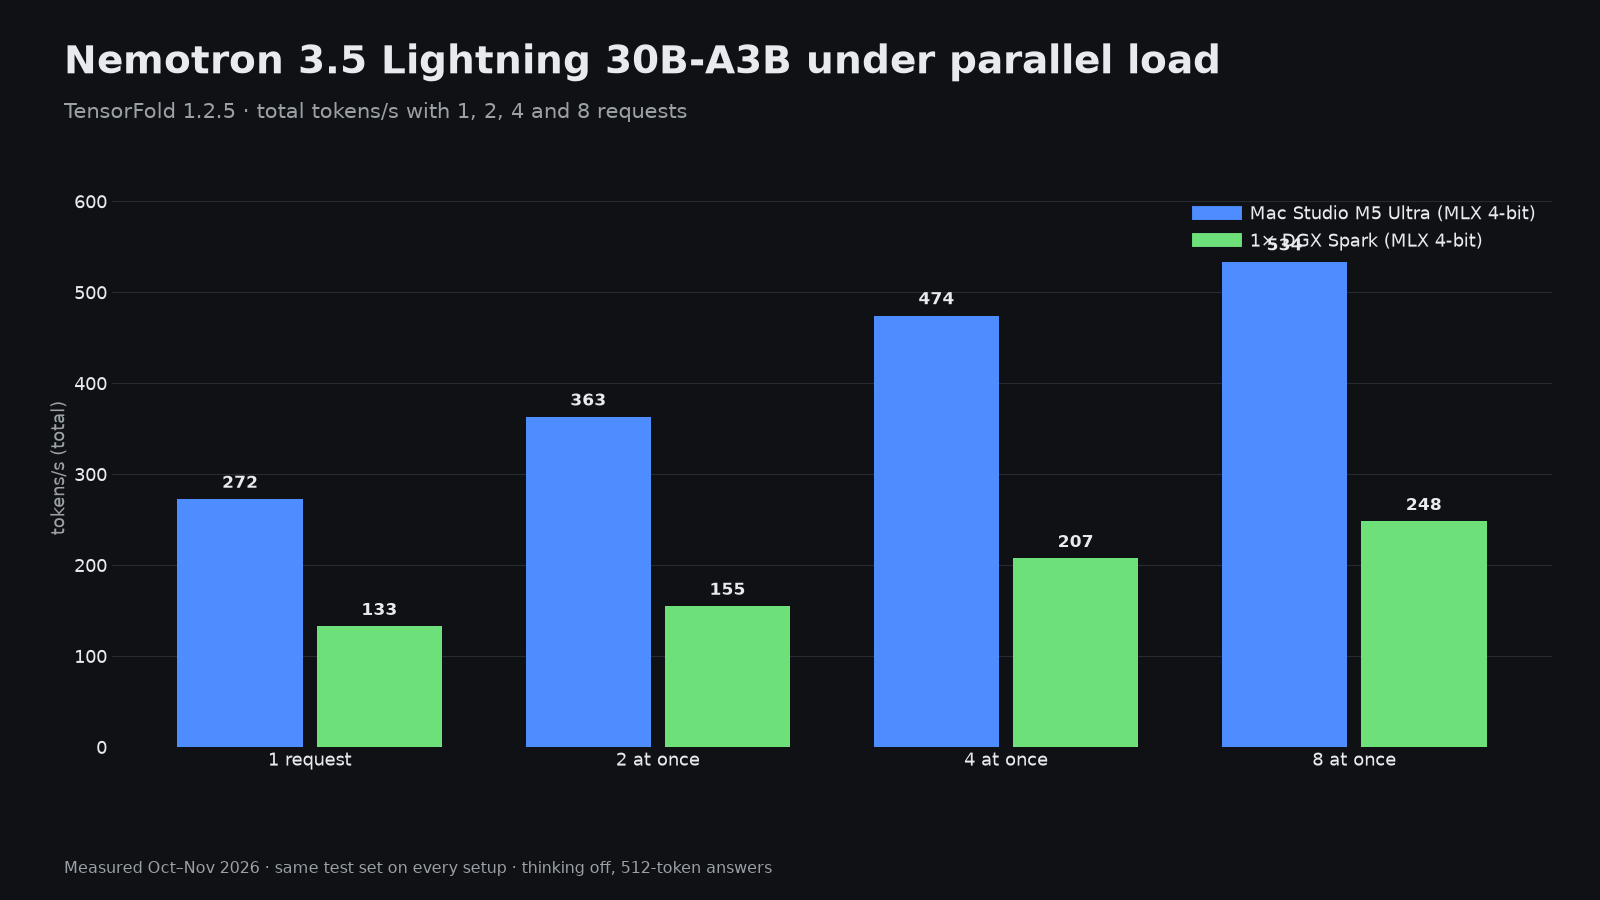
Обе машыны добра ўпрацоўваюць пакеты даных у модэлі MoE. З восьмі паралельных запыткаў Mac даходзіць да 533,5 tok/s ў суме, а Spark — 248,0 tok/s. У DeepSeek чатыры Spark даходзяць да 141,2 tok/s за восьмі запыткі, а Mac — 84,5.
Зображэнні і відэа
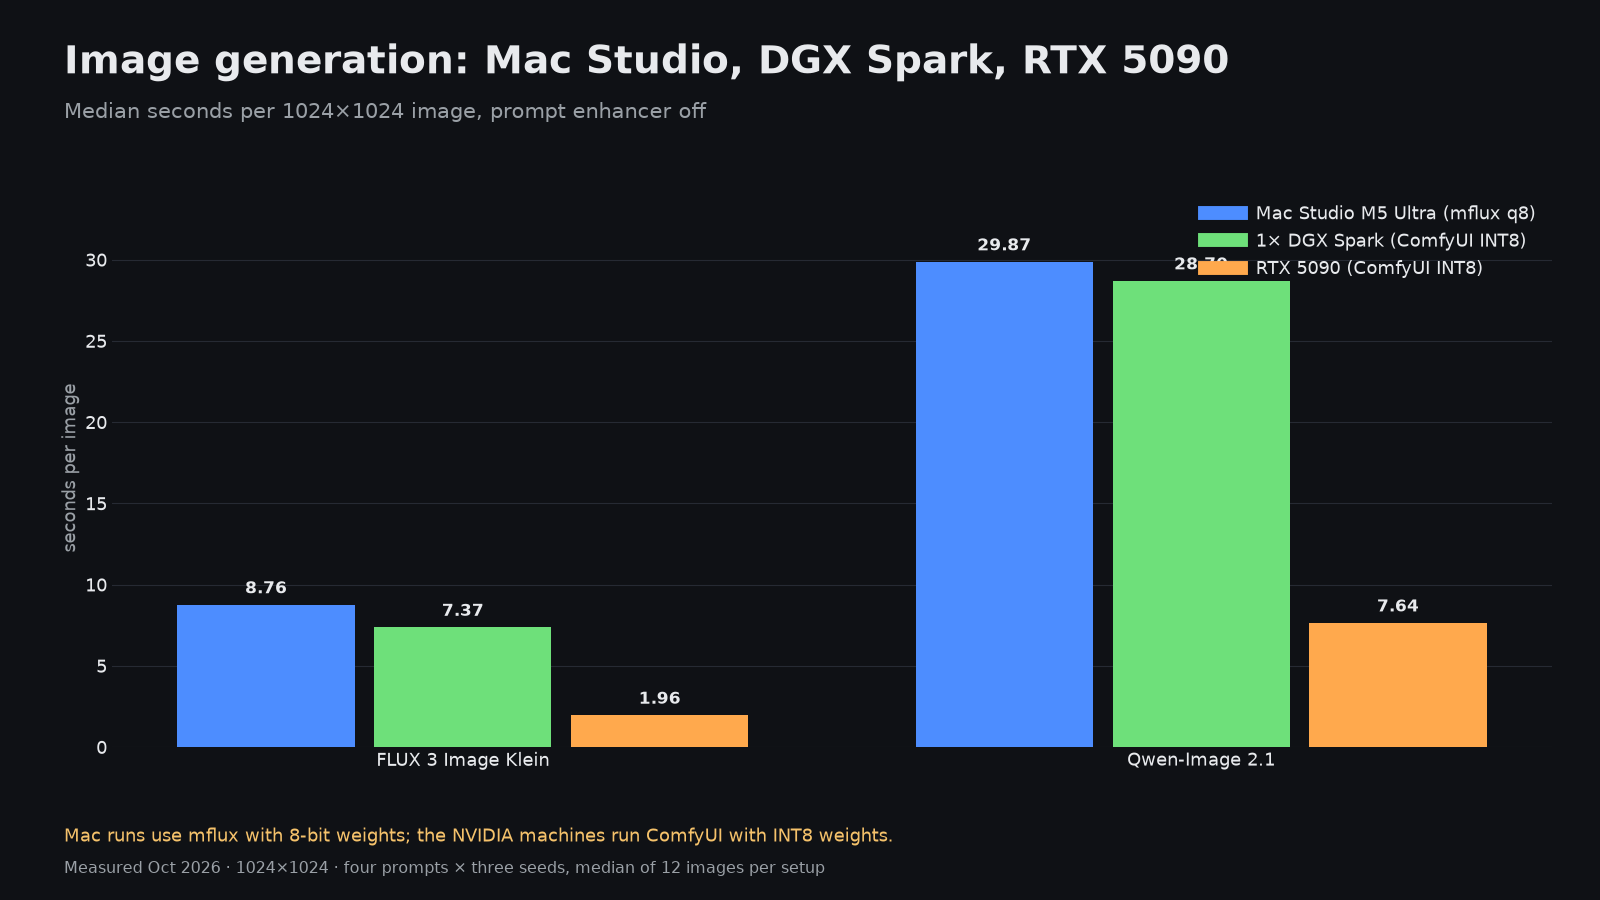
Для модэлей дыфузіі жаданая швальна працэ не атрымліваецца ні аднай з машын. FLUX Klein выконвае обробку адной зображэння за 8,76 секунды на Mac і за 7,37 секунды на Spark; Qwen-Image 2,1 — за 29,87 секунды і за 28,7 секунды. RTX 5090 выконвае тыя ж задачі за 1,96 секунды і за 7,64 секунды. 128 ГБ памяці у Spark дазволяюць експлуатаваць вельмі большыя відео-задачы: перакрэйсленне 5-секунднага праекта з размахамі 2560×1440 за дапамою Open-H3-Regenerate займае апошнейша 22 хвіліны на кожны кліп, пры чым пік памяці становіць 78,9 ГіБ, што значна больша, чым можа разам памяць карты з 32 ГБ.
Каторая машына — для чаго
- Для аднай особы, якая хочаць найшвальнейшую машыну: Mac Studio M5 Ultra. Яна працуе у два-трыя з половай раза швальней за Spark па тых сабе модэлях і можа сама выконваць DeepSeek-V4,1-Flash з частотай 74,2 ток/секунды.
- Для стварэння кластэра з часам: Spark. Две машыны выконваюць DeepSeek-V4,1-Flash з такой жа швальнасцю, як і Mac, а чатыры машыны — з большым квантаванням.
- Адынственнае выкарыстоўванне CUDA, пункты контролю NVFP4 і рэцэпты vLLM або SGLang: Spark, таму што програмнае забезпечэнне, якое вы хочаце, вже падтрымлівае яго.
- Зображэнні і короткія відэа: ніякога з гэтага. Паставьце RTX 5090 паляў праз тое, калі ўжо выбералі.
- Дужа вялікія відэа і задачы дифузіі, якія трэбуюць многа памяці: Spark, за 128 ГБ памяці, якая можа быть выкарыстоўвана GPU.