Mac Studio M5 Ultra проти DGX Spark: швидкість роботи локальних моделей ШІ з однаковими моделями.
Mac Studio M5 Ultra 256 GB проти однієї, двох та чотирьох модулів DGX Spark на платформах Nemotron, Qwen3.8 та DeepSeek-V4.1-Flash: декодування, попереднє заповнення, обробка пакетами та робота з зображеннями.
Якщо модель не підходить для використання на геймінговій GPU, наступними пристроями, які зазвичай розглядають, є Mac Studio M5 Ultra та DGX Spark від NVIDIA. Обидва використовують об’єднану пам’ять, є настільними пристроями та продаються як пристрої для роботи з ШІ. Їхня продуктивність суттєво відрізняється, якщо порівнювати їх на однакових моделях.
У цьому випадку Mac – це Mac Studio M5 Ultra з 256 ГБ об’єднаної пам’яті. У серії Spark є пристрої об’ємом 1, 2 чи 4 ГБ10, кожен з яких має 128 ГБ пам’яті; вони з’єднані прямими кабелями ConnectX-7 для забезпечення паралелізму обчислень. Окрім власного пристрою від NVIDIA, для багатокорпусних систем використовуються пристрої ASUS Ascent GX10, Gigabyte AI TOP ATOM та Lenovo ThinkStation PGX, побудовані на тому самому чипі. Кожен запуск використовує однакові параметри: відповіді довжиною 512 токенів, етап підготовки, обчислення медіан та етап роздумів.
Одна і та сама модель, обидва пристрої
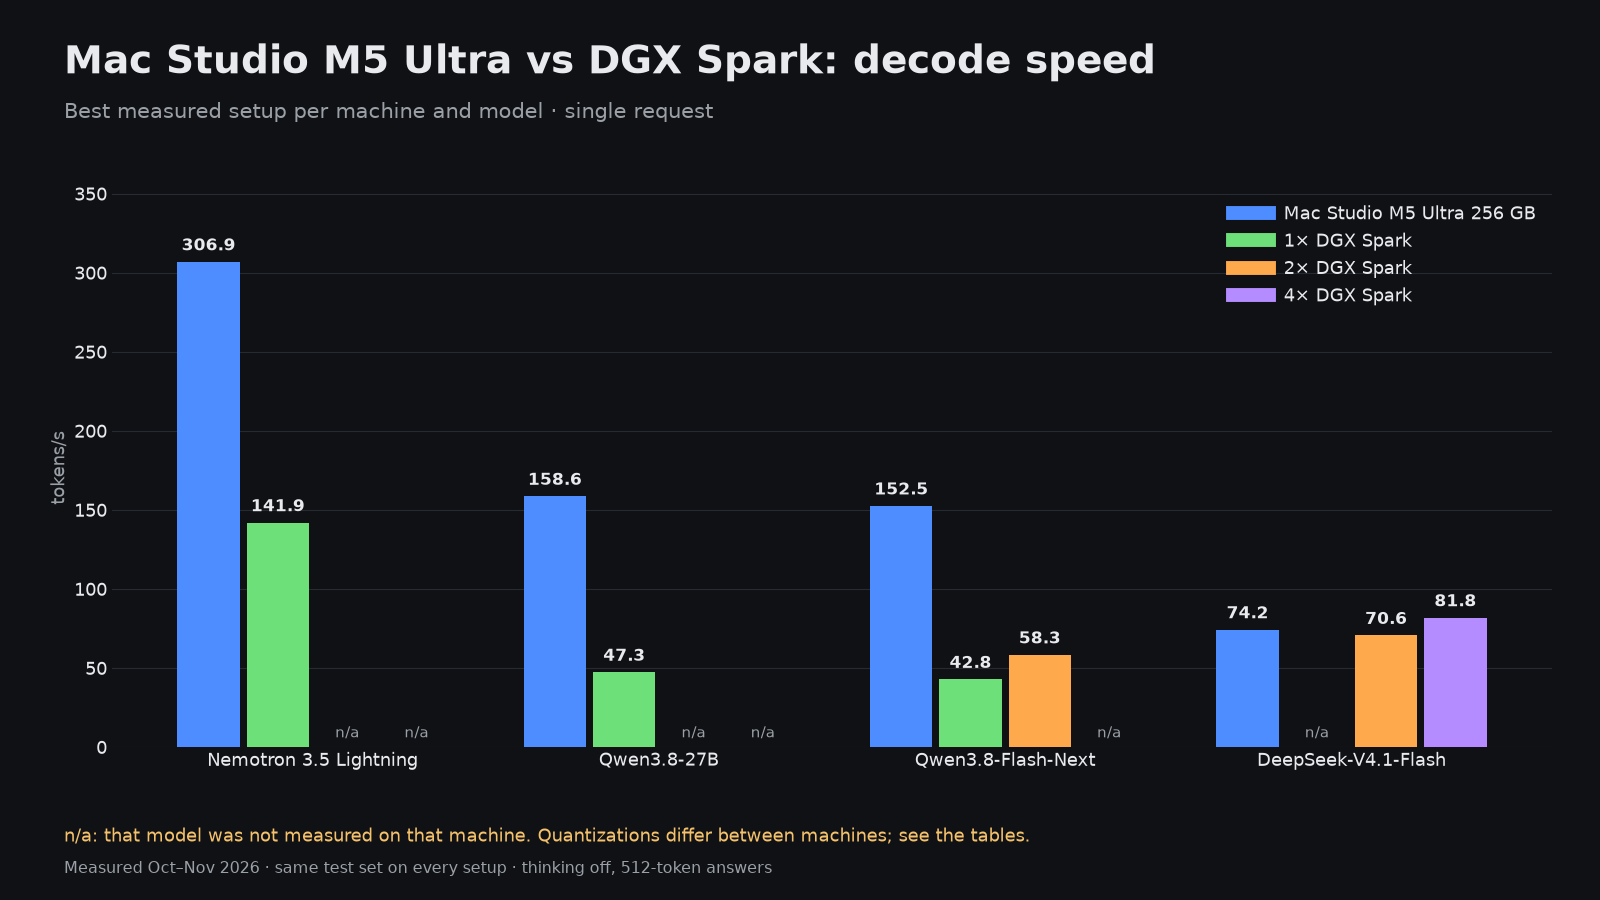
| Модель | Mac Studio M5 Ultra | 1× DGX Spark | 2× DGX Spark | 4× DGX Spark |
|---|---|---|---|---|
| Nemotron 3.5 Lightning 30B-A3B, MLX 4-bit, TensorFold 1.2.5 | 306,9 tok/s | 141,9 tok/s | n/a | n/a |
| Qwen3.8-27B з DFlash2, TensorFold | 158,6 tok/s (MLX 4-bit) | 47,3 tok/s (EXL3 4.0 bpw) | n/a | n/a |
Nemotron 3.5 Lightning є найсправедливішим для порівняння: та сама версія TensorFold 1.2.5, ті самі ваги MLX у 4 біта, ті самі проєкти MTP. Mac декодує зі швидкістю 306,9 ток/с, один Spark — зі швидкістю 141,9. Якість на обох однакова (51,4 % проти 51,9 %), що є очікуваним для ідентичних ваг. У цих тестах GPU Spark має обмежену частоту 2200 МГц.
На потужному Qwen3.8-27B різниця ще більша: 158,6 tok/s на Mac проти 47,3 на одному Spark. Ширина пам’яті визначає швидкість декодування, і у M5 Ultra вона значно більша, ніж у одного GB10. Qwen3.8-Flash-Next демонструє таку саму картину – навіть два Spark у режимі тензорного паралелізму (58,3 tok/s) значно відстають від одного Mac (152,5 tok/s).
DeepSeek-V4.1-Flash – це той випадок, коли кластер Spark наздоганяє
Велика модель типу MoE змінює ситуацію. На Mac двигун Metal від TensorFold обробляє версію з 2/3 бітів зі швидкістю 74,2 tok/s та використовує 206,3 GiB з 256 GB пам’яті. Два Spark із версією EXL3 зі шириною каналу 2,5 bpw досягають швидкості 70,6 tok/s, а чотири Spark із версією 4,0 bpw – 81,8 tok/s; це єдиний варіант, який перевершує Mac у роботі з цією моделлю та водночас використовує більшу ступінь квантування.
Якість приблизно однакова у всіх варіантах: 67,4 % на Mac, 66,1 % на двох Spark-системах та 66,6 % на чотирьох. На Mac також працюють інші версії DeepSeek: двигун ds4 з квантуванням Q2 досягає 69,7 % зі швидкістю 54,5 токів/с, а oMLX з LSQ3 — 60,0 % зі швидкістю 63,8 токів/с, використовуючи 225,6 ГБ пам’яті.
Обробка запитів
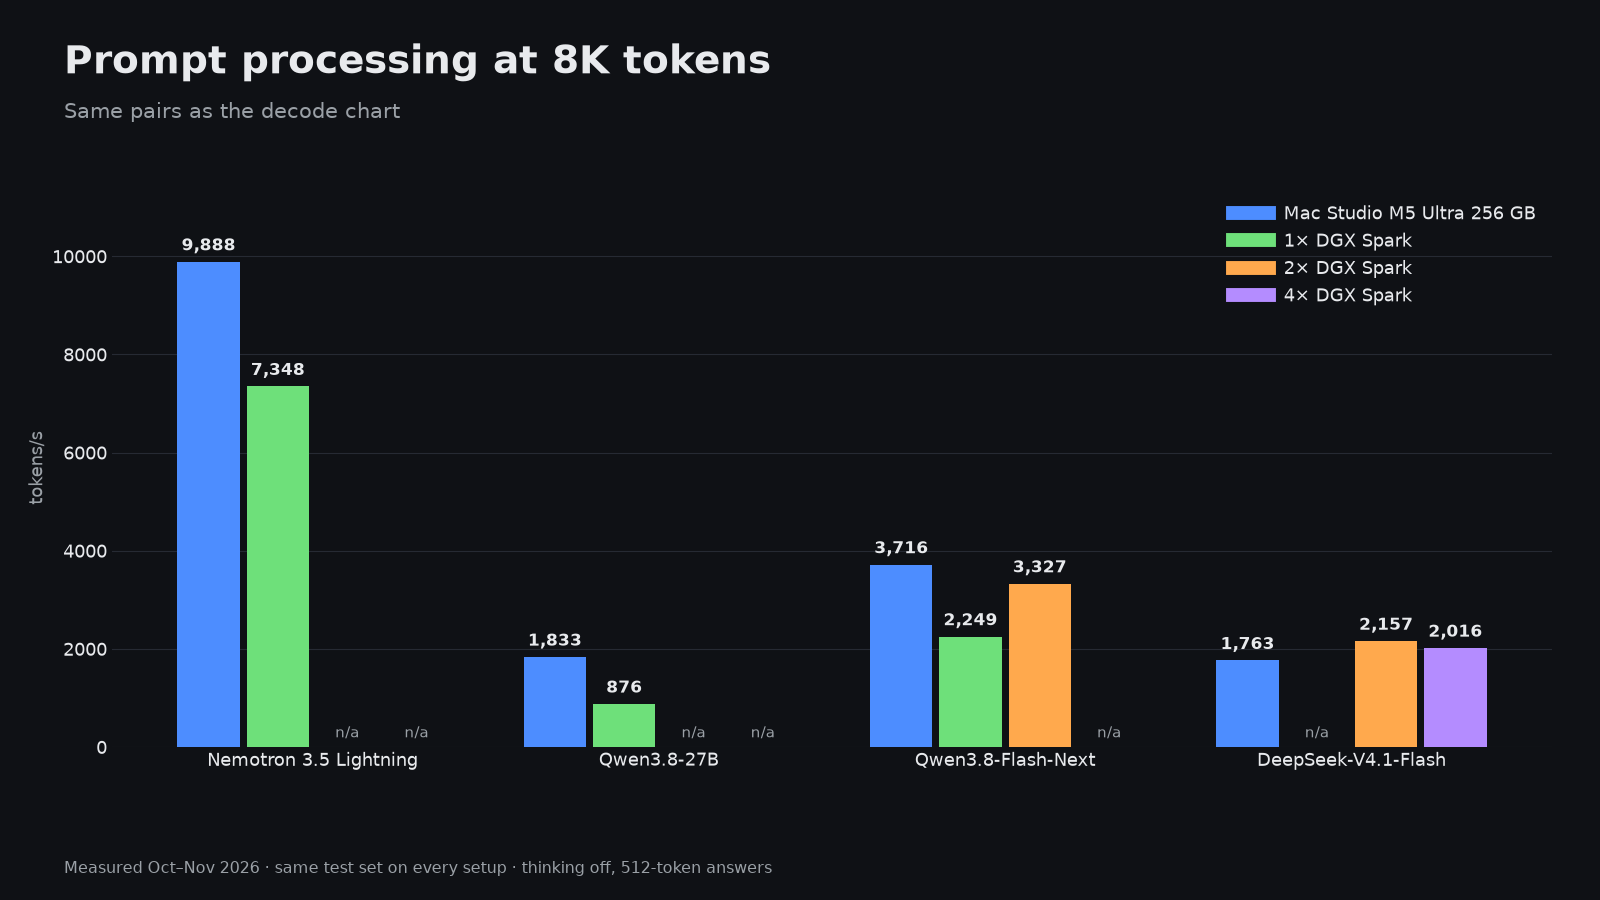
Процес заповнення пам’яті відбувається швидше, ніж процес декодування. На Nemotron Lightning Mac обробляє запит довжиною 8K зі швидкістю 9,888 токів/с, а один Spark — 7,348 токів/с. На щільній моделі Qwen3.8-27B ці показники становлять 1,833 проти 876 токів/с. На DeepSeek-V4.1-Flash перевагу має версія з Spark: 2,157 токів/с на двох пристроях та 2,016 токів/с на чотирьох, проти 1,763 токів/с у Mac. Обробка першого токена запиту довжиною 32K на DeepSeek займає 18,3 секунди у Mac, 17,9 секунди на двох Spark-ах та 15,8 секунди на чотирьох.
Паралельні запити
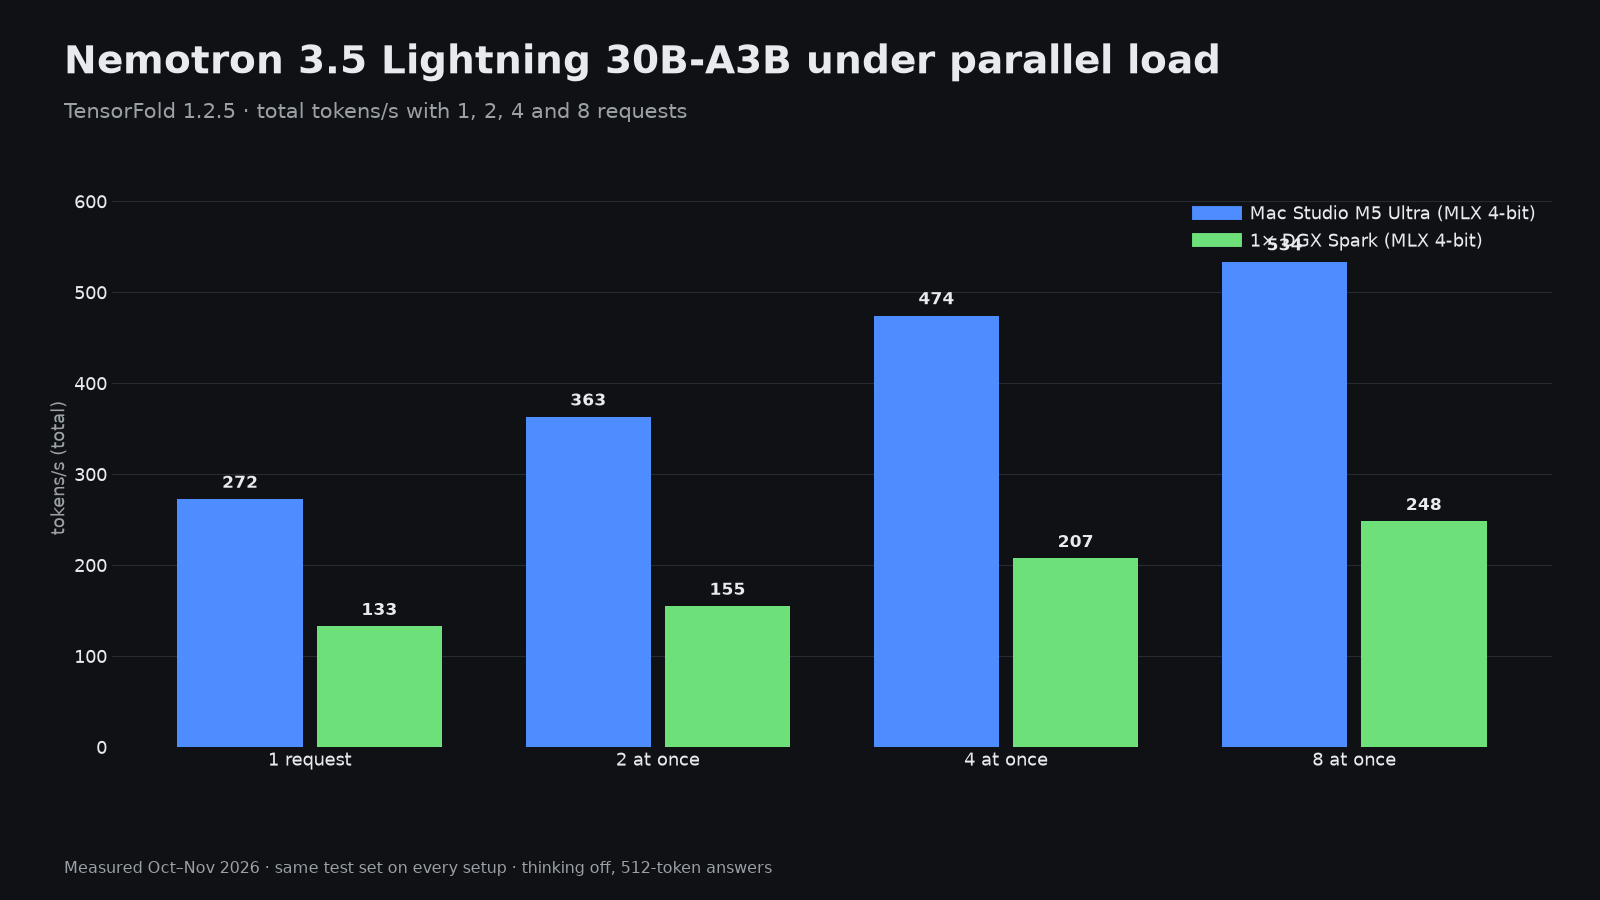
Обидві машини добре працюють у пакетному режимі з моделлю MoE. При восьми паралельних запитах Mac досягає загальної швидкості 533,5 tok/с, а Spark — 248,0 tok/с. На платформі DeepSeek чотири пристрої Spark досягають швидкості 141,2 tok/с при восьми запитах, тоді як Mac — 84,5 tok/с.
Зображення та відео
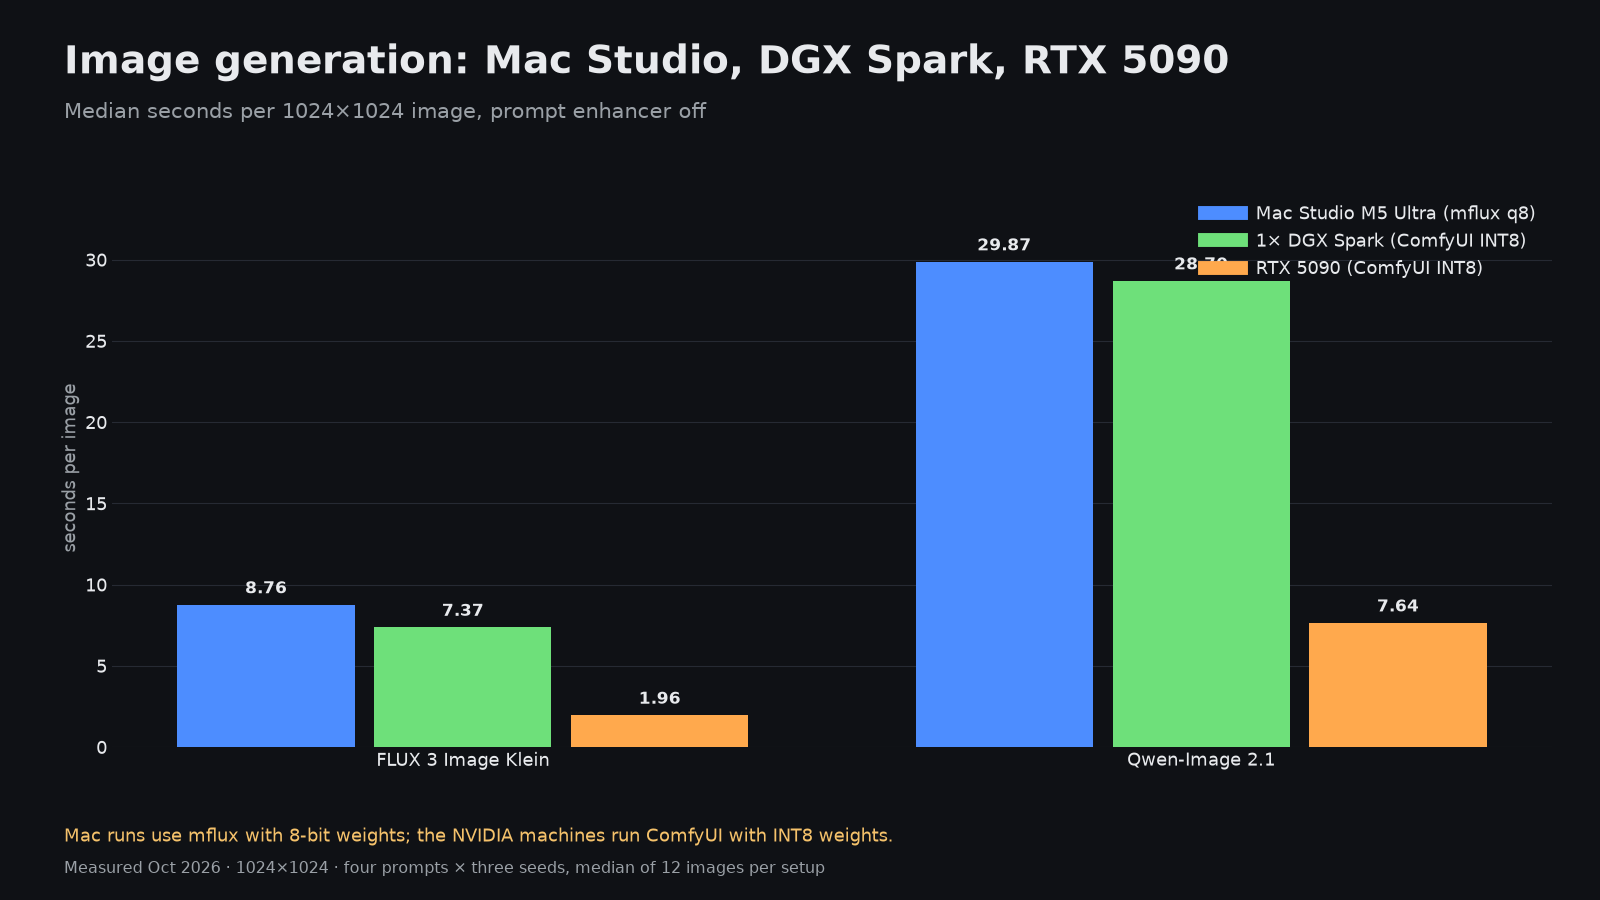
Для моделей дифузії жоден з цих пристроїв не є швидким. FLUX Klein виконує обробку одного зображення за 8,76 секунди на Mac та 7,37 секунди на Spark; Qwen-Image 2.1 — за 29,87 секунди та 28,7 секунди. RTX 5090 обробляє ті самі зображення за 1,96 секунди та 7,64 секунди. 128 ГБ пам’яті у Spark дозволяють виконувати дуже великі завдання з відео: переробка 5-секундного чернетка у форматі 2560×1440 за допомогою Open-H3-Regenerate займає близько 22 хвилин на кліп при піку пам’яті 78,9 ГіБ, що значно більше, ніж може вмістити картка з 32 ГБ.
Який вибрати для чого
- Якщо потрібен найшвидший пристрій: Mac Studio M5 Ultra. Він у два–три з половиною рази швидший за Spark при обробці тих самих моделей та може самостійно виконувати DeepSeek-V4.1-Flash зі швидкістю 74,2 ток/сек.
- Якщо планується поступове створення кластера: Spark. Два пристрої можуть виконувати DeepSeek-V4.1-Flash зі швидкістю Mac, а чотири пристрої — з більшою ступенем квантування.
- Інструменти, які працюють лише з CUDA, контрольні точки NVFP4 та рецепти vLLM чи SGLang: Spark, оскільки програмне забезпечення, яке ви хочете використовувати, вже підтримує його.
- Зображення та короткі відео: жоден з варіантів. Поставте RTX 5090 поруч із тим пристроєм, який ви оберете.
- Дуже великі відео та завдання на дифузію, які потребують багато пам’яті: Spark, завдяки 128 ГБ пам’яті GPU.