Mac Studio M5 Ultra gegen DGX Spark: Geschwindigkeit lokaler LLMs mit denselben Modellen.
Mac Studio M5 Ultra 256 GB gegen eine, zwei und vier DGX Spark-Boxen auf Nemotron, Qwen3.8 und DeepSeek-V4.1-Flash: Dekodierung, Vorausfüllen, Batching und Verarbeitung von Bildern.
Falls ein Modell nicht auf einer Gaming-GPU läuft, sind die beiden Geräte, auf die die meisten Menschen anschließend schauen, das Mac Studio M5 Ultra sowie NVIDIAs DGX Spark. Beide verwenden einheitliche Speicher, können auf einem Schreibtisch platziert werden und werden als lokale KI-Systeme verkauft. Wenn man sie mit denselben Modellen vergleicht, weisen sie jedoch sehr unterschiedliches Verhalten auf.
Das hier genannte Mac-Gerät ist ein Mac Studio M5 Ultra mit 256 GB an einheitlichem Speicher. Bei DGX Spark handelt es sich um Einzel-, Zwei- oder Vier-GB10-Systeme mit jeweils 128 GB Speicher, die über direkte ConnectX-7-Kabel miteinander verbunden sind, um Tensor-Parallelismus zu ermöglichen; neben NVIDIAs eigenem Gerät werden auch ASUS Ascent GX10-, Gigabyte AI TOP ATOM- sowie Lenovo ThinkStation PGX-Systeme mit demselben Chip eingesetzt. Jeder Test verwendet dieselben Parameter: Antworten mit 512 Token, eine Aufwärmphase, Berechnung der Medianwerte sowie eine Denkzeit.
Das gleiche Modell, beide Geräte
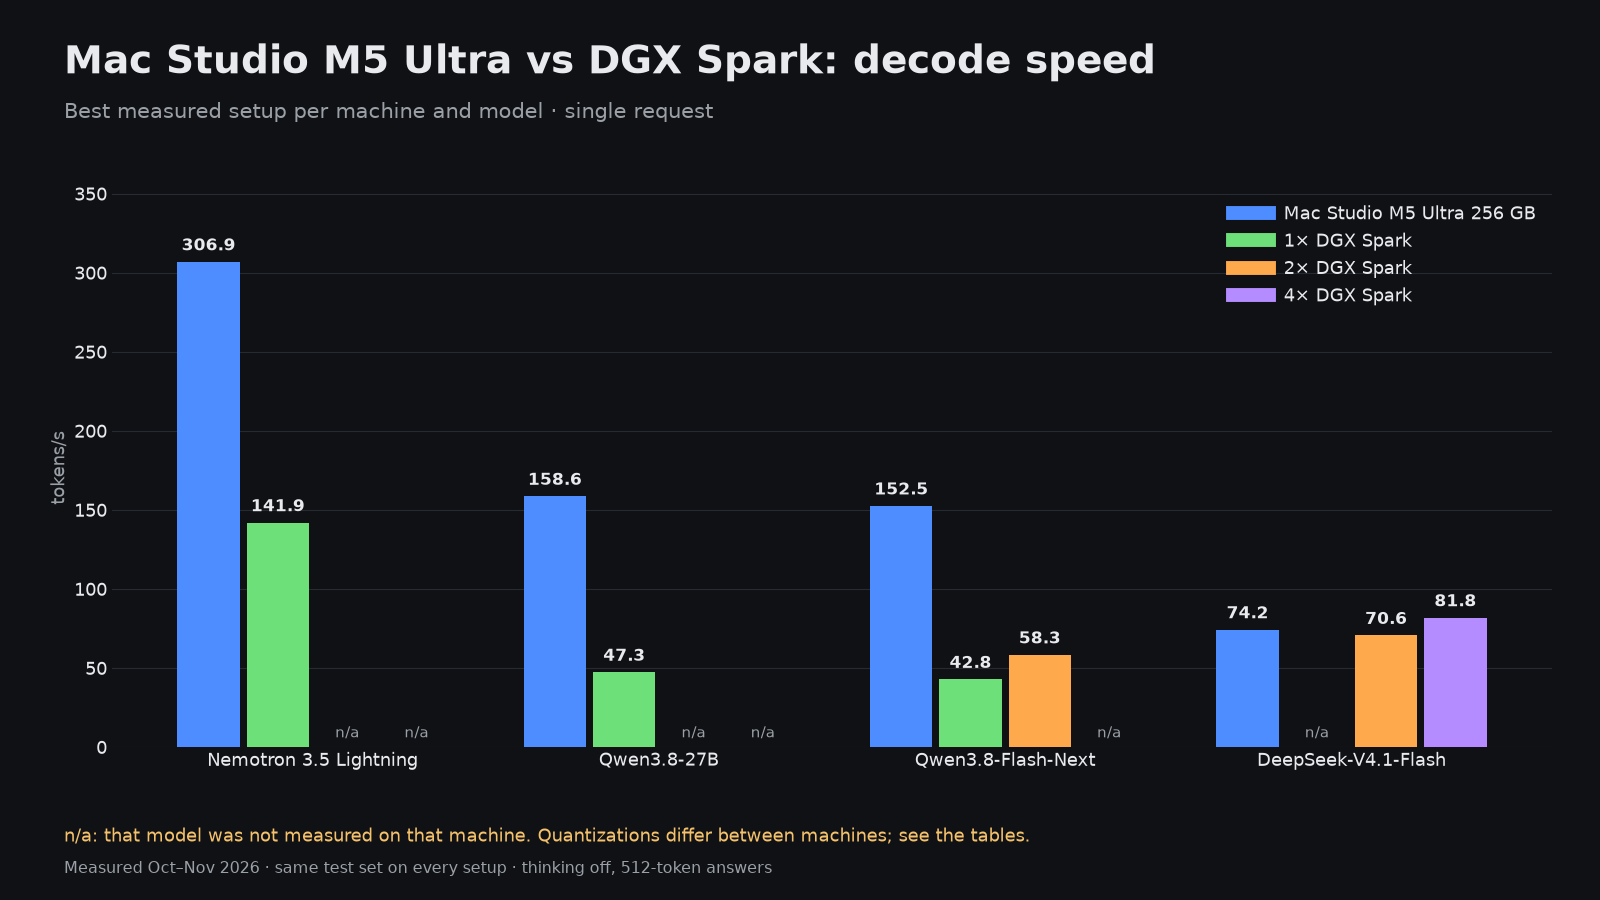
| Modell | Mac Studio M5 Ultra | 1× DGX Spark | 2× DGX Spark | 4× DGX Spark |
|---|---|---|---|---|
| Nemotron 3.5 Lightning 30B-A3B, MLX 4-bit, TensorFold 1.2.5 | 306,9 tok/s | 141,9 tok/s | n/a | n/a |
| Qwen3.8-27B mit DFlash2, TensorFold | 158,6 tok/s (MLX 4-bit) | 47,3 tok/s (EXL3 4,0 bpw) | n/a | n/a |
Nemotron 3.5 Lightning bietet den fairensten Vergleich: gleiche TensorFold 1,2.5-Version, gleiche MLX-4-Bit-Gewichte, gleiche MTP-Entwürfe. Der Mac decodiert mit 306,9 Tok/s, ein Spark mit 141,9. Die Qualität ist bei beiden identisch (51,4 % gegenüber 51,9 %), was man von identischen Gewichten erwarten würde. Der Spark in diesen Tests hat seine GPU-Taktfrequenz auf 2200 MHz begrenzt.
Auf dem leistungsstarken Qwen3.8-27B ist der Unterschied noch größer: 158,6 Tok/s auf dem Mac gegenüber 47,3 Tok/s auf einem Spark. Die Speicherbreite bestimmt die Dekodiergeschwindigkeit, und der M5 Ultra verfügt über deutlich mehr davon als ein einzelner GB10. Auch Qwen3.8-Flash-Next zeigt dieses Muster – selbst zwei Sparks im Tensor-Parallelbetrieb (58,3 Tok/s) liegen weit hinter einem Mac (152,5 Tok/s).
DeepSeek-V4.1-Flash ist der Punkt, an dem der Spark-Cluster aufschließt
Das große MoE-Modell verändert das Bild. Auf dem Mac läuft die Metal-Engine von TensorFold mit einer 2/3-Bit-Quantisierung bei 74,2 Tok/s und verbraucht 206,3 GiB der verfügbaren 256 GB. Zwei Sparks mit einer 2,5 bpw EXL3-Quantisierung erreichen 70,6 Tok/s, während vier Sparks mit einer 4,0 bpw-Quantisierung 81,8 Tok/s erreichen – das ist die einzige Konfiguration, die bei diesem Modell schneller ist als der Mac und gleichzeitig eine höhere Quantisierung verwendet.
Die Qualität ist bei allen Geräten ähnlich: 67,4 % auf dem Mac, 66,1 % auf zwei Sparks und 66,6 % auf vier Sparks. Der Mac läuft auch andere DeepSeek-Versionen: Der ds4-Engine mit Q2-Quantisierung erzielt 69,7 % bei 54,5 Tok/S, während oMLX mit LSQ3 60,0 % bei 63,8 Tok/S erreicht und dabei 225,6 GiB verbraucht.
Prompt-Verarbeitung
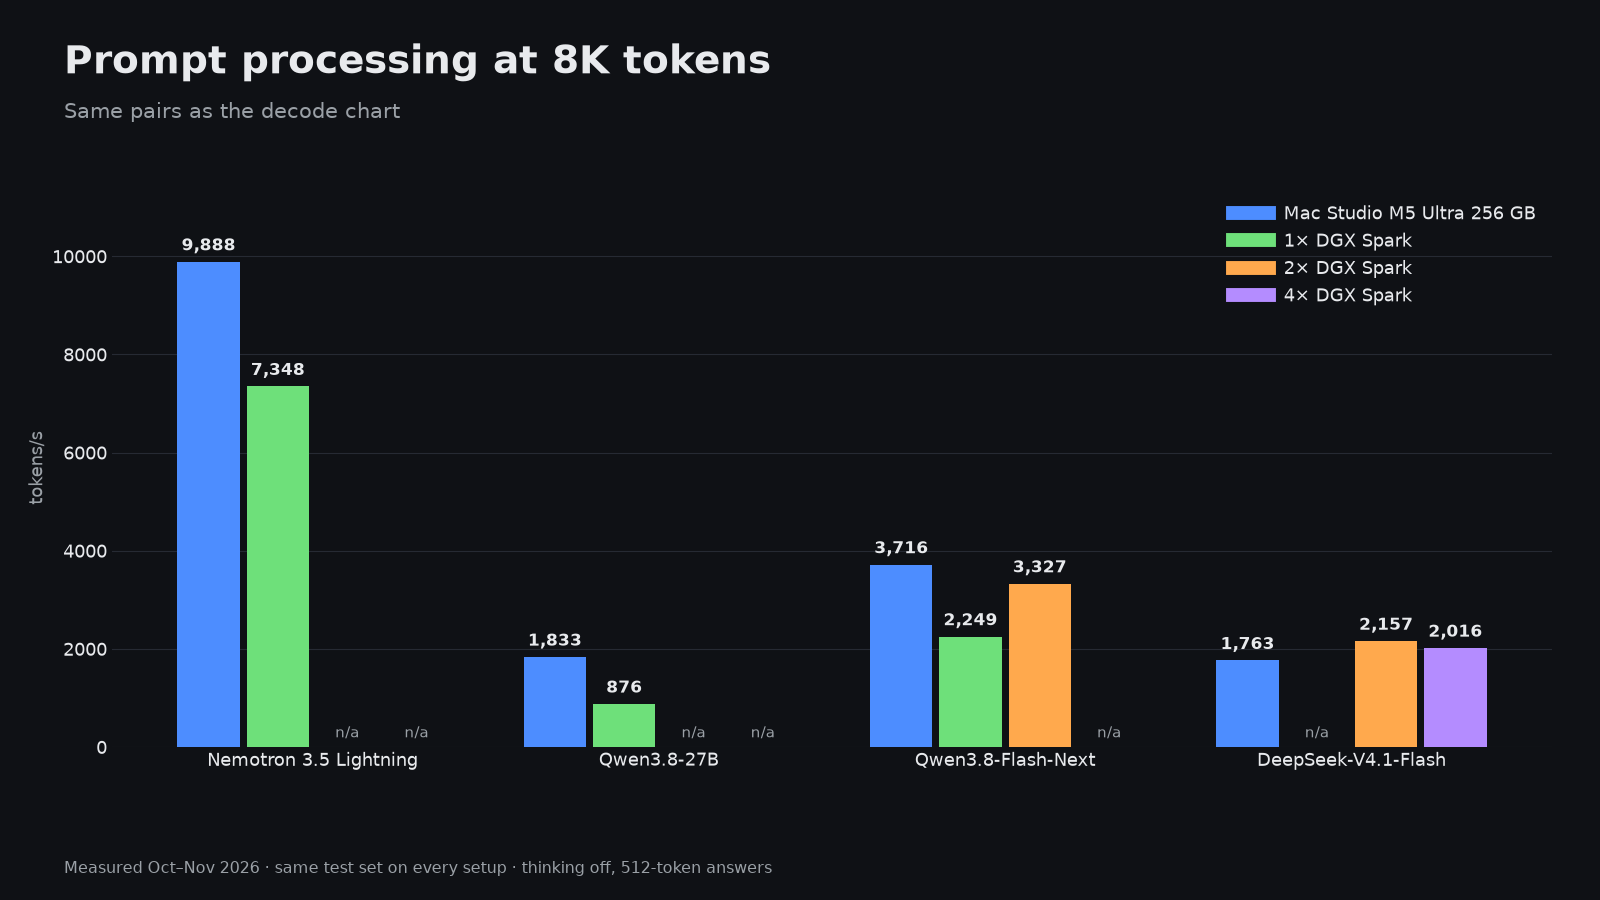
Prefill ist schneller als Decode. Bei Nemotron Lightning liest der Mac einen 8K-Prompt mit 9.888 Tok/s ein und einen Spark mit 7.348 Tok/s. Bei dem dichten Modell Qwen3.8-27B sind es 1.833 gegenüber 876 Tok/s. Bei DeepSeek-V4.1-Flash hat der Spark-Varianten Vorteil: 2.157 Tok/s bei zwei Geräten und 2.016 Tok/s bei vier Geräten, im Vergleich zu 1.763 Tok/s beim Mac. Der erste Token für einen 32K-Prompt dauert bei DeepSeek auf dem Mac 18,3 Sekunden, bei zwei Spark-Geräten 17,9 Sekunden und bei vier Spark-Geräten 15,8 Sekunden.
Parallelanfragen
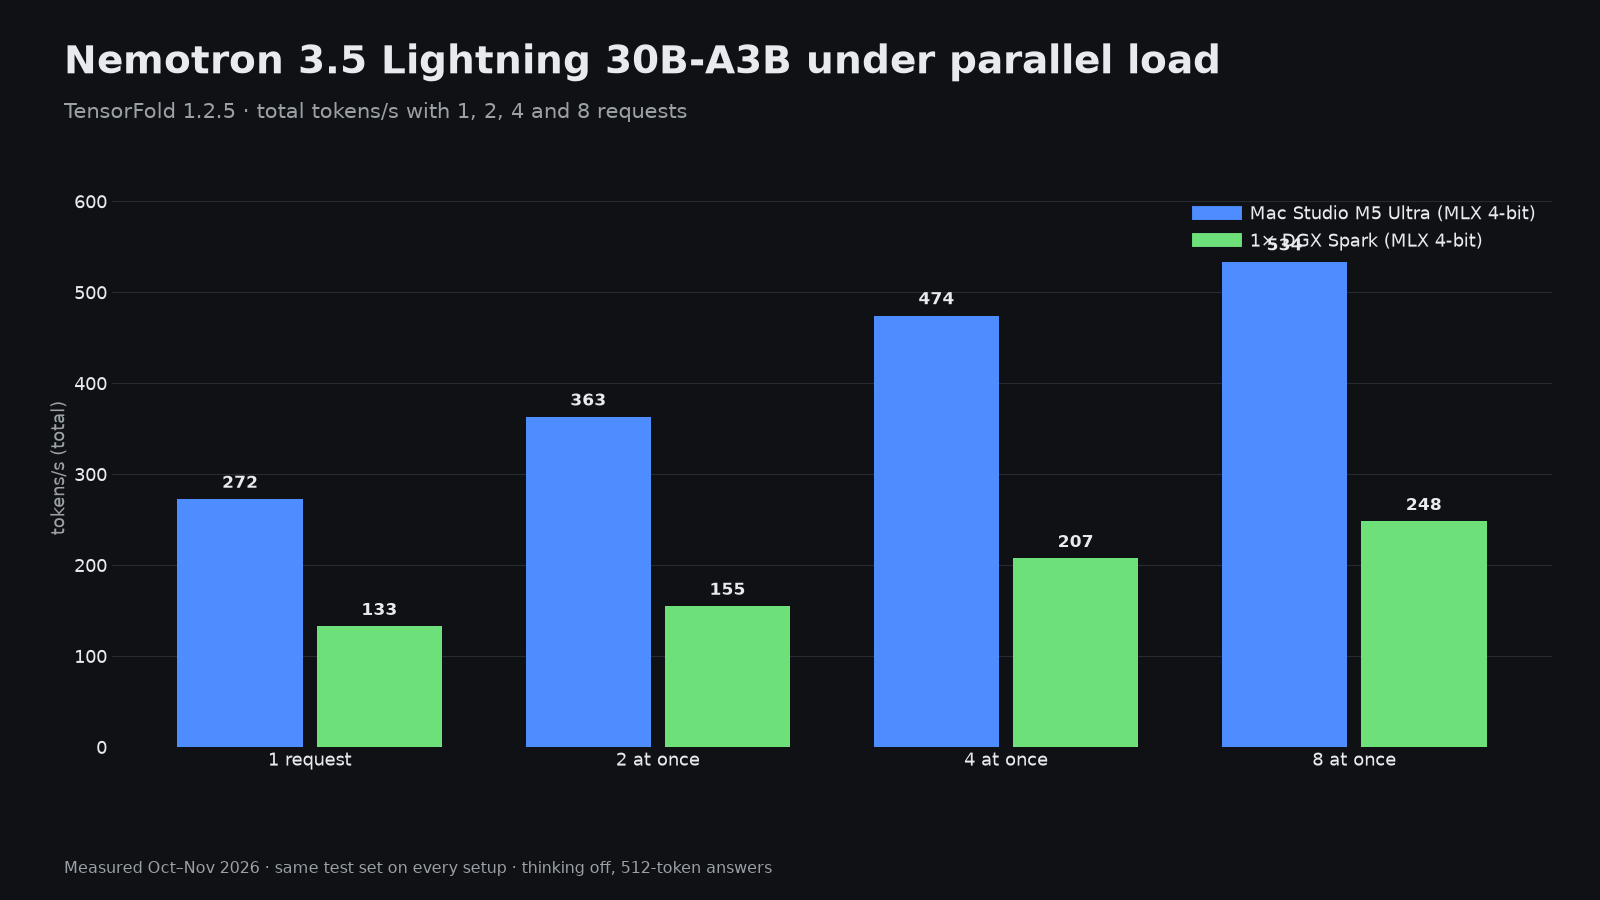
Sowohl die Maschinen arbeiten gut im Batch-Modus mit dem MoE-Modell. Bei acht parallelen Anfragen erzielt der Mac insgesamt 533,5 Tok/s, während ein Spark 248,0 Tok/s liefert. Bei DeepSeek erreichen vier Sparks bei acht Anfragen insgesamt 141,2 Tok/s, der Mac hingegen 84,5 Tok/s.
Bilder und Video
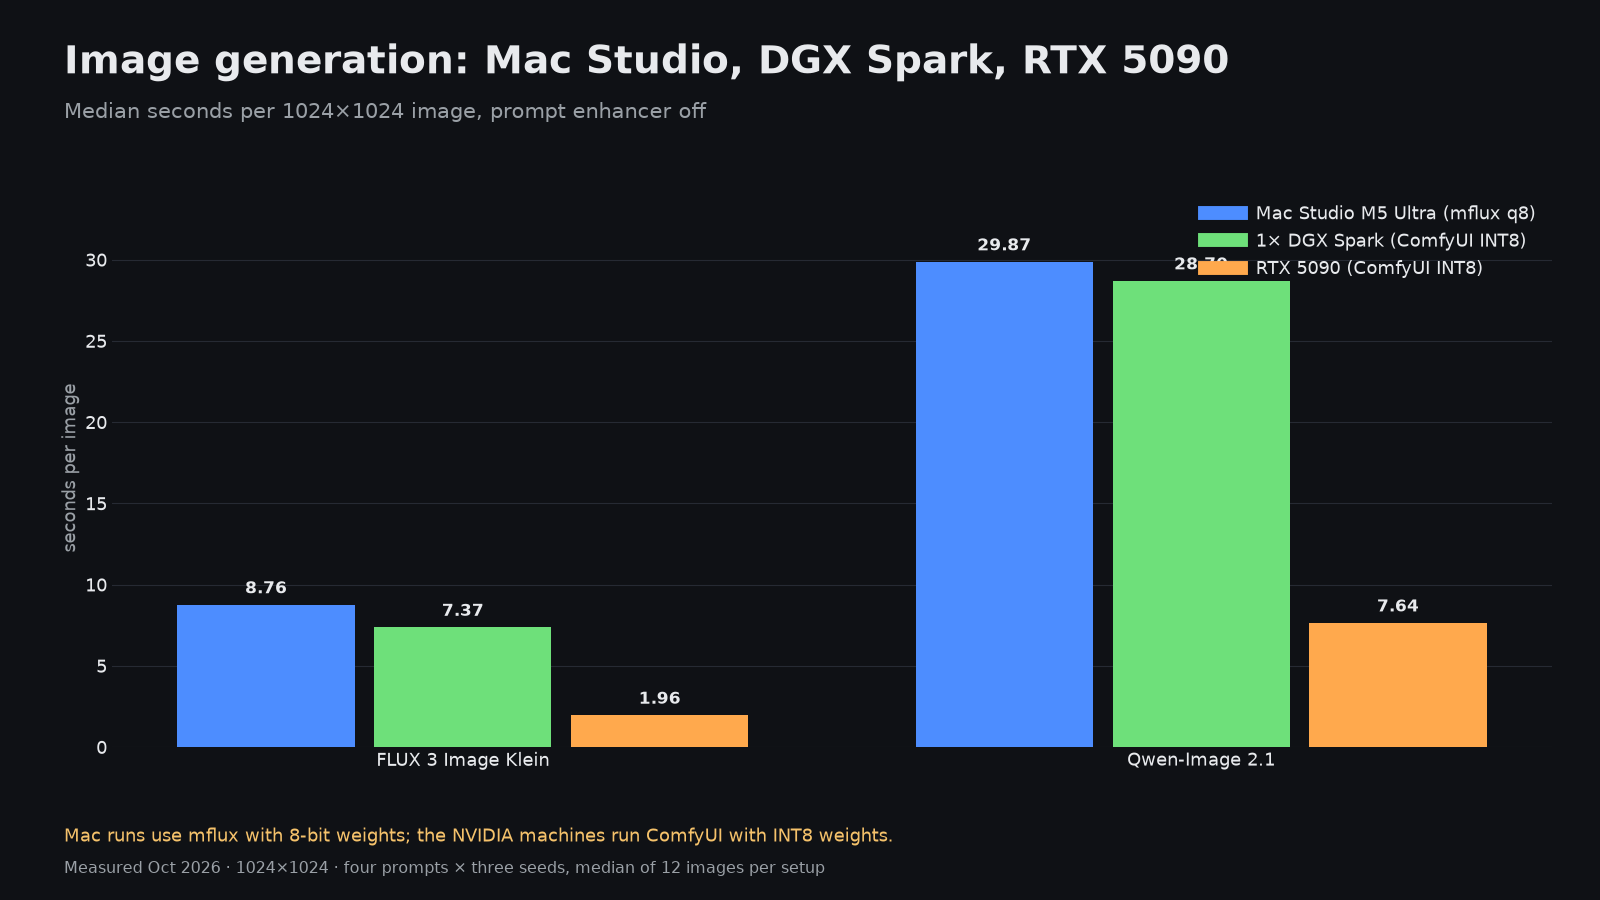
Bei Diffusionsmodellen ist keines der Geräte besonders schnell. FLUX Klein benötigt 8,76 Sekunden pro Bild auf dem Mac und 7,37 Sekunden auf einem Spark; Qwen-Image 2,1 braucht 29,87 Sekunden bzw. 28,7 Sekunden. Eine RTX 5090 bearbeitet dieselben Bilder in 1,96 Sekunden bzw. 7,64 Sekunden. Die 128 GB des Spark ermöglichen es, sehr große Videoprojekte auszuführen: Das Neuzeichnen eines 5-sekündigen Entwurfs in 2560×1440 mit Open-H3-Regenerate dauert bei einem maximalen Speicherverbrauch von 78,9 GiB etwa 22 Minuten pro Clip – das ist weitaus mehr, als eine Karte mit 32 GB aufnehmen kann.
Welches Gerät wofür?
- Für eine Person, die das schnellste Einzelgerät möchte: der Mac Studio M5 Ultra. Er ist zwei bis dreieinhalb Mal schneller als ein Spark bei denselben Modellen und kann DeepSeek-V4,1-Flash allein mit 74,2 tok/s ausführen.
- Für den Aufbau eines Clusters im Laufe der Zeit: der Spark. Zwei Geräte können DeepSeek-V4,1-Flash mit der Geschwindigkeit eines Macs ausführen, während vier Geräte es mit einer höheren Quantisierung schaffen.
- Allein für CUDA konzipierte Tools, NVFP4-Checkpointe sowie vLLM- oder SGLang-Rezepte: Ein Spark, da die gewünschte Software bereits darauf ausgelegt ist.
- Bilder und kurze Videos: Keines davon. Stellen Sie eine RTX 5090 neben das Gerät, das Sie wählen.
- Sehr große Videos sowie memoryintensive Diffusionsaufgaben: Ein Spark, aufgrund der 128 GB an von der GPU adressierbarem Speicher.