Mac Studio M5 Ultra против DGX Spark: скорость работы локальных нейросетей с одинаковыми моделями.
Mac Studio M5 Ultra 256 ГБ против одного, двух и четырех модулей DGX Spark на платформах Nemotron, Qwen3.8 и DeepSeek-V4.1-Flash: декодирование, предзаполнение данных, группировка операций и обработка изображений.
Если модель не помещается в игровую GPU, следующими устройствами, на которые обычно обращают внимание, являются Mac Studio M5 Ultra и DGX Spark от NVIDIA. Оба используют объединенную память, оба предназначены для работы на столе и продаются как устройства для работы с ИИ. Однако их производительность сильно различается при тестировании на одних и тех же моделях.
Устройство от Apple — это Mac Studio M5 Ultra с 256 ГБ объединенной памяти. Устройства от NVIDIA — это модели с 1, 2 или 4 ГБ памяти каждая, общий объем которых составляет 128 ГБ; они соединены с помощью кабелей ConnectX-7 для реализации тензорного параллелизма. Помимо собственного устройства от NVIDIA, для работы с несколькими устройствами используются модели ASUS Ascent GX10, Gigabyte AI TOP ATOM и Lenovo ThinkStation PGX, основанные на том же чипе. Во всех тестах применяются одинаковые параметры: ответы длиной 512 токенов, этап разогрева, вычисление медиан и время на обработку запроса.
Одна и та же модель, оба устройства
| Модель | Mac Studio M5 Ultra | 1× DGX Spark | 2× DGX Spark | 4× DGX Spark |
|---|---|---|---|---|
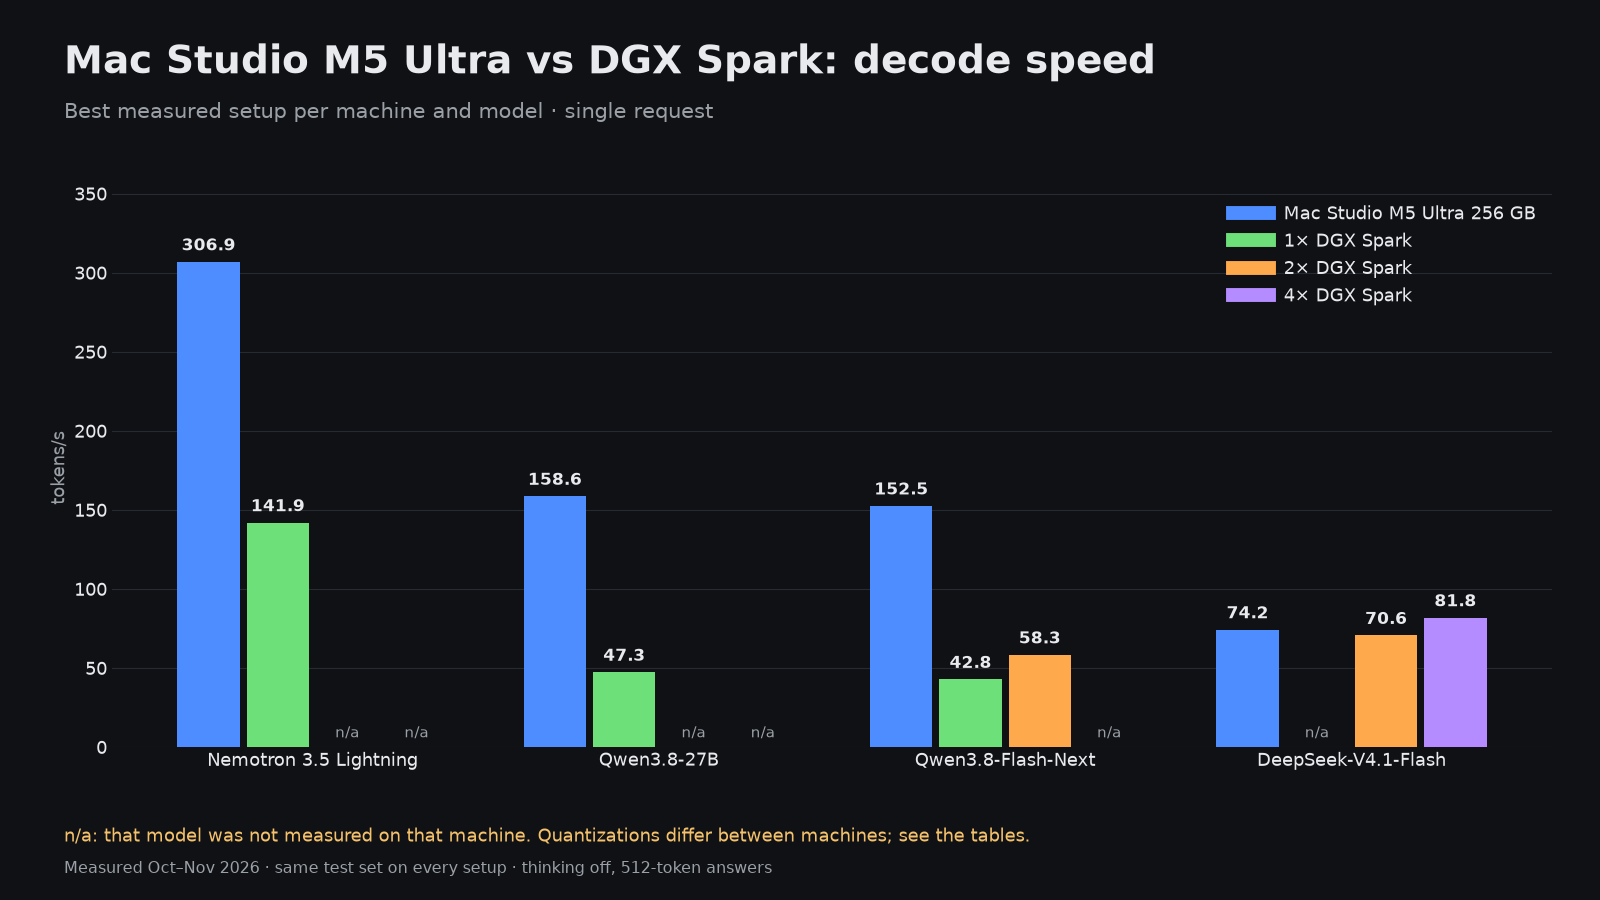
| Nemotron 3.5 Lightning 30B-A3B, MLX 4-bit, TensorFold 1.2.5 | 306,9 tok/с | 141,9 tok/с | н/д | н/д |
| Qwen3.8-27B с DFlash2, TensorFold | 158,6 tok/с (MLX 4-bit) | 47,3 tok/с (EXL3 4.0 bpw) | н/д | н/д |
Nemotron 3.5 Lightning является наиболее справедливым объектом сравнения: используется та же версия TensorFold 1.2.5, те же 4-битные веса MLX и те же черновики MTP. Мак-компьютер декодирует с скоростью 306,9 ток/с, один из Spark — 141,9 ток/с. Качество на обоих устройствах одинаковое (51,4 % против 51,9 %), что соответствует ожидаемому при использовании идентичных весов. У Spark в этих тестах частота GPU ограничена до 2200 МГц.
На мощной модели Qwen3.8-27B разница ещё больше: 158,6 ток/с на Mac против 47,3 на одном Spark. Ширина памятной полосы определяет скорость декодирования, и у устройства M5 Ultra она во много раз выше, чем у одного GB10. Модель Qwen3.8-Flash-Next показывает аналогичную картину — даже два Spark в режиме тензорного параллелизма (58,3 ток/с) значительно уступают одному Mac (152,5 ток/с).
DeepSeek-V4.1-Flash — сценарий, когда кластер Spark догоняет
Большая модель с технологией MoE меняет ситуацию. На Mac движок Metal от TensorFold обрабатывает данные с использованием формата 2/3-бит при скорости 74,2 ток/с, при этом потребляется 206,3 ГиБ из 256 ГБ памяти. Два Spark с форматом EXL3 и плотностью кодирования 2,5 бит/позиция достигают скорости 70,6 ток/с, а четыре Spark с плотностью 4,0 бит/позиция — 81,8 ток/с; это единственная конфигурация, которая превосходит Mac при использовании более высокой степени квантования.
Качество работы у всех устройств примерно одинаково: 67,4 % на Mac, 66,1 % на двух устройствах Sparks и 66,6 % на четырех. На Mac также запускаются другие версии DeepSeek: двигатель ds4 с квантованием Q2 показывает результат 69,7 % при скорости обработки 54,5 токенов в секунду, а oMLX с квантованием LSQ3 — 60,0 % при скорости 63,8 токенов в секунду с использованием 225,6 ГБ памяти.
Обработка промптов
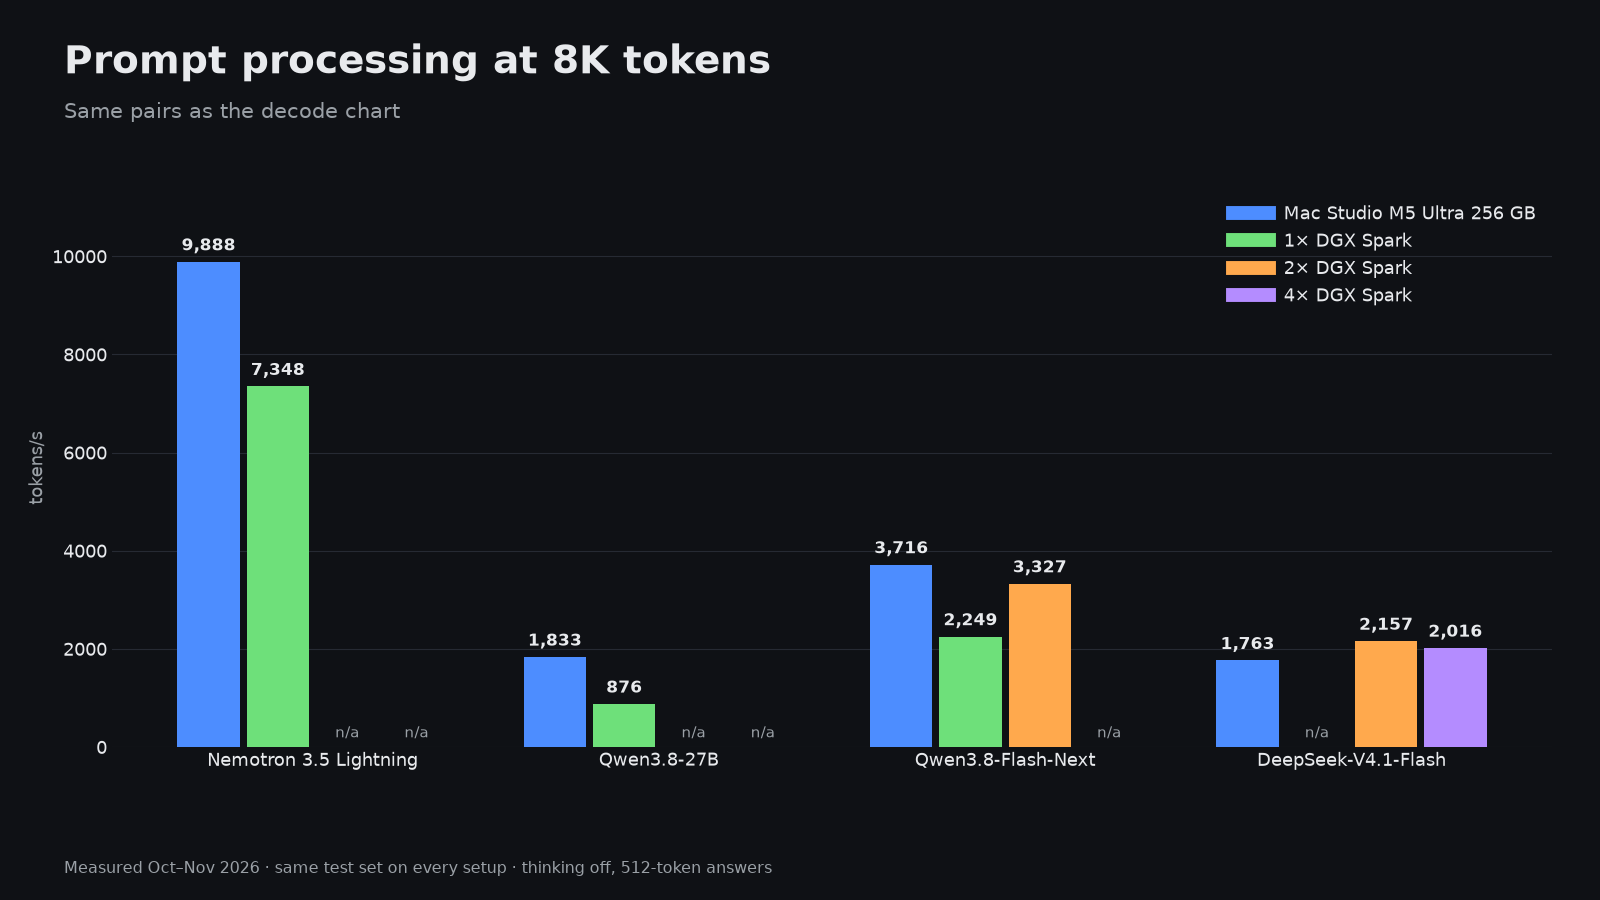
Процесс заполнения предварительных данных происходит быстрее, чем декодирование. На устройстве Nemotron Lightning Mac обрабатывает промпт размером 8K со скоростью 9,888 токенов/с, а промпт типа Spark — со скоростью 7,348 токенов/с. На модели Qwen3.8-27B с высокой плотностью параметров показатели составляют 1,833 против 876 токенов/с. На модели DeepSeek-V4.1-Flash преимущество остается за моделью Spark: соответственно 2,157 токенов/с на двух устройствах и 2,016 токенов/с на четырех устройствах против 1,763 токенов/с у Mac. Время обработки первого токена промпта размером 32K на Mac составляет 18,3 секунды, на двух устройствах типа Spark — 17,9 секунды, а на четырех устройствах — 15,8 секунды.
Параллельные запросы
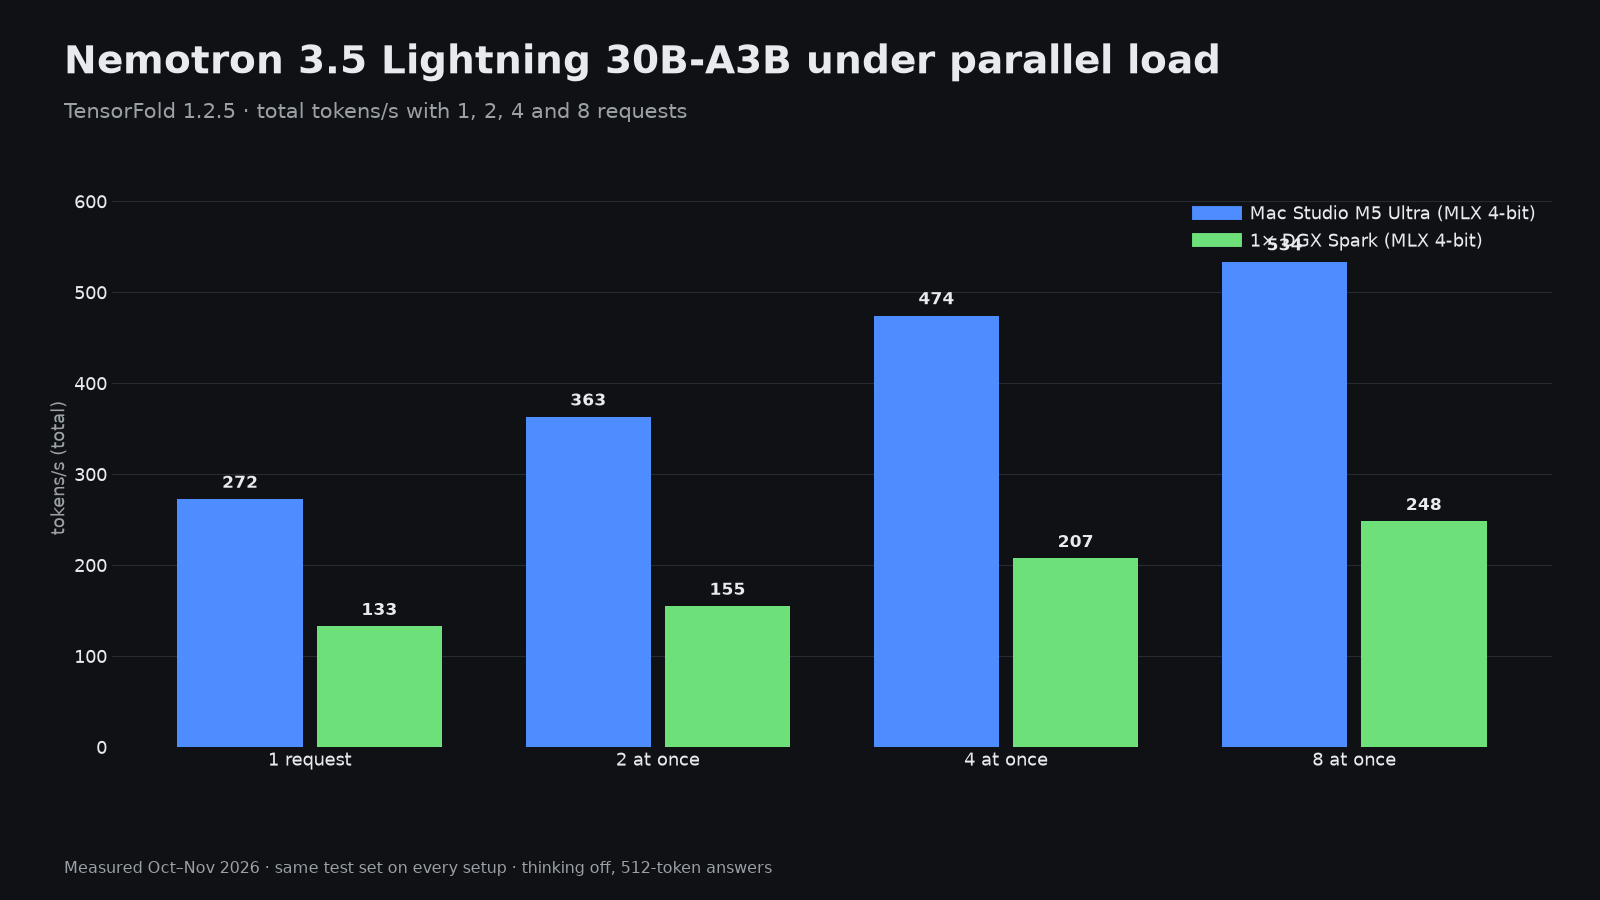
Оба устройства хорошо справляются с обработкой заданий пакетно в режиме MoE. При восьми параллельных запросах Mac обеспечивает скорость 533,5 токов/с в сумме, а Spark — 248,0 токов/с. В режиме DeepSeek четыре устройства Spark достигают скорости 141,2 токов/с при восьми запросах, тогда как у Mac — 84,5 токов/с.
Изображения и видео
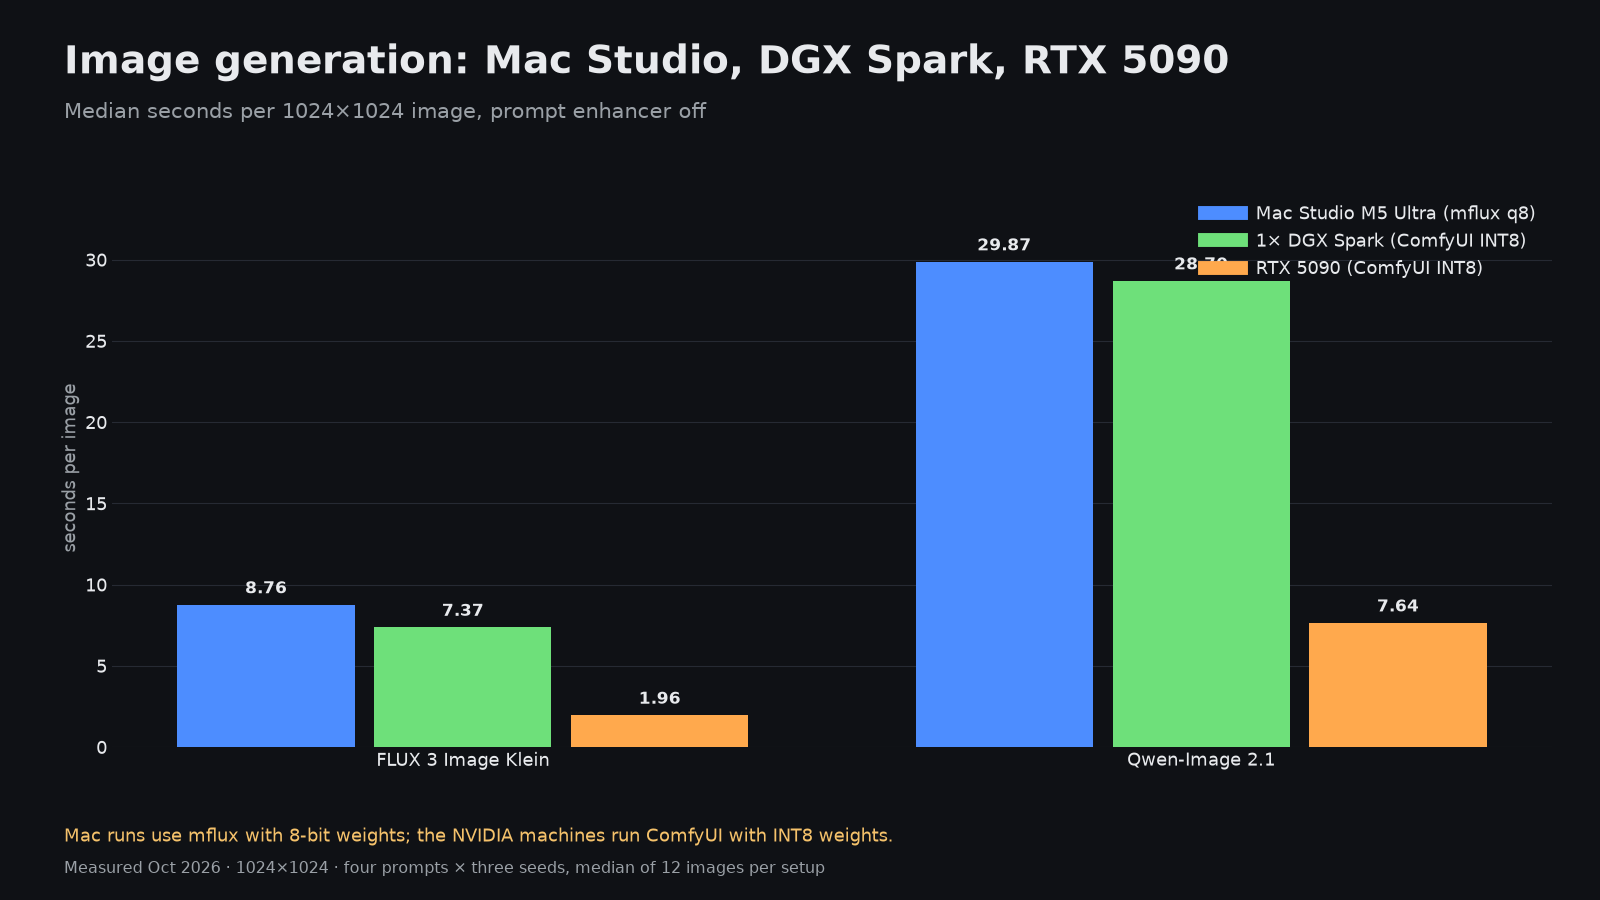
Для моделей диффузии ни один из этих компьютеров не является быстрым. FLUX Klein занимает 8,76 секунды на обработку одного изображения на Mac и 7,37 секунды на Spark; Qwen-Image 2.1 — 29,87 секунды и 28,7 секунды. RTX 5090 обрабатывает те же изображения за 1,96 секунды и 7,64 секунды. 128 ГБ памяти у Spark позволяют выполнять очень большие видеозадачи: перерисовка 5-секундного черновика в разрешении 2560×1440 с использованием Open-H3-Regenerate занимает примерно 22 минуты на кадр при пиковой нагрузке памяти в 78,9 ГиБ, что значительно превышает объем памяти у карты на 32 ГБ.
Какой выбрать и для чего
- Для человека, который хочет самый быстрый устройство: Mac Studio M5 Ultra. Он в два–три с половиной раза быстрее Spark при обработке тех же моделей и может самостоятельно выполнять DeepSeek-V4.1-Flash со скоростью 74,2 токена в секунду.
- Для построения кластера со временем: Spark. Два устройства могут обрабатывать DeepSeek-V4.1-Flash с такой же скоростью, как Mac, а четыре устройства — с более высоким уровнем квантования.
- Инструменты, работающие только с CUDA, чекпоинты NVFP4 и рецепты vLLM или SGLang: Spark, поскольку нужное вам программное обеспечение уже поддерживает его.
- Изображения и короткие видео: ни то, ни другое. Рядом с выбранным устройством поставьте RTX 5090.
- Очень большие видеофайлы и задачи диффузии, требующие большого объема памяти: Spark, благодаря 128 ГБ памяти GPU.