Mac Studio M5 Ultra kontra DGX Spark: szybkość lokalnego działania modeli językowych na tych samych modelach.
Mac Studio M5 Ultra 256 GB kontra jedna, dwie i cztery jednostki DGX Spark na platformach Nemotron, Qwen3.8 oraz DeepSeek-V4.1-Flash: dekodowanie, wypełnianie danych z góry, grupowanie zadań oraz przetwarzanie obrazów.
Jeśli model nie mieści się na karcie graficznej do gier, dwa urządzenia, na które najczęściej patrzą ludzie, to Mac Studio M5 Ultra oraz DGX Spark od NVIDIA. Obie używają pamięci zintegrowanej, obie stoją na biurku i obie są sprzedawane jako lokalne urządzenia do AI. Ich zachowanie znacznie się różni, gdy porównuje się je przy użyciu tych samych modeli.
W tym przypadku Mac to Mac Studio M5 Ultra z 256 GB pamięci zintegrowanej. Z kolei w przypadku Spark mowa o urządzeniach o pojemności 1, 2 lub 4 GB10, z których każde ma 128 GB pamięci, połączonych za pomocą kabli ConnectX-7 dla osiągnięcia paralelizmu tensorowego; oprócz własnego urządzenia od NVIDIA, te wielourządzeniowe systemy wykorzystują również maszyny ASUS Ascent GX10, Gigabyte AI TOP ATOM oraz Lenovo ThinkStation PGX, zbudowane na tym samym chipie. Każdy test wykorzystuje ten sam zestaw parametrów: odpowiedzi składające się z 512 tokenów, fazę rozgrzewki, obliczanie median oraz czas na przetwarzanie.
Ten sam model, oba urządzenia
| Model | Mac Studio M5 Ultra | 1× DGX Spark | 2× DGX Spark | 4× DGX Spark |
|---|---|---|---|---|
| Nemotron 3.5 Lightning 30B-A3B, MLX 4-bit, TensorFold 1.2.5 | 306,9 tok/s | 141,9 tok/s | n/d | n/d |
| Qwen3.8-27B z DFlash2, TensorFold | 158,6 tok/s (MLX 4-bit) | 47,3 tok/s (EXL3 4,0 bpw) | n/d | n/d |
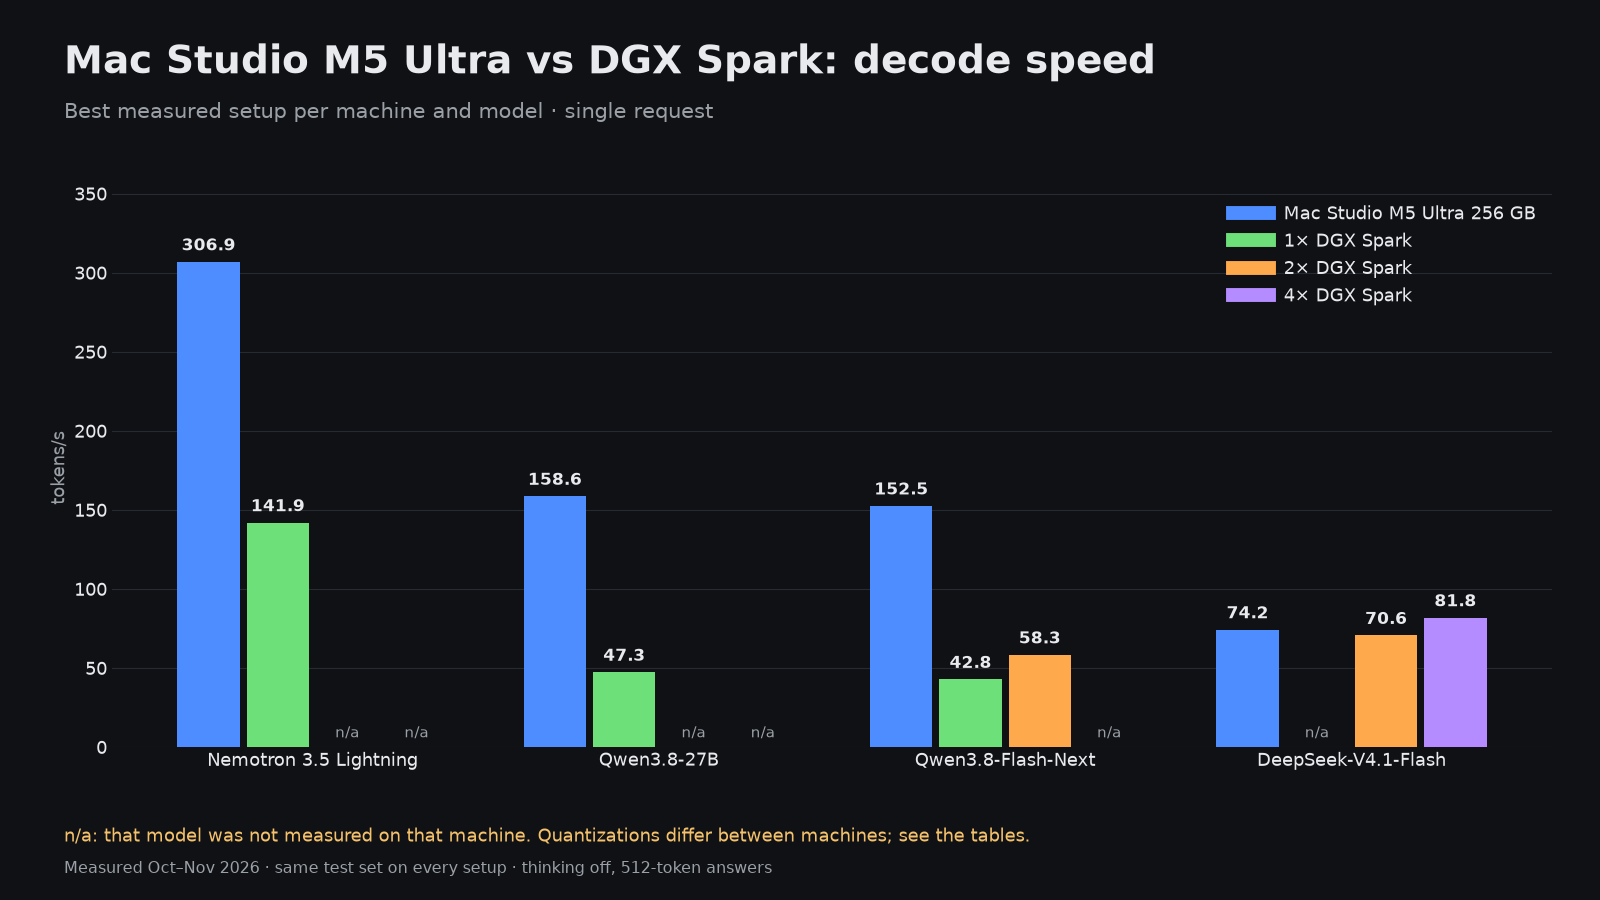
Nemotron 3.5 Lightning stanowi najbardziej sprawiedliwe porównanie: ta sama wersja TensorFold 1.2.5, te same wagi MLX 4-bit, te same wersje MTP. Mac dekoduje z prędkością 306,9 tok/s, jeden Spark z prędkością 141,9. Jakość jest taka sama w obu przypadkach (51,4 % vs 51,9 %), co jest spodziewane przy identycznych wagach. Spark w tych testach ma ograniczoną częstotliwość taktowania GPU do 2200 MHz.
Na urządzeniu o dużej mocy Qwen3.8-27B różnica jest jeszcze większa: 158,6 tok/s na Macu w porównaniu z 47,3 tok/s na jednym Sparku. Szerokość paska pamięci decyduje o szybkości dekodowania, a model M5 Ultra ma znacznie większą szerokość paska pamięci niż pojedynczy model GB10. Qwen3.8-Flash-Next pokazuje ten sam wzorzec – nawet dwa Sparki pracujące w trybie równoległym (58,3 tok/s) znacznie ustępują jednemu Macowi (152,5 tok/s).
DeepSeek-V4.1-Flash to moment, w którym klastr Spark nadrobi straty
Wielki model typu MoE zmienia obraz sytuacji. Na Macu silnik Metal od TensorFold obsługuje wersję modelu o rozdzielczości 2/3 bita z prędkością 74,2 tok/s, zużywając przy tym 206,3 GiB z dostępnych 256 GB. Dwa Sparki z wersją modelu EXL3 o rozdzielczości 2,5 bpw osiągają prędkość 70,6 tok/s, natomiast cztery Sparki z wersją o rozdzielczości 4,0 bpw osiągają prędkość 81,8 tok/s – to jedyne rozwiązanie, które w tym modelu przewyższa Maca, przy jednoczesnym użyciu większej stopnia kwantyzacji.
Jakość jest podobna we wszystkich przypadkach: 67,4 % na Macu, 66,1 % na dwóch urządzeniach Sparks, 66,6 % na czterech. Mac obsługuje również inne wersje DeepSeek: silnik ds4 z kwantyzacją Q2 osiąga 69,7 % przy prędkości 54,5 toków/s, natomiast oMLX z LSQ3 osiąga 60,0 % przy prędkości 63,8 toków/s, zużywając 225,6 GiB pamięci.
Przetwarzanie promptów
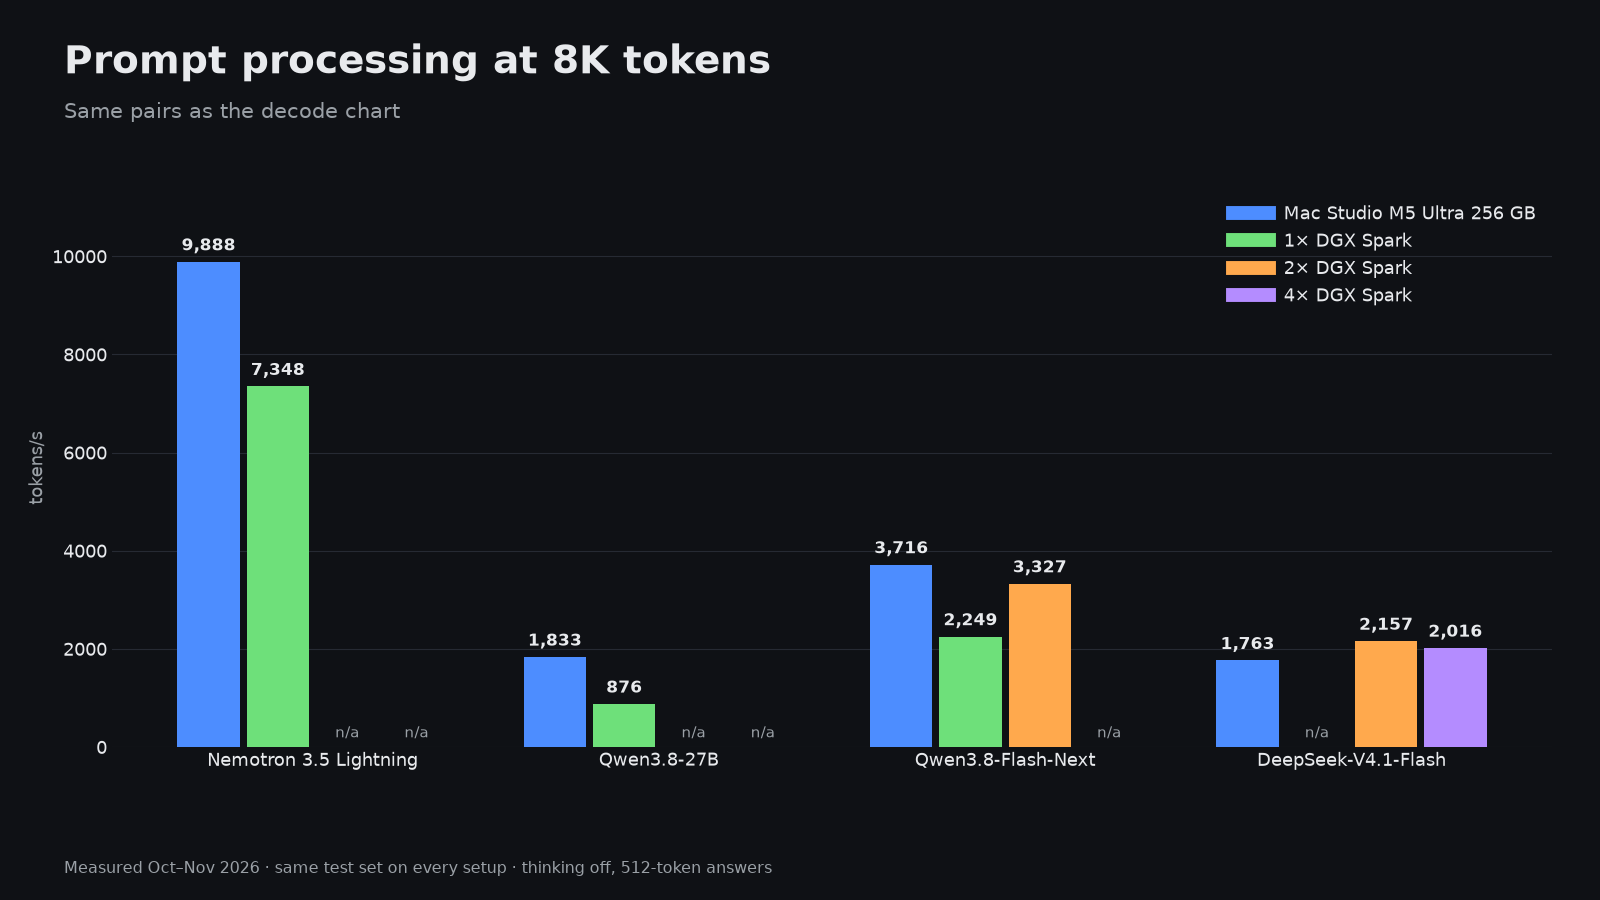
Proces wczytywania danych jest szybszy niż dekodowanie. W przypadku Nemotron Lightning Mac przetwarza prompt o rozdzielczości 8K z prędkością 9,888 toków/s, a jeden model Spark – 7,348 toków/s. W przypadku gęstego modelu Qwen3.8-27B te wartości wynoszą odpowiednio 1,833 i 876 toków/s. W modelu DeepSeek-V4.1-Flash przewaga jest po stronie modelu Spark: 2,157 toków/s przy użyciu dwóch modeli i 2,016 toków/s przy użyciu czterech, w porównaniu z 1,763 toków/s u Maca. Pierwszy token w promptzie o rozdzielczości 32K w modelu DeepSeek jest przetwarzany w 18,3 s na Macu, 17,9 s przy użyciu dwóch modeli Spark i 15,8 s przy użyciu czterech.
Zapytania równoległe
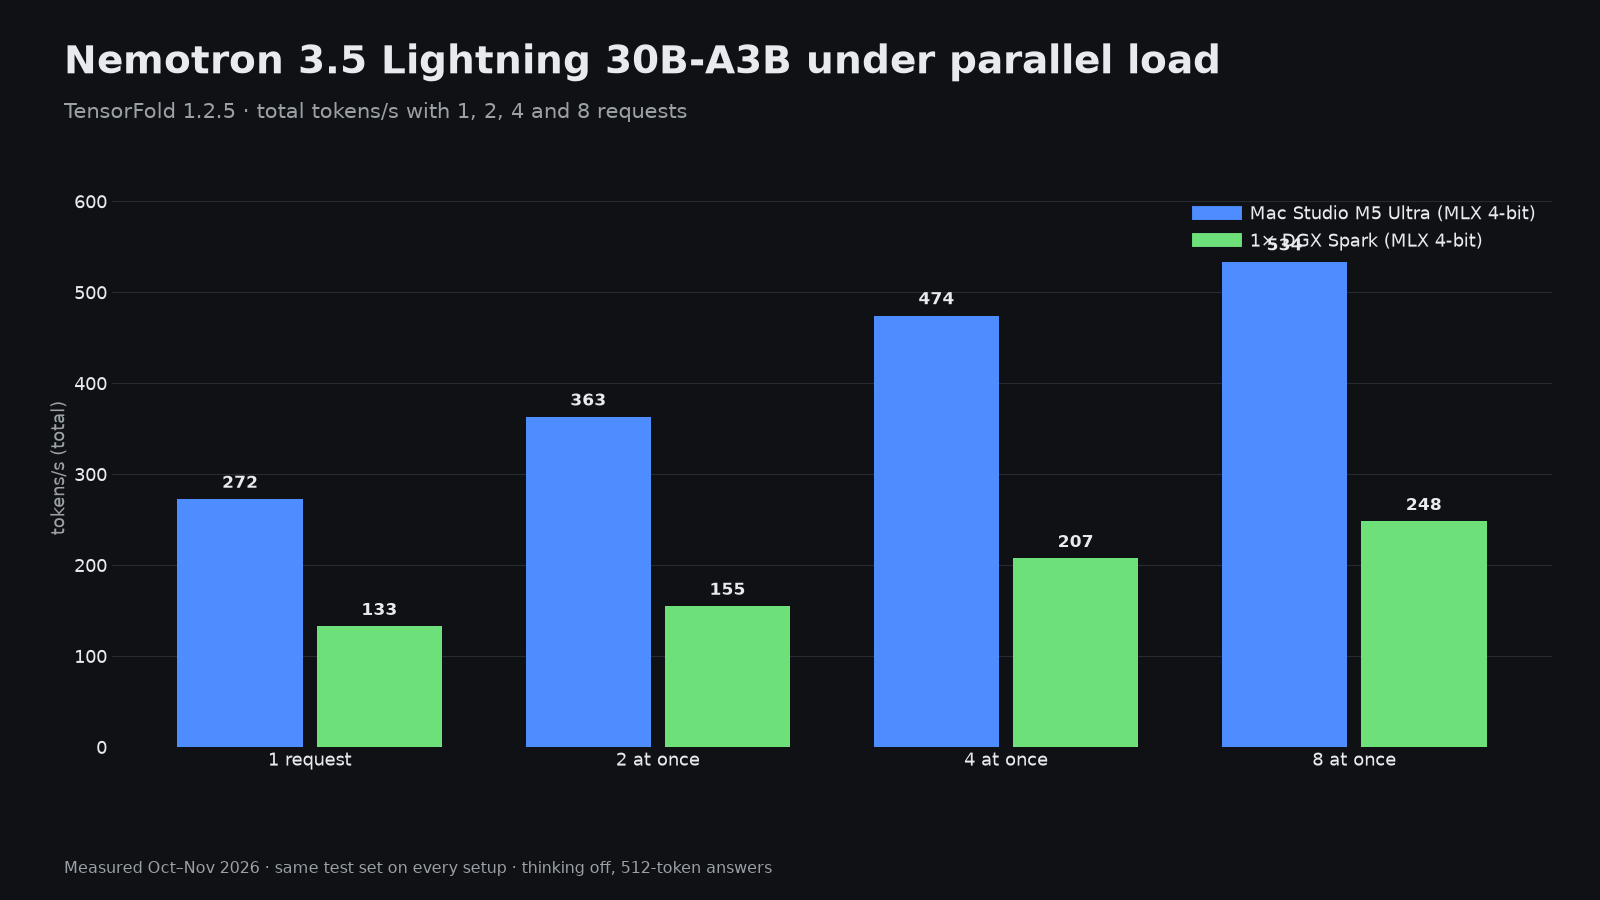
Oba urządzenia dobrze radzą sobie z przetwarzaniem zespołowym w modelu MoE. Przy ośmiu równoległych zapytaniach Mac osiąga łącznie 533,5 tok/s, natomiast Spark – 248,0 tok/s. W przypadku DeepSeek cztery jednostki Spark dają łącznie 141,2 tok/s przy ośmiu zapytaniach, podczas gdy Mac osiąga 84,5 tok/s.
Zdjęcia i wideo
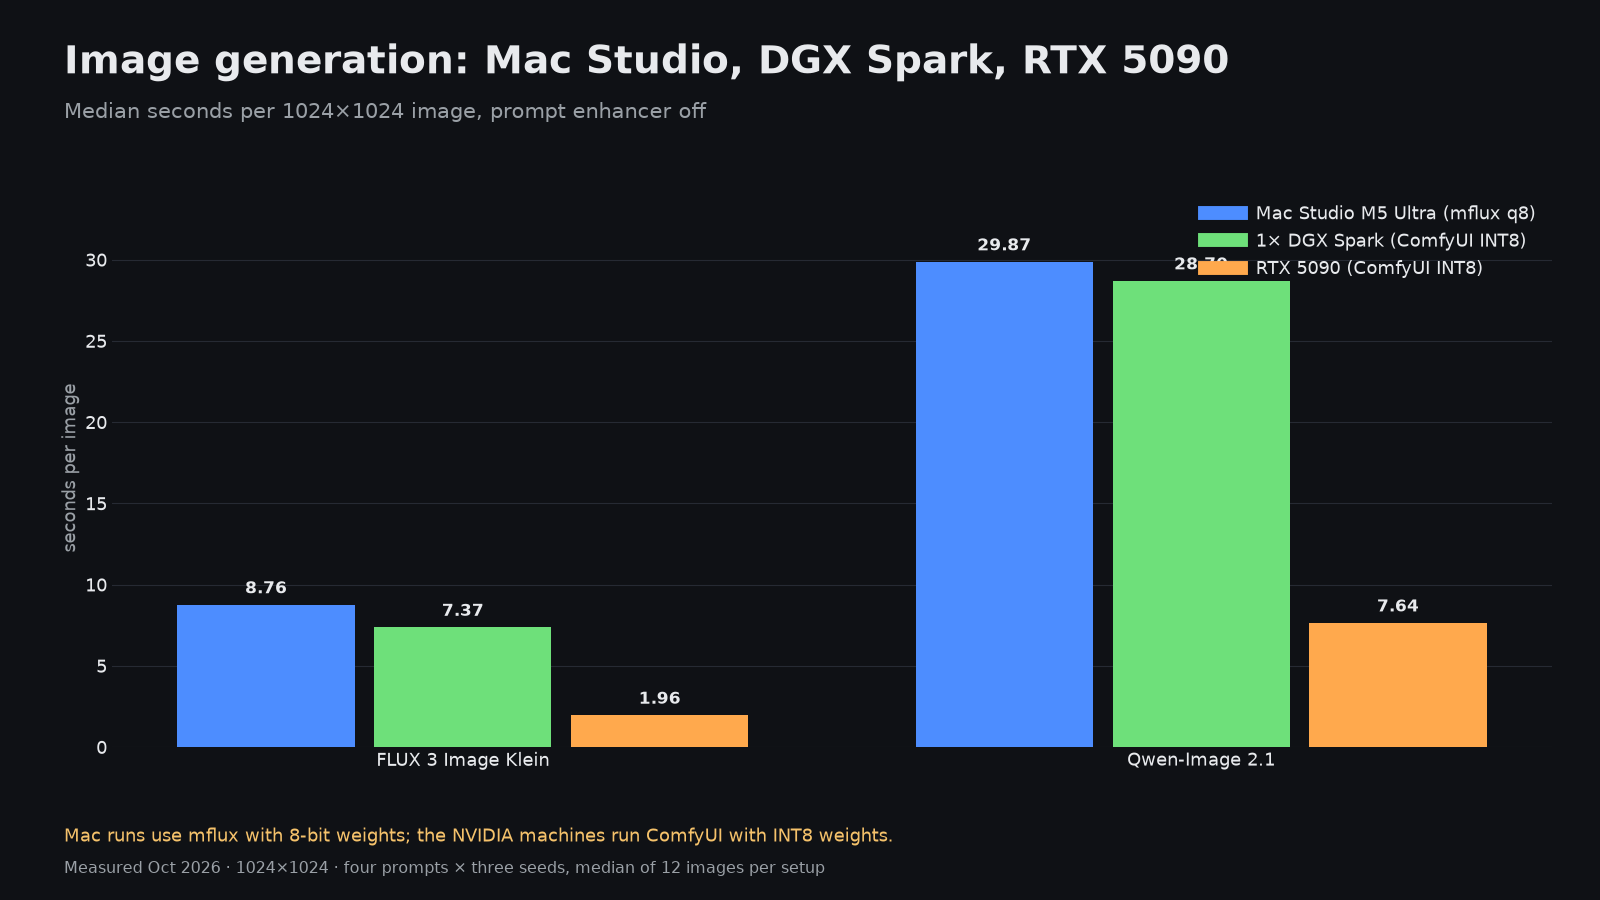
W przypadku modeli dyfuzyjnych żaden z tych komputerów nie jest szybki. FLUX Klein potrzebuje 8,76 s na obrazek na Macu i 7,37 s na Sparku; Qwen-Image 2,1 potrzebuje odpowiednio 29,87 s i 28,7 s. RTX 5090 przetwarza te same obrazy w czasie 1,96 s i 7,64 s. 128 GB pamięci w Sparku umożliwia przetwarzanie bardzo dużych plików wideo: ponowne narysowanie 5-sekundowego projektu w rozdzielczości 2560×1440 za pomocą Open-H3-Regenerate zajmuje około 22 minut na klip, przy maksymalnym zużyciu pamięci wynoszącym 78,9 GiB, co jest znacznie więcej, niż może pomieścić karta o pojemności 32 GB.
Który do czego
- Dla osoby szukającej najszybszego komputera: Mac Studio M5 Ultra. Jest od dwóch do trzech i pół raza szybszy od Sparka przy tych samych modelach i potrafi samodzielnie obsługiwać DeepSeek-V4,1-Flash z prędkością 74,2 tok/s.
- Dla tworzenia klastra z czasem: Spark. Dwa komputery mogą obsługiwać DeepSeek-V4,1-Flash z prędkością Maca, natomiast cztery komputery mogą to robić przy większym stopniu kwantyzacji.
- Narzędzia dostępne wyłącznie dla CUDA, punkty kontrolne NVFP4 oraz rozwiązania vLLM lub SGLang: Spark, ponieważ oprogramowanie, którego szukasz, już jest do niego przystosowane.
- Zdjęcia i krótkie filmy wideo: żadne z nich. Umieść RTX 5090 obok tego, co wybierzesz.
- Bardzo duże filmy wideo oraz zadania difuzji wymagające dużej ilości pamięci: Spark, dzięki 128 GB pamięci dostępnej przez GPU.