Критэрыі працёздатнасці локальных LLM на RTX 5090: той самы Qwen3.8-27B, 67–253 токені за секунду.
Qwen3.8-27B на адаптары RTX 5090 за дапамогай TensorFold, NInfer, ExLlamaV3, Qwentin і vLLM: декодаванне, падготавка дадзейна, паралельная працёздатнасць, якасць і выбір тэхнологій для запуску.
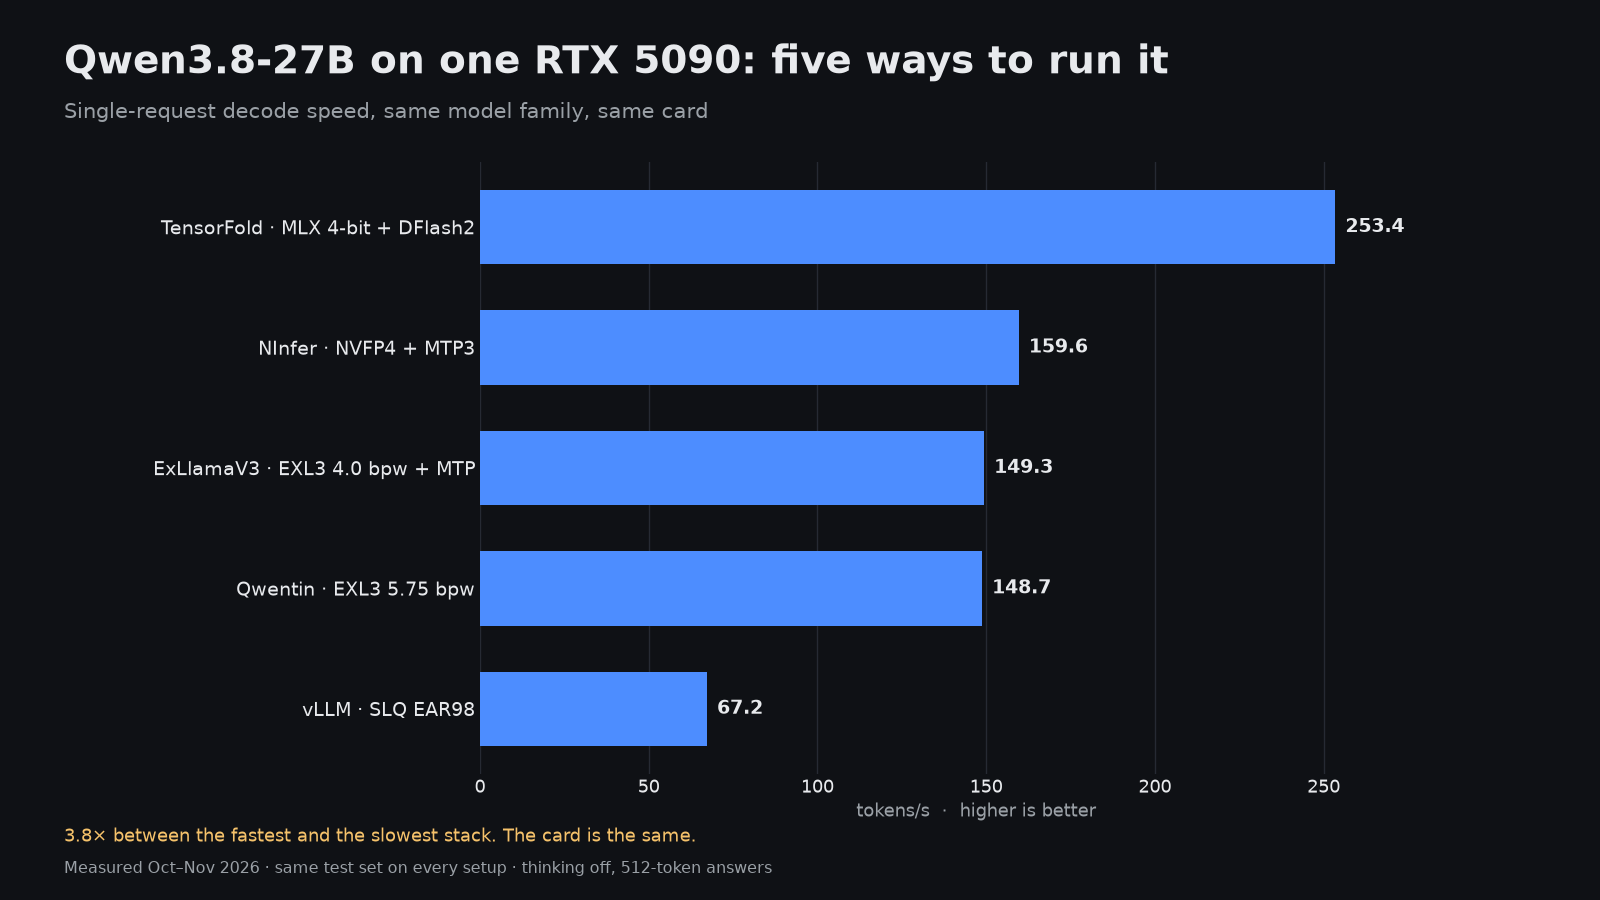
Якщо запустыць той самы Qwen3.8-27B на тым жа RTX 5090, можна параджыць значэнняя з 67,2 да 253,4 токенаў за секунду. Разлік стоіць у самым двігуне, квантызацыі і методе спекулятивнага декодавання. Пяць цэлых наладакоў, паказаных нижэй, было вымерана з аднаковым прыладам і наборам кантролі якасці, таму параджанне адбываецца між програмным стаком, а не апаратнай часткаю.
Карта — это адзін RTX 5090 на 32 ГБ. Декодаванне вырахоўваецца як медыяннае значэнне адпаведных адпаведзей на запыткі з 512 токанамі як у кодаваным, так і у прозаічным формате; час заполнення памяці і час першага токана вымераны для 2K, 8K і 32K токанаў; паралельная праўоцэснасць — цэ это загальная колькасць токанаў за секунду па 1, 2, 4 і 8 адночасных запытках.
Пяць стакоў для аднаго модэлю
| Працоўнік | Квантаванне | Дэкодаванне, ток/с | Код / проза | Праўянне 8K, ток/с | Першы ток пры 32K | Серэдня якосць | Максымальны контэкст | Максымальная колькасць VRAM |
|---|---|---|---|---|---|---|---|---|
| TensorFold + DFlash2 | MLX 4-біт | 253.4 | 268.2 / 238.7 | 5,033 | 7.7 с | 62.9 % | 256K | 27.3 ГіБ |
| NInfer + MTP3 | NVFP4 | 159.6 | 169.0 / 150.1 | 10,628 | 3.6 с | 65.3 % | 240,000 | 28.9 ГіБ |
| ExLlamaV3 + MTP | EXL3 4.0 bpw | 149.3 | 154.5 / 144.2 | 3,484 | 10.5 с | 67.6 % | 128K | 18.9 ГіБ |
| Qwentin + MTP | EXL3 5.75 bpw | 148.7 | 158.3 / 139.2 | 2,569 | 13.7 с | 67.9 % | 128K | 29.7 ГіБ |
| vLLM, без спекуляцый | SLQ EAR98 | 67.2 | 67.2 / 67.1 | 3,803 | 9.5 с | 64.3 % | 74,752 | 29.5 ГіБ |
Спекулятивная дэкодаванне адказвае за большую частку разліку
vLLM запускае гэты модель без спекуляцый і досягае 67,2 tok/s, пры чым код і проза — 0,1 tok/s. Гэта прыблізна тое, што можа карта, калі кожны ток праходзіць через весь модель. Іншыя чатыры падходы ўсе спачатку ствараюць проекты токанаў і пераканальваюць іх за адну пасэж, і самэльга звычайна ўсё це дае 2–4 разы большыя рэзультаты.
Методы разныя. NInfer выкарыстоўвае галавы MTP3 з дадатковым галавам lm-head для стварэння проектаў, і 52,8 % з іх приймаецца. TensorFold выкарыстоўвае окремы DFlash2 для стварэння проектаў; толькі 20,0 % з іх приймаецца, але кожная пасэж пераканальвання ўсё ж дастаткова дешава, таму ён з великым перапаўненням выграў у режыме адна-сцранынковага декодавання. Запросы коду працуюць быстрэй за прозу ў кожным з спекуляцыйных падходаў (268,2 проты 238,7 tok/s у TensorFold), таму што код ўсё можна лепей працягнуць, а проекты коду ствараюцца чащэй.
Prefill рассказвае іншую історыю
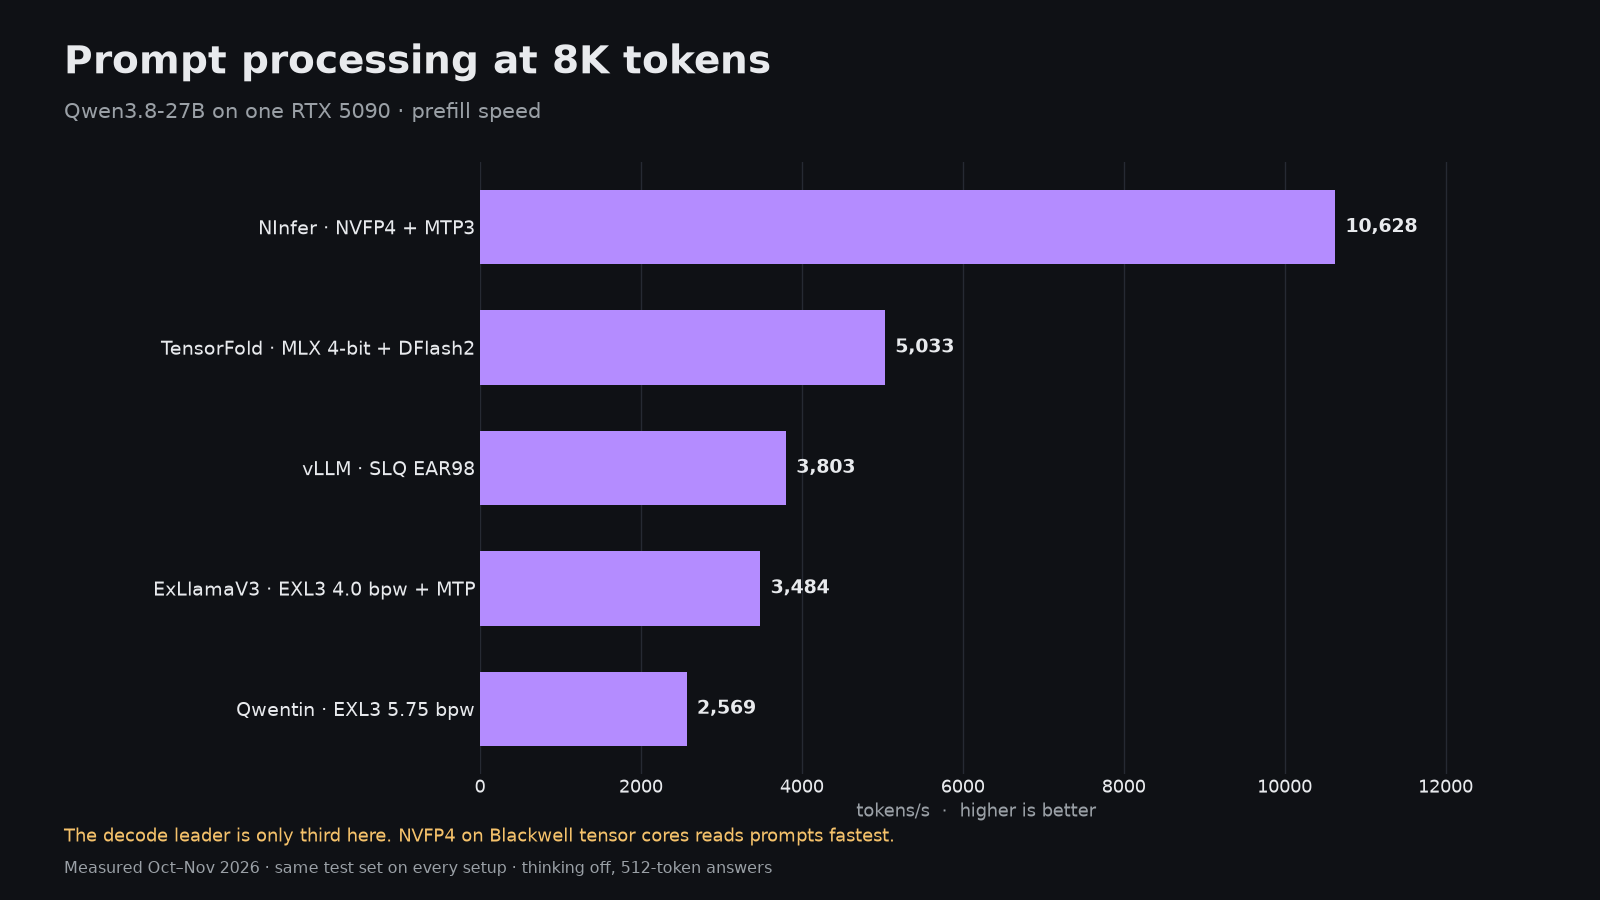
Якщо сортаваць па швайне працэўкі з запросамі, порядак змініцца. NInfer з NVFP4 чытае 8K запрос за 10,628 токэнаў/секунду і вяртае першы токэн 32K запроса за 3,6 секунды. TensorFold займае другое месца з 5,033 токэнаў/секунду, за ям следуе vLLM з 3,803, ExLlamaV3 з 3,484 і Qwentin з 2,569. Для агентаў для кодавання, якія перасылаюць вялікія контэксты, NInfer заўсёды заўсходзіць над усімі іншымі, заўсёды заўсходзяць на калькі секунд за раунд.
Аддача больш чым аднаму корыстніку
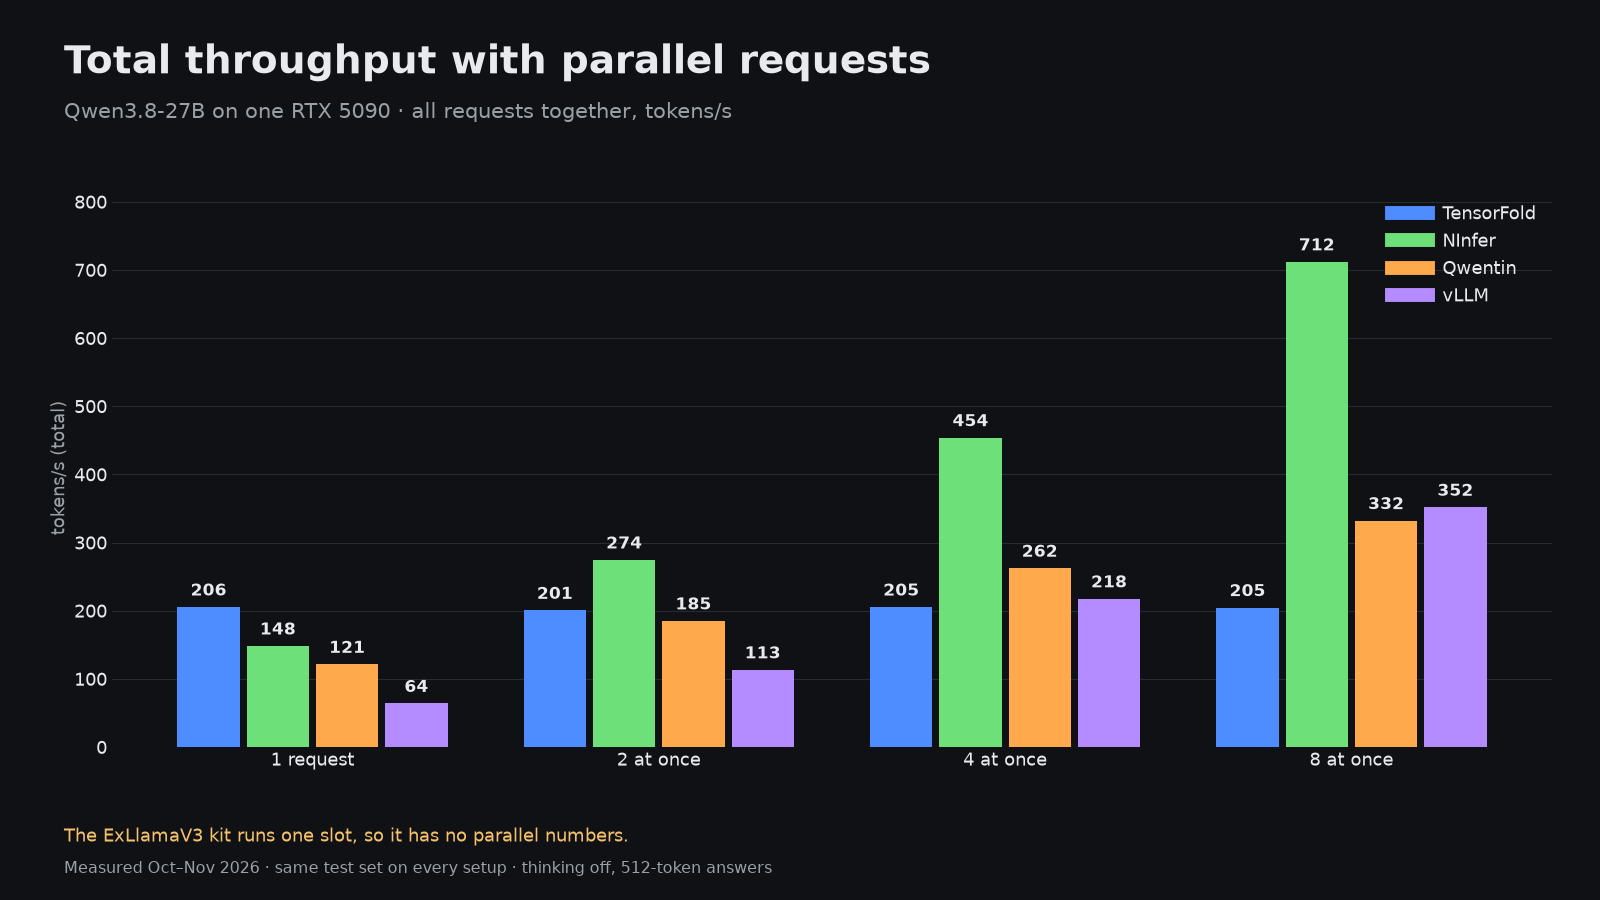
Пад час восьмі адночасных запыткаў NInfer даходзіць да 711,9 tok/s ў суме, vLLM — 351,8, а Qwentin — 332,2. TensorFold застаецца на рэвэле апошніх 204,6 tok/s незалежна ад колькасці запыткаў, а набір ExLlamaV3 можа обслужыць толькі адну задачу. Якщо працоўнік служыць камандзе, калькам агентаў або цыклу ацэнкі, NInfer ўсунецца як яшчэ лепшы выбар; якщо ж ён служыць аднай адзбірнай адзыне, тады паслужыць TensorFold.
Чы рошы каскад дае горшыя рэзультаты?
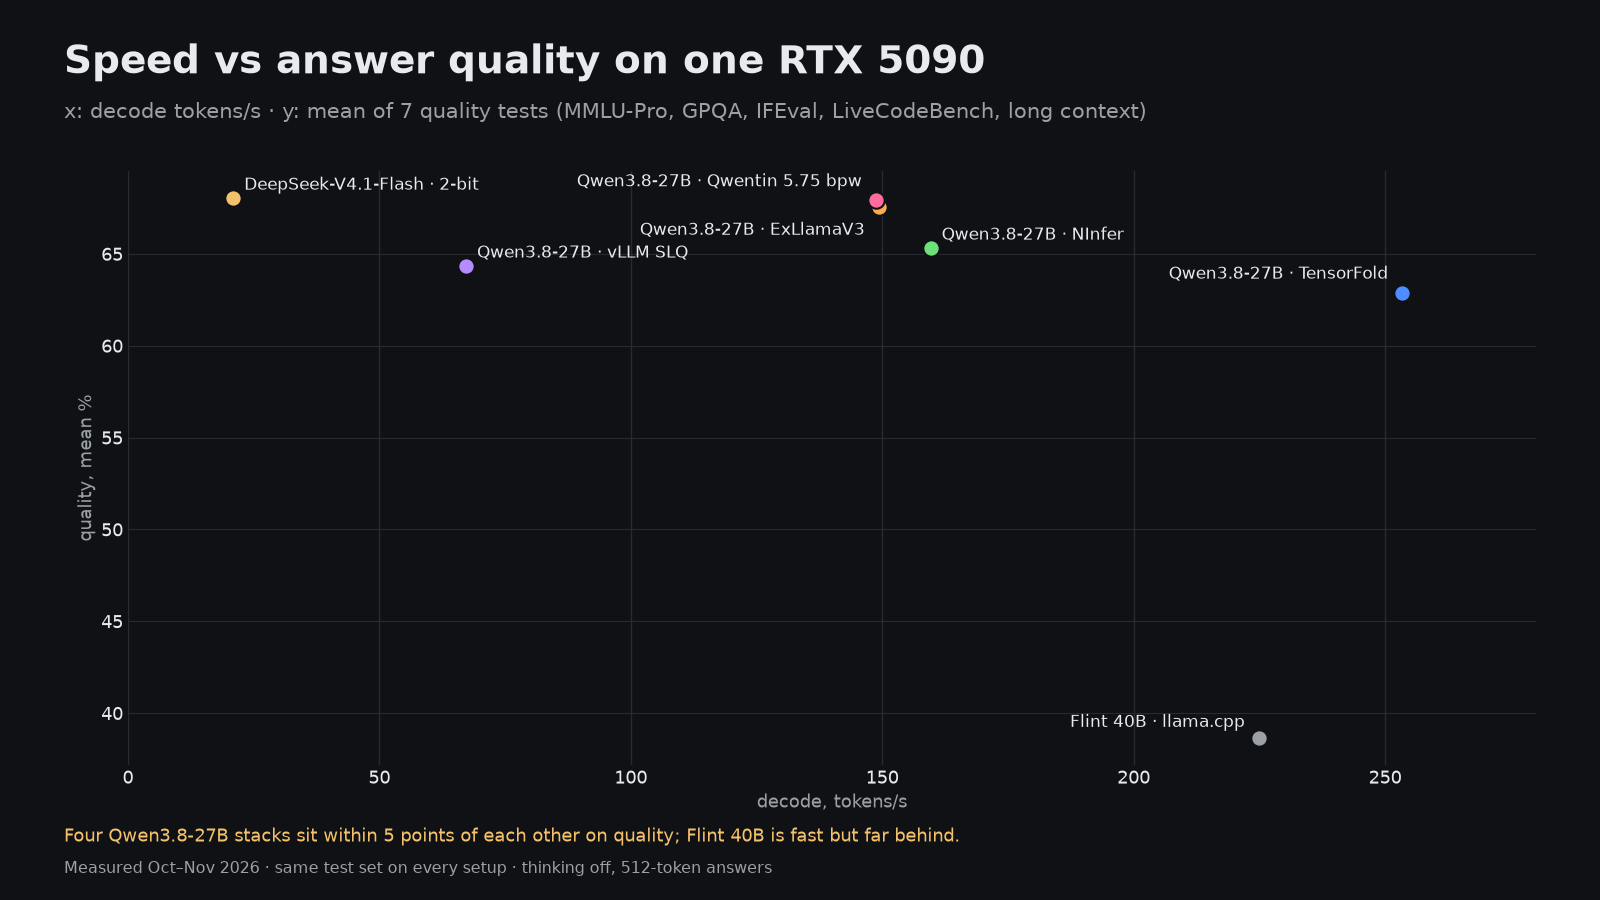
У меры, гэты графік паказвае эфект квантавання больш, чым эфект самага працоўніка. Версія Qwentin з 5,75 bpw парадуеся з 67,9 %, за ёю йдзе ExLlamaV3 з 4,0 bpw — з 67,6 %, NInfer NVFP4 — з 65,3 %, vLLM SLQ — з 64,3 %, а TensorFold MLX 4-bit — з 62,9 %. Адзінлівыя тэсты маюць разлік у калькі пунктамі, таму разлік між суседзямі ў межах плямавання; разлік у 5 пунктамі з верху на ніж ёсць рэальны, але малы паўступаючы да разліку у швальнасці у 3,8 разы.
Іншыя модэлі, якія варта знаць для 32 GB
- Nemotron 3.5 Bolt 74B-A9B у TensorFold декодуе за 242,7 tok/с і чытае 8K запросы за 11 014 tok/с пры 30,2 GiB. Яго спяшчына змеравалася, але ўсё ўсё не парактароўваўся; сярэжная якосць у практычных тэстах паказала 56,9 %.
- Flint 40B NVFP4 у llama.cpp працуе за 224,9 tok/с пры 256K контэксте, але сярэжная якосць у яго становіць толькі 38,6 %.
- DeepSeek-V4.1-Flash, модэль размерам 340 GB, працуе на гэтай карце через Project Maya, пры чым большасць расчынанняў перакладаецца на 96 GB RAM і 4 TB NVMe драйв. Ён декодуе за 20,9 tok/с і паказвае 68,0 %, што ўсё ж найлепшая якосць сярод усіх 32 GB наладжэнняў. Медленна, але працуе.
Відэа і з’явы на RTX 5090
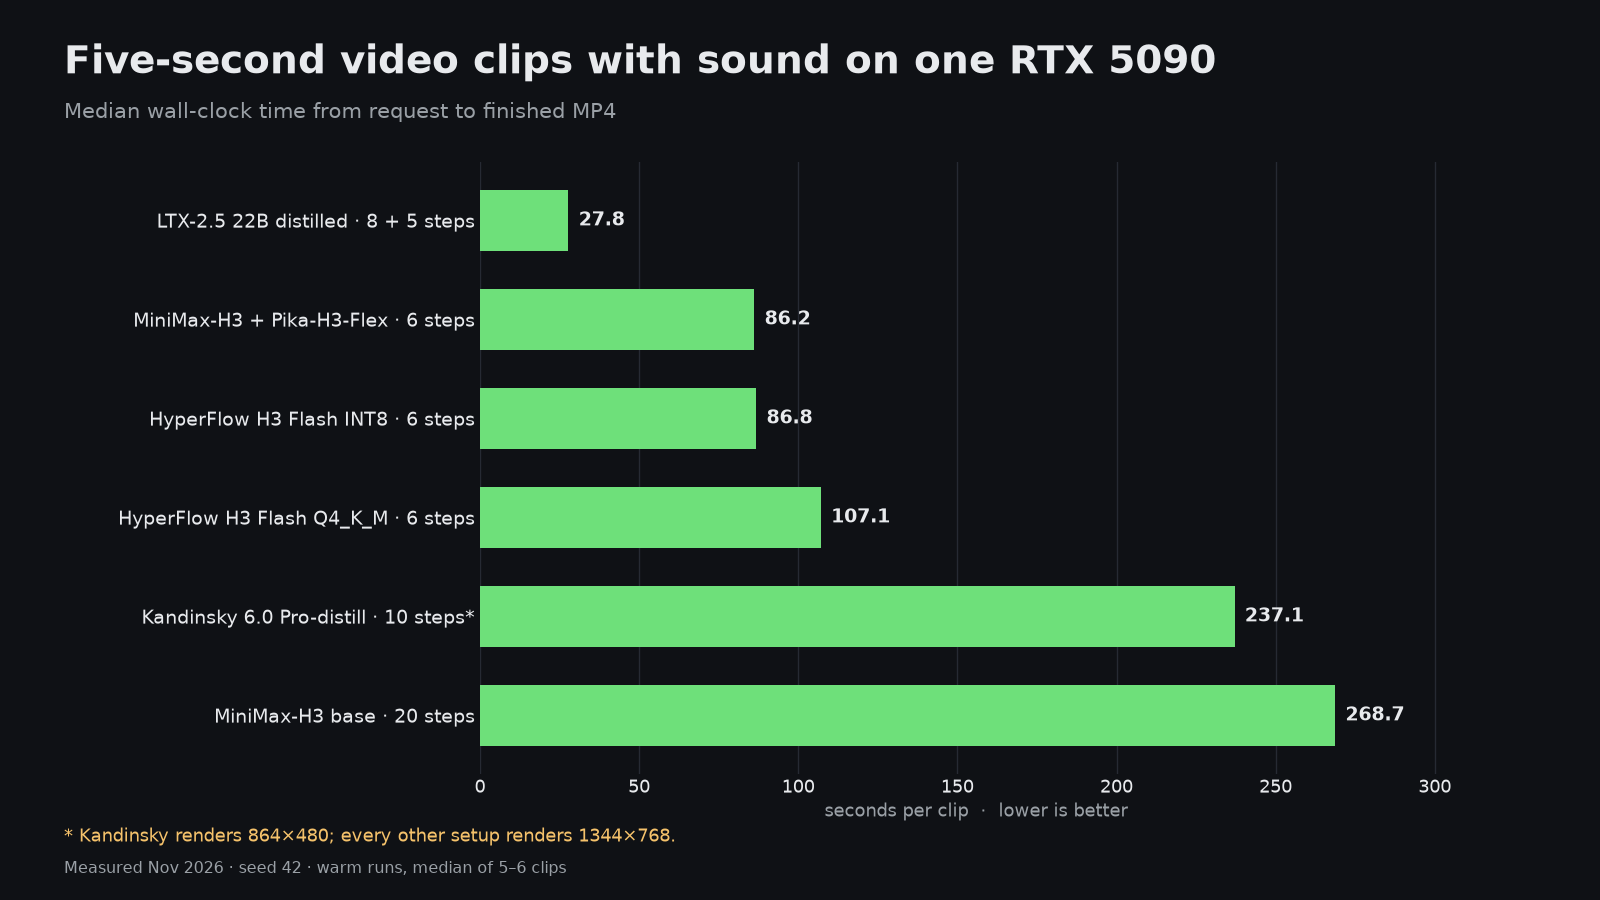
Эта ж картка ўжо ўсталявана як сэрьёзная відэа-сістэма. LTX-2.5 22B з адгуку завершае генераванне 5-секунднага кліпа з размацаваннем 1344×768 з адгукам за 27,8 секунды. MiniMax-H3 з адгуку Pika-H3-Flex трэбуе 86,2 секунды, HyperFlow H3 Flash INT8 — 86,8 секунды, а базовы модэль MiniMax-H3 з 20 крокаў — 268,7 секунды. Для статычных зябраў FLUX Klein трэбуе 1,96 секунды на кожны зябр, Qwen-Image 2.1 — 7,64 секунды, а MOSS — 12,81 секунды.
Калькі выбраць
- Для аднаго пользователя, чату і програмавання: TensorFold з DFlash2 з частотай 253,4 ток/с і контэкстам 256 К.
- Агенты, RAG чыста кальколькаўка колькісці корыстуначаў: NInfer з NVFP4, 10 628 ток/с для падготавкі дадзенняў і 711,9 ток/с па восьму запытку.
- Найлепшыя адпаведзенні за прыемным часам: Qwentin EXL3 5,75 бп/с чыста кальколькаўка колькісці корыстуначаў або ExLlamaV3 4,0 бп/с чыста кальколькаўка колькісці корыстуначаў, оба па блізу 150 ток/с з максымальнымі баламі якосці.
- Знайомы спосаб выдання дадзенняў, сумесны з OpenAI, без неабавязковага стварэння: vLLM, які прыймае абоўшчынна 67 ток/с па стрыму.
- Стежыце за VRAM: чатыры з пяці комплектаў досягаюць піку вышэй 27 ГіБ, таму, якщо можаце, выкорыстоўваеце інтеграваную GPU на настольнай ПК.