Mac Studio M5 Ultra vs DGX Spark: Velocidad de modelos de lenguaje local con los mismos modelos.
Mac Studio M5 Ultra 256 GB frente a una, dos y cuatro cajas DGX Spark en Nemotron, Qwen3.8 y DeepSeek-V4.1-Flash: decodificación, relleno previo, agrupamiento y procesamiento de imágenes.
Si un modelo no cabe en una GPU para juegos, las dos máquinas que la mayoría de las personas consideran a continuación son un Mac Studio M5 Ultra y el DGX Spark de NVIDIA. Ambas utilizan memoria unificada, pueden colocarse sobre un escritorio y se venden como dispositivos locales de IA. Su comportamiento difiere mucho cuando se prueban con los mismos modelos.
El Mac en cuestión es un Mac Studio M5 Ultra con 256 GB de memoria unificada. En el caso del Spark, se trata de unidades de 1, 2 o 4 GB10, cada una con 128 GB, conectadas mediante cables ConnectX-7 directos para lograr paralelismo de tensores; además de la unidad propia de NVIDIA, estas configuraciones multi-unidad también utilizan máquinas ASUS Ascent GX10, Gigabyte AI TOP ATOM y Lenovo ThinkStation PGX basadas en el mismo chip. Cada ejecución emplea los mismos parámetros: respuestas de 512 tokens, fase de calentamiento, cálculo de medias y tiempo de reflexión.
Mismo modelo, ambas máquinas
| Modelo | Mac Studio M5 Ultra | 1× DGX Spark | 2× DGX Spark | 4× DGX Spark |
|---|---|---|---|---|
| Nemotron 3.5 Lightning 30B-A3B, MLX 4-bit, TensorFold 1.2.5 | 306.9 tok/s | 141.9 tok/s | n/a | n/a |
| Qwen3.8-27B con DFlash2, TensorFold | 158.6 tok/s (MLX 4-bit) | 47.3 tok/s (EXL3 4.0 bpw) | n/a | n/a |
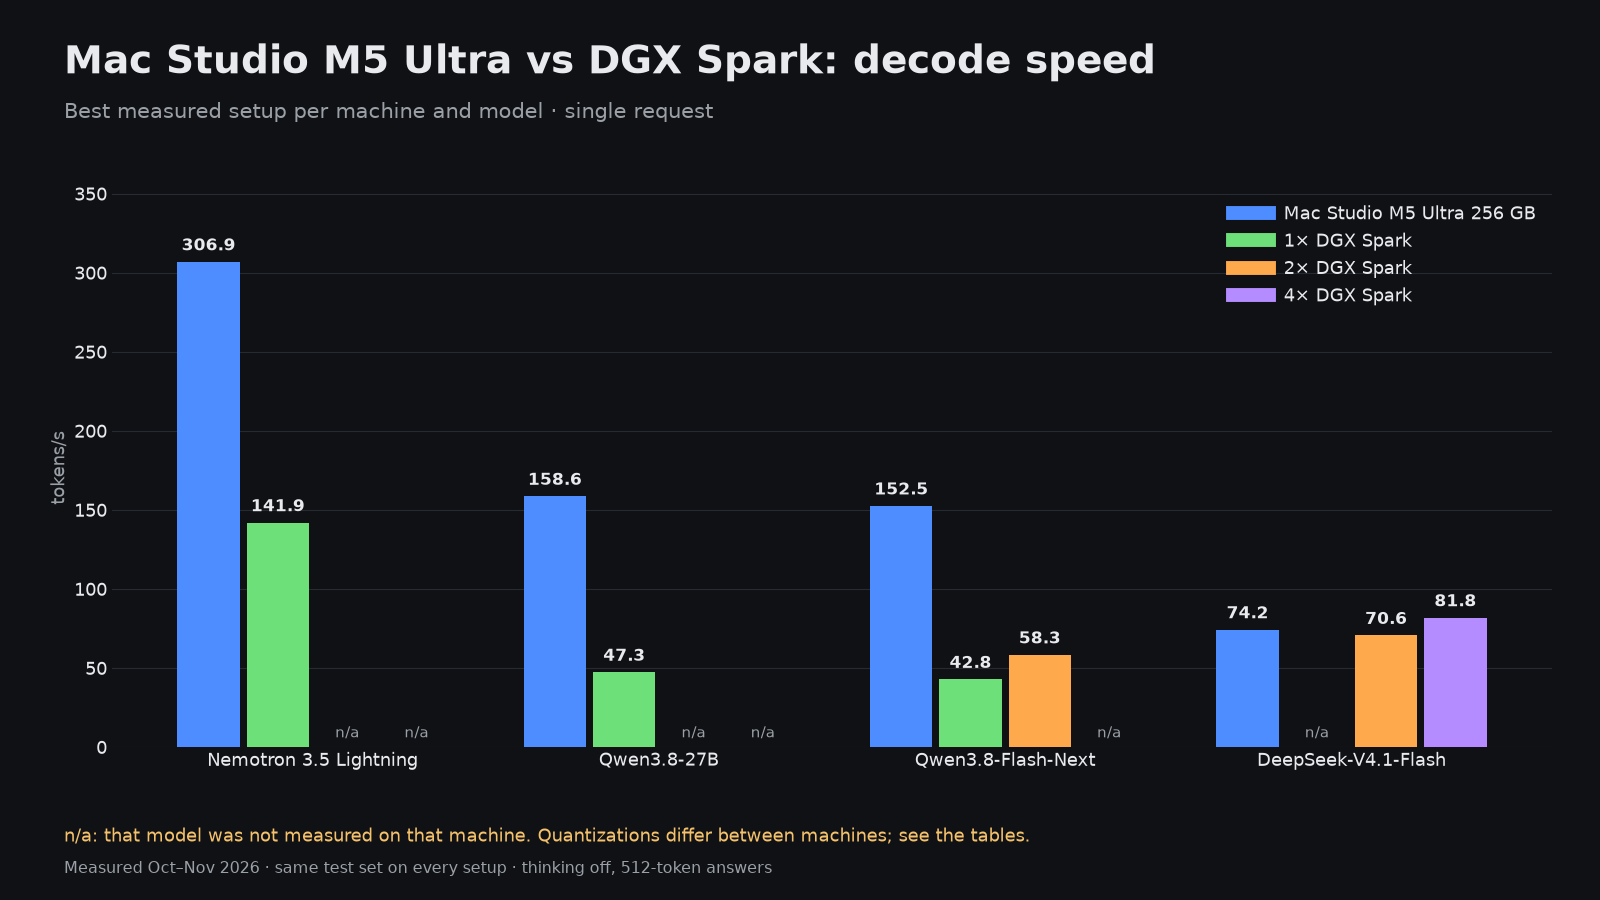
Nemotron 3.5 Lightning es la comparación más justa: misma versión TensorFold 1.2.5, mismos pesos en formato MLX de 4 bits y mismos borradores MTP. La versión para Mac decodifica a 306.9 tok/s, mientras que una instancia de Spark lo hace a 141.9 tok/s. La calidad es similar en ambos casos (51.4 % frente a 51.9 %), lo cual es esperable con pesos idénticos. En estas pruebas, la GPU de Spark tiene su frecuencia limitada a 2200 MHz.
En el modelo denso Qwen3.8-27B la diferencia es aún mayor: 158.6 tok/s en la Mac frente a 47.3 en un Spark. El ancho de banda de memoria determina la velocidad de decodificación en modelos densos, y el M5 Ultra cuenta con mucho más que un GB10 individual. Qwen3.8-Flash-Next muestra el mismo patrón, e incluso dos Spark en configuración paralela de tensores (58.3 tok/s) quedan muy por detrás de una Mac (152.5 tok/s).
DeepSeek-V4.1-Flash es donde el clúster Spark logra alcanzarlo
El gran modelo MoE cambia la situación. En la Mac, el motor Metal de TensorFold ejecuta una versión de 2/3 bits a 74.2 tok/s y utiliza 206.3 GiB de los 256 GB disponibles. Dos Spark con una configuración EXL3 de 2.5 bpw alcanzan 70.6 tok/s, mientras que cuatro Spark con una configuración de 4.0 bpw alcanzan 81.8 tok/s; esta es la única configuración que supera a la Mac con este modelo, además de utilizar una cuantización mayor.
La calidad es similar en todos ellos: 67.4 % en la Mac, 66.1 % en dos Sparks y 66.6 % en cuatro. La Mac también ejecuta otras versiones de DeepSeek: el motor ds4 con cuantización Q2 obtiene un 69.7 % a 54.5 tok/s, mientras que oMLX con LSQ3 alcanza un 60.0 % a 63.8 tok/s, utilizando 225.6 GiB.
Procesamiento de prompts
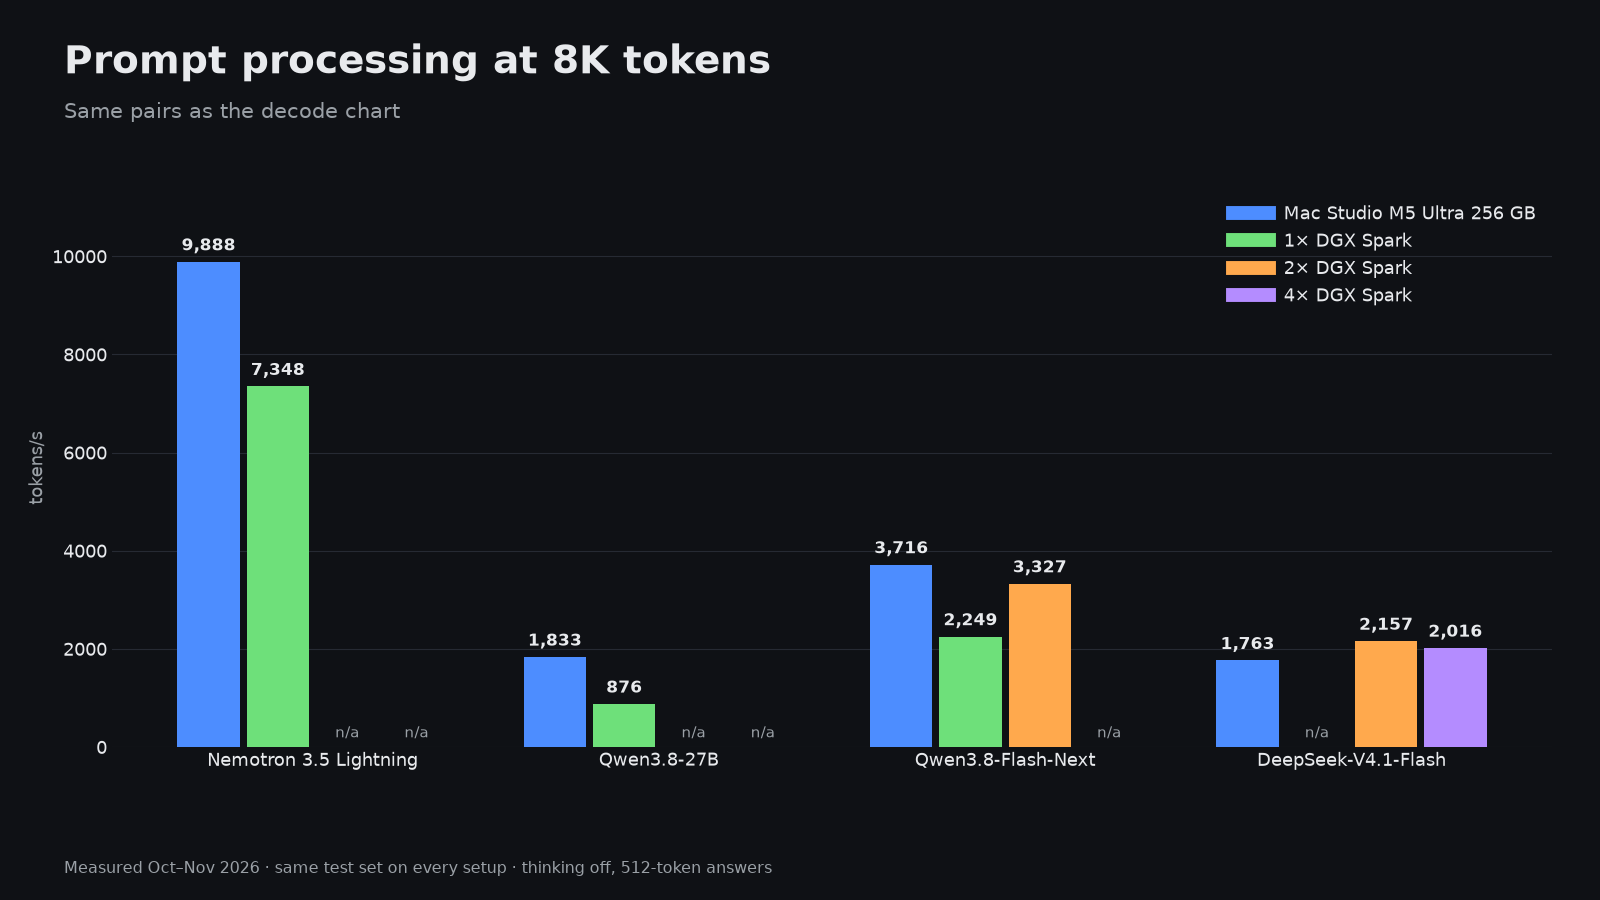
El relleno previo es más rápido que la decodificación. En Nemotron Lightning, la Mac procesa una prompt de 8K a 9,888 tok/s y una Spark a 7,348. En el modelo denso Qwen3.8-27B, las cifras son 1,833 frente a 876. En DeepSeek-V4.1-Flash gana el lado Spark: 2,157 tok/s con dos unidades y 2,016 con cuatro, en comparación con 1,763 en la Mac. El primer token de una prompt de 32K en DeepSeek tarda 18.3 s en la Mac, 17.9 s con dos Sparks y 15.8 s con cuatro.
Solicitudes en paralelo
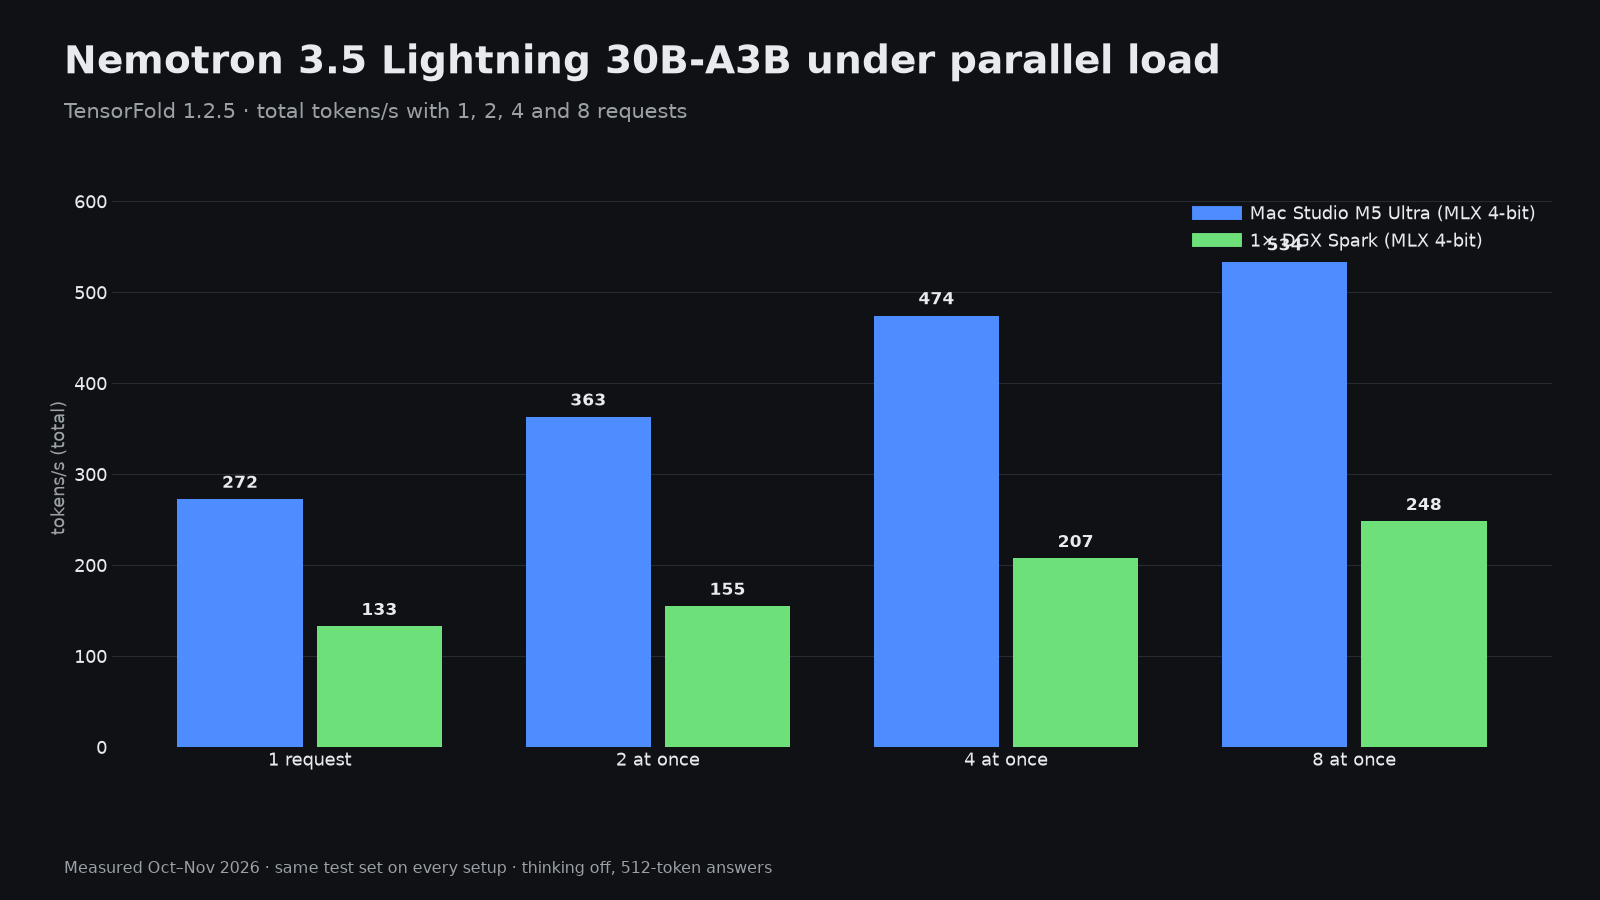
Ambas máquinas funcionan bien en modo por lotes con el modelo MoE. Con ocho solicitudes en paralelo, la Mac alcanza 533.5 tok/s en total, mientras que una Spark logra 248.0 tok/s. En DeepSeek, cuatro Spark alcanzan 141.2 tok/s en ocho solicitudes, y la Mac, 84.5 tok/s.
Imágenes y video
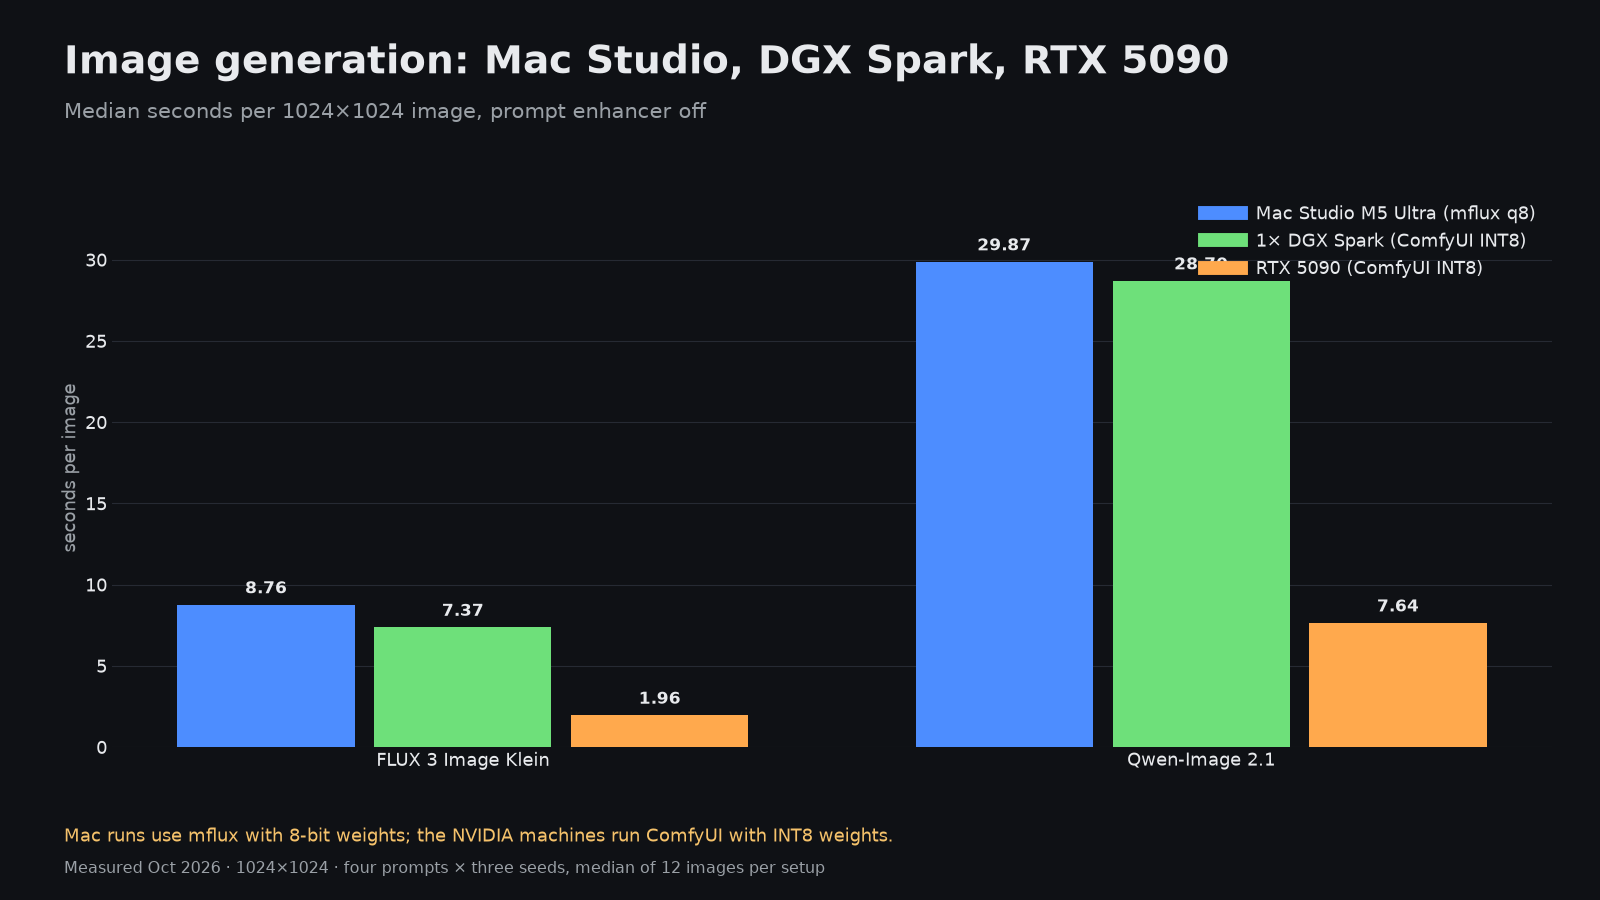
En el caso de los modelos de difusión, ninguna de estas máquinas es rápida. FLUX Klein tarda 8.76 s por imagen en el Mac y 7.37 s en un Spark; Qwen-Image 2.1 necesita 29.87 s y 28.7 s. Una RTX 5090 procesa las mismas imágenes en 1.96 s y 7.64 s. Los 128 GB del Spark sí le permiten ejecutar tareas de video de gran tamaño: volver a dibujar un borrador de 5 segundos a 2560×1440 con Open-H3-Regenerate lleva unos 22 minutos por clip, con un pico de memoria de 78.9 GiB, mucho más de lo que puede albergar una tarjeta de 32 GB.
¿Cuál para qué?
- Una persona que busca la máquina más rápida: el Mac Studio M5 Ultra. Es de dos a tres veces y media más rápido que un Spark con los mismos modelos y puede ejecutar DeepSeek-V4.1-Flash por sí solo a 74.2 tok/s.
- Crear un clúster con el tiempo: el Spark. Dos unidades pueden ejecutar DeepSeek-V4.1-Flash a la velocidad del Mac, mientras que cuatro unidades lo logran con una cuantización mayor.
- Herramientas exclusivas para CUDA, puntos de control NVFP4 y recetas vLLM o SGLang: Spark, ya que el software que deseas ya está diseñado para él.
- Imágenes y videos cortos: ninguno de los dos. Coloca una RTX 5090 junto al que elijas.
- Videos muy grandes y tareas de difusión que consumen mucha memoria: Spark, gracias a sus 128 GB de memoria accesible por la GPU.