Le Mac Studio M5 Ultra contre le DGX Spark : vitesse des modèles de langage locaux avec les mêmes modèles.
Le Mac Studio M5 Ultra 256 GB contre une, deux et quatre unités DGX Spark sur Nemotron, Qwen3.8 et DeepSeek-V4.1-Flash : décodage, préremplissage, agrégation et traitement d’images.
Si un modèle ne tient pas sur une GPU de jeu, les deux machines auxquelles la plupart des gens pensent ensuite sont le Mac Studio M5 Ultra et le DGX Spark d’NVIDIA. Toutes deux utilisent de la mémoire unifiée, se posent sur un bureau et sont vendues comme des boîtiers d’IA locales. Leur comportement diffère fortement une fois qu’on les teste avec les mêmes modèles.
Le Mac en question est un Mac Studio M5 Ultra doté de 256 GB de mémoire unifiée. Du côté du Spark, il s’agit de boîtiers de 1, 2 ou 4 GB10, chacun contenant 128 GB de mémoire, reliés entre eux par des câbles ConnectX-7 pour assurer le parallélisme tensoriel ; en plus de l’unité fournie par NVIDIA, ces configurations utilisent également des machines ASUS Ascent GX10, Gigabyte AI TOP ATOM et Lenovo ThinkStation PGX basées sur le même chip. Chaque exécution utilise les mêmes paramètres : des réponses de 512 tokens, une phase d’échauffement, des calculs de médian et une phase de réflexion.
Même modèle, deux machines
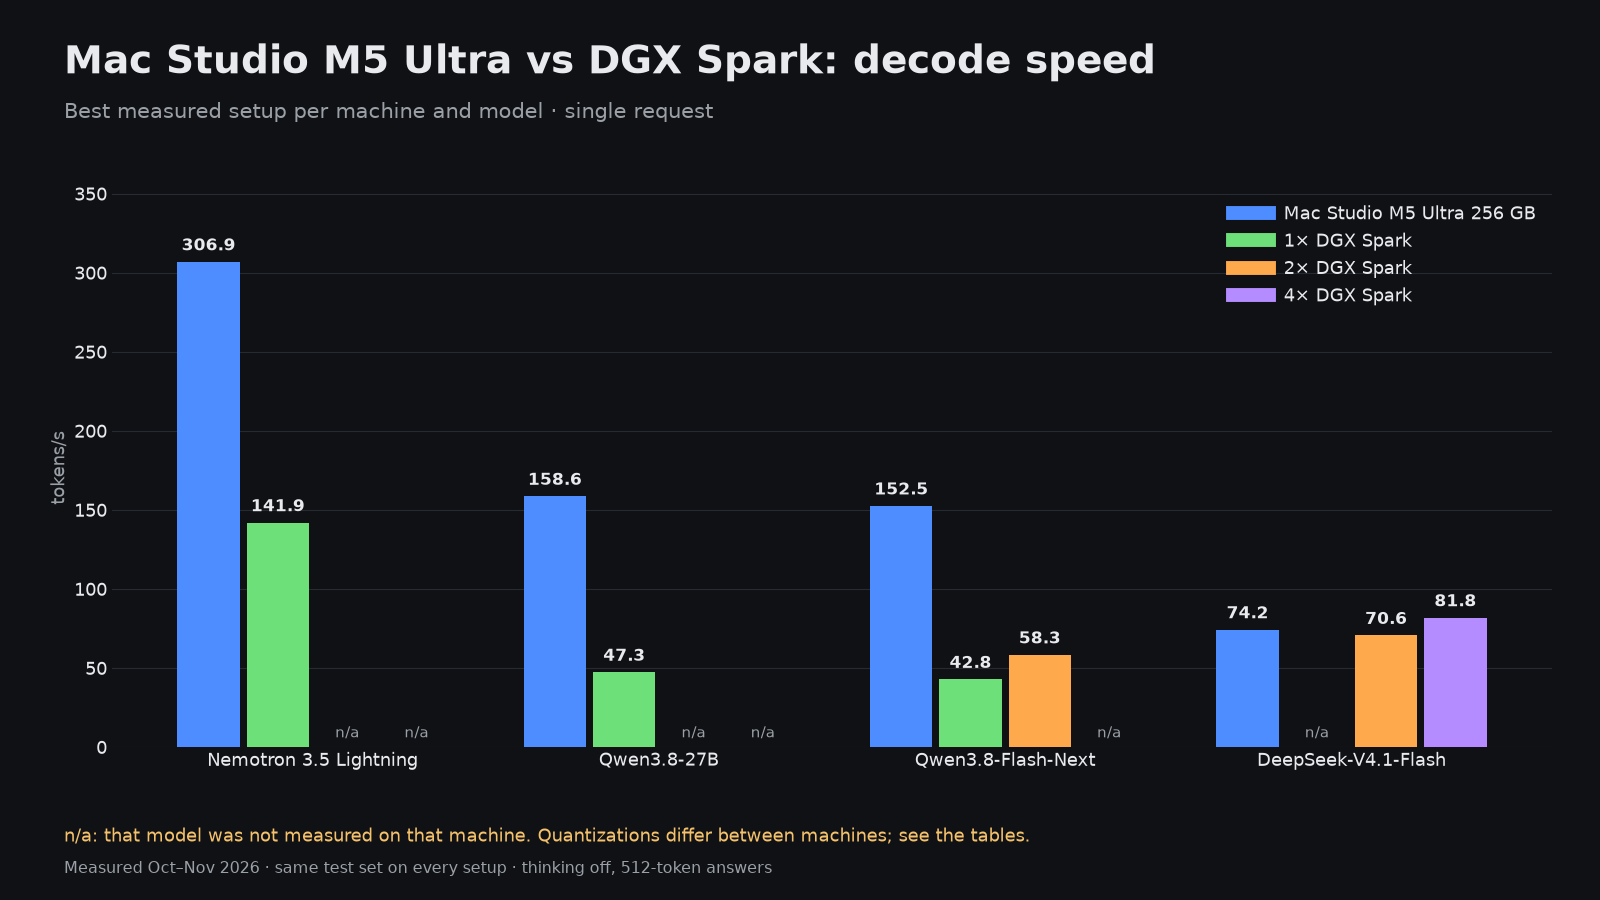
| Modèle | Mac Studio M5 Ultra | 1× DGX Spark | 2× DGX Spark | 4× DGX Spark |
|---|---|---|---|---|
| Nemotron 3.5 Lightning 30B-A3B, MLX 4-bit, TensorFold 1.2.5 | 306,9 tok/s | 141,9 tok/s | n/a | n/a |
| Qwen3.8-27B avec DFlash2, TensorFold | 158,6 tok/s (MLX 4-bit) | 47,3 tok/s (EXL3 4,0 bpw) | n/a | n/a |
Nemotron 3.5 Lightning constitue la comparaison la plus juste : même version TensorFold 1.2.5, mêmes poids en 4 bits MLX, mêmes drafts MTP. Le Mac décode à 306,9 tok/s, un Spark à 141,9. La qualité est identique des deux côtés (51,4 % contre 51,9 %), ce qui est attendu avec des poids identiques. Le Spark utilisé dans ces tests a sa fréquence GPU limitée à 2200 MHz.
Avec le modèle Qwen3.8-27B dense, l’écart est encore plus grand : 158,6 tok/s sur Mac contre 47,3 sur un seul Spark. La bande passante mémoire détermine la vitesse de décodage dense, et l’M5 Ultra en dispose bien plus qu’un GB10 seul. Qwen3.8-Flash-Next montre le même schéma, et même deux Sparks en parallélisme tensoriel (58,3 tok/s) restent nettement en retrait par rapport à un Mac (152,5 tok/s).
DeepSeek-V4.1-Flash est le domaine où le cluster Spark rattrape son retard
Le grand modèle MoE change la donne. Sur Mac, le moteur Metal de TensorFold exécute une version à 2/3 bits à 74,2 tok/s et consomme 206,3 GiB sur 256 GB. Deux Sparks avec une version EXL3 à 2,5 bpw atteignent 70,6 tok/s, tandis que quatre Sparks avec une version à 4,0 bpw atteignent 81,8 tok/s ; il s’agit de la seule configuration ici qui surpasse le Mac pour ce modèle tout en utilisant une quantification plus élevée.
La qualité est proche pour tous les appareils : 67,4 % sur le Mac, 66,1 % sur deux Sparks, 66,6 % sur quatre. Le Mac exécute également d’autres versions de DeepSeek : le moteur ds4 avec quantification Q2 atteint 69,7 % à 54,5 tok/s, tandis que oMLX avec LSQ3 atteint 60,0 % à 63,8 tok/s en utilisant 225,6 GiB.
Traitement des prompts
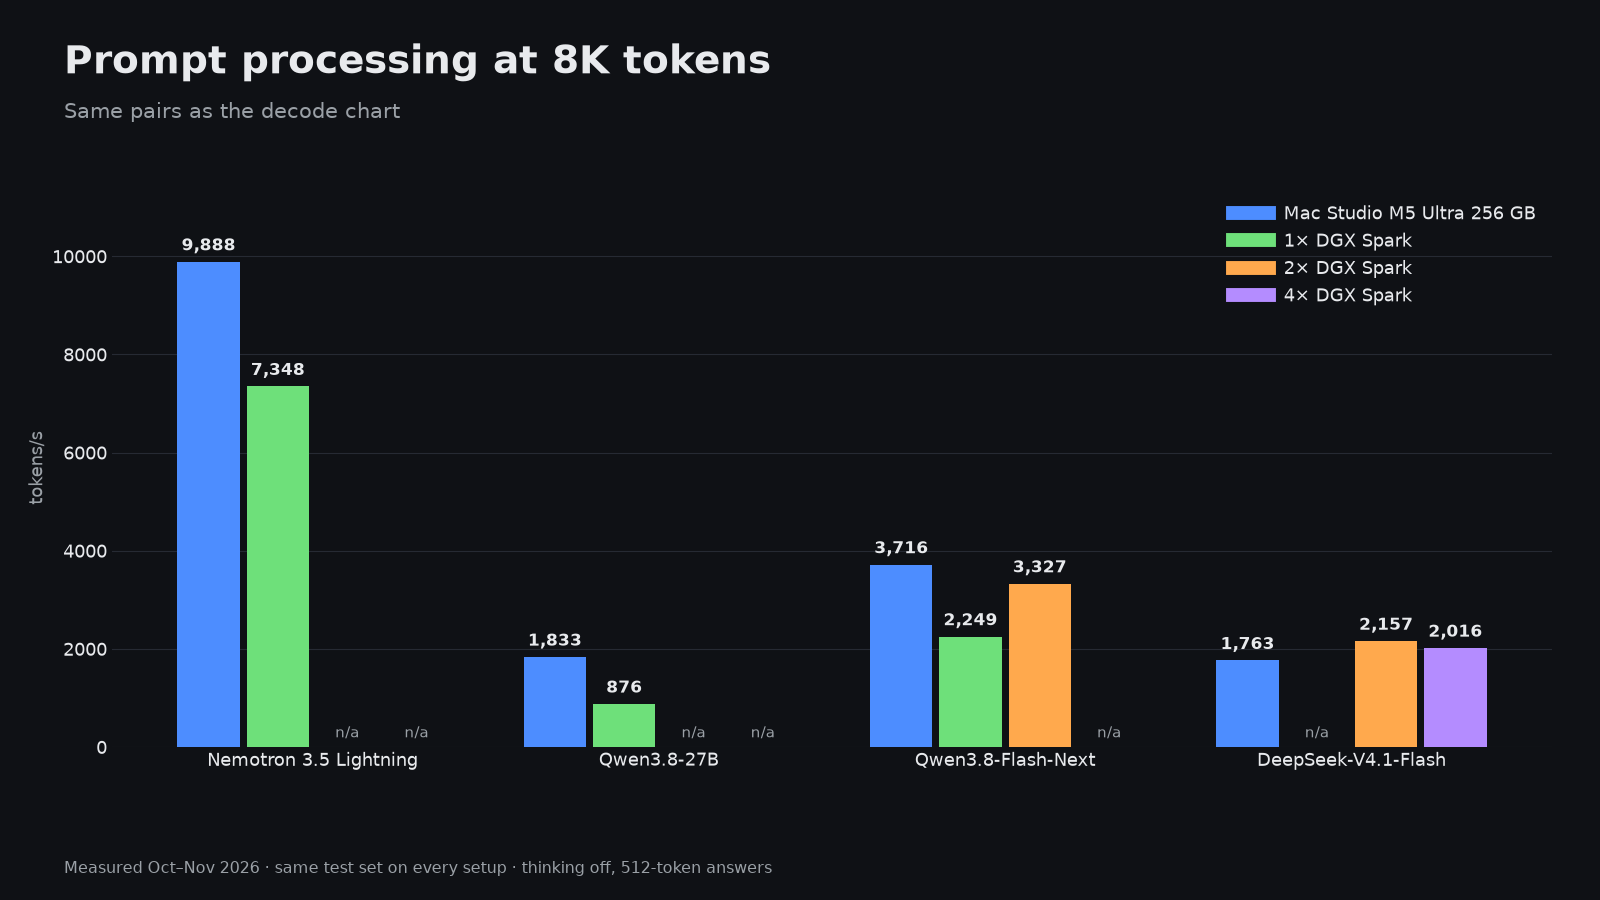
Le préchargement est plus rapide que la décodage. Sur Nemotron Lightning, le Mac lit une instruction de 8K à 9 888 tok/s et une instruction Spark à 7 348 tok/s. Sur le modèle dense Qwen3.8-27B, les valeurs sont de 1 833 tok/s contre 876 tok/s. Sur DeepSeek-V4.1-Flash, c’est le côté Spark qui l’emporte : 2 157 tok/s avec deux unités et 2 016 tok/s avec quatre unités, contre 1 763 tok/s sur le Mac. Le premier token pour une instruction de 32K sur DeepSeek nécessite 18,3 s sur le Mac, 17,9 s avec deux unités Spark et 15,8 s avec quatre unités.
Demandes en parallèle
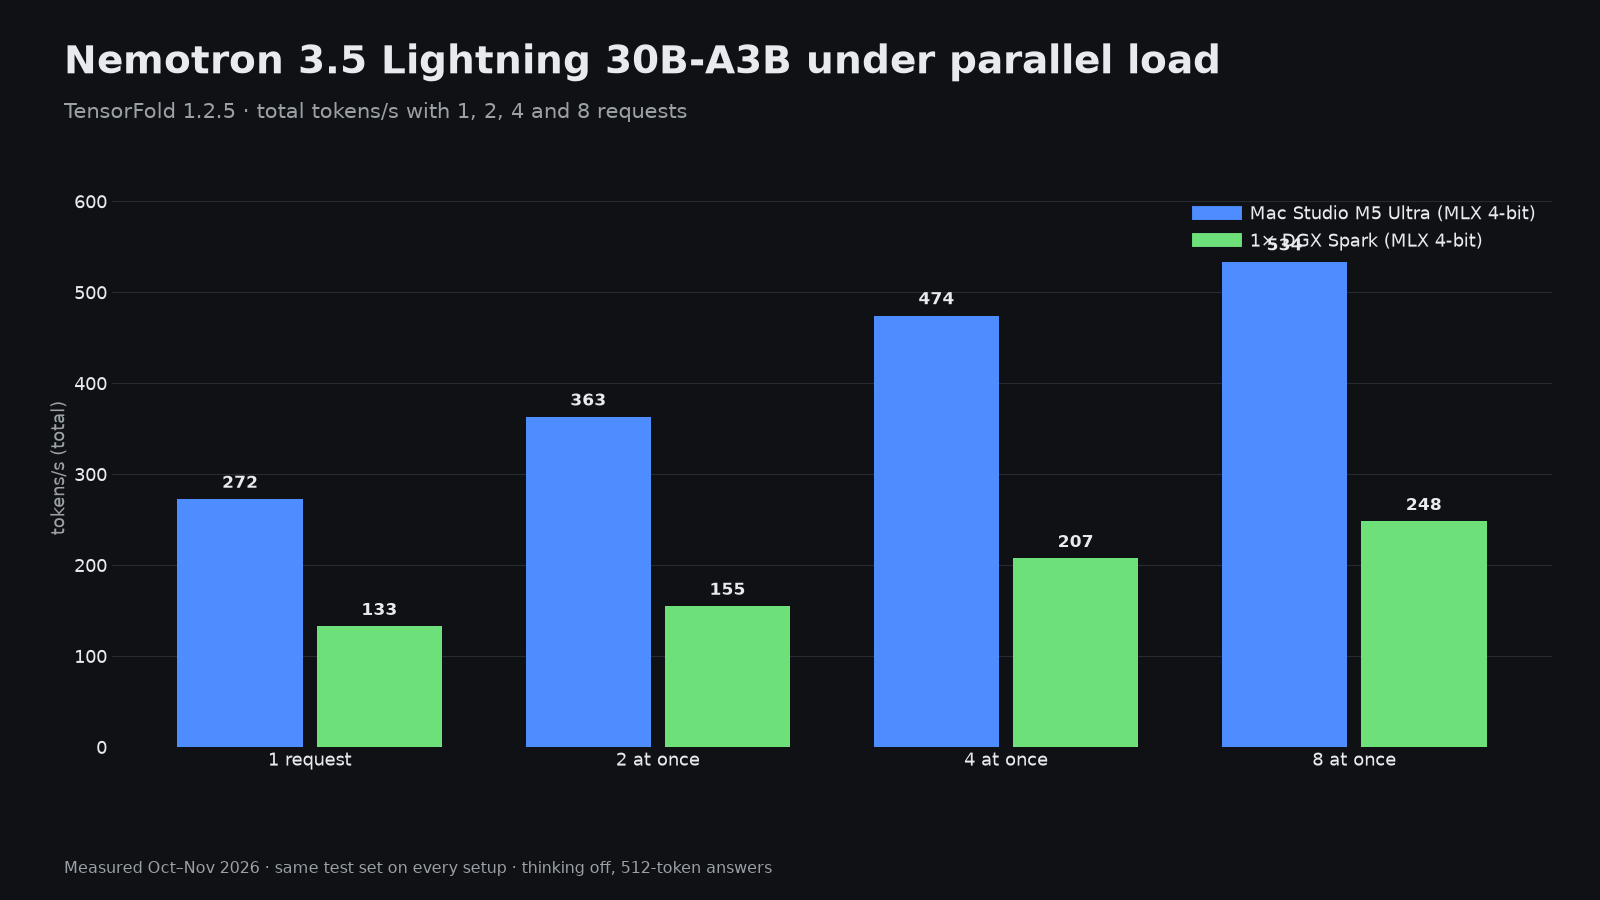
Les deux machines fonctionnent bien en mode batch avec le modèle MoE. Avec huit requêtes en parallèle, le Mac atteint 533,5 tok/s au total, tandis qu’un Spark atteint 428,0 tok/s. Sur DeepSeek, quatre Spark atteignent 141,2 tok/s pour huit requêtes, contre 84,5 tok/s pour le Mac.
Images et vidéo
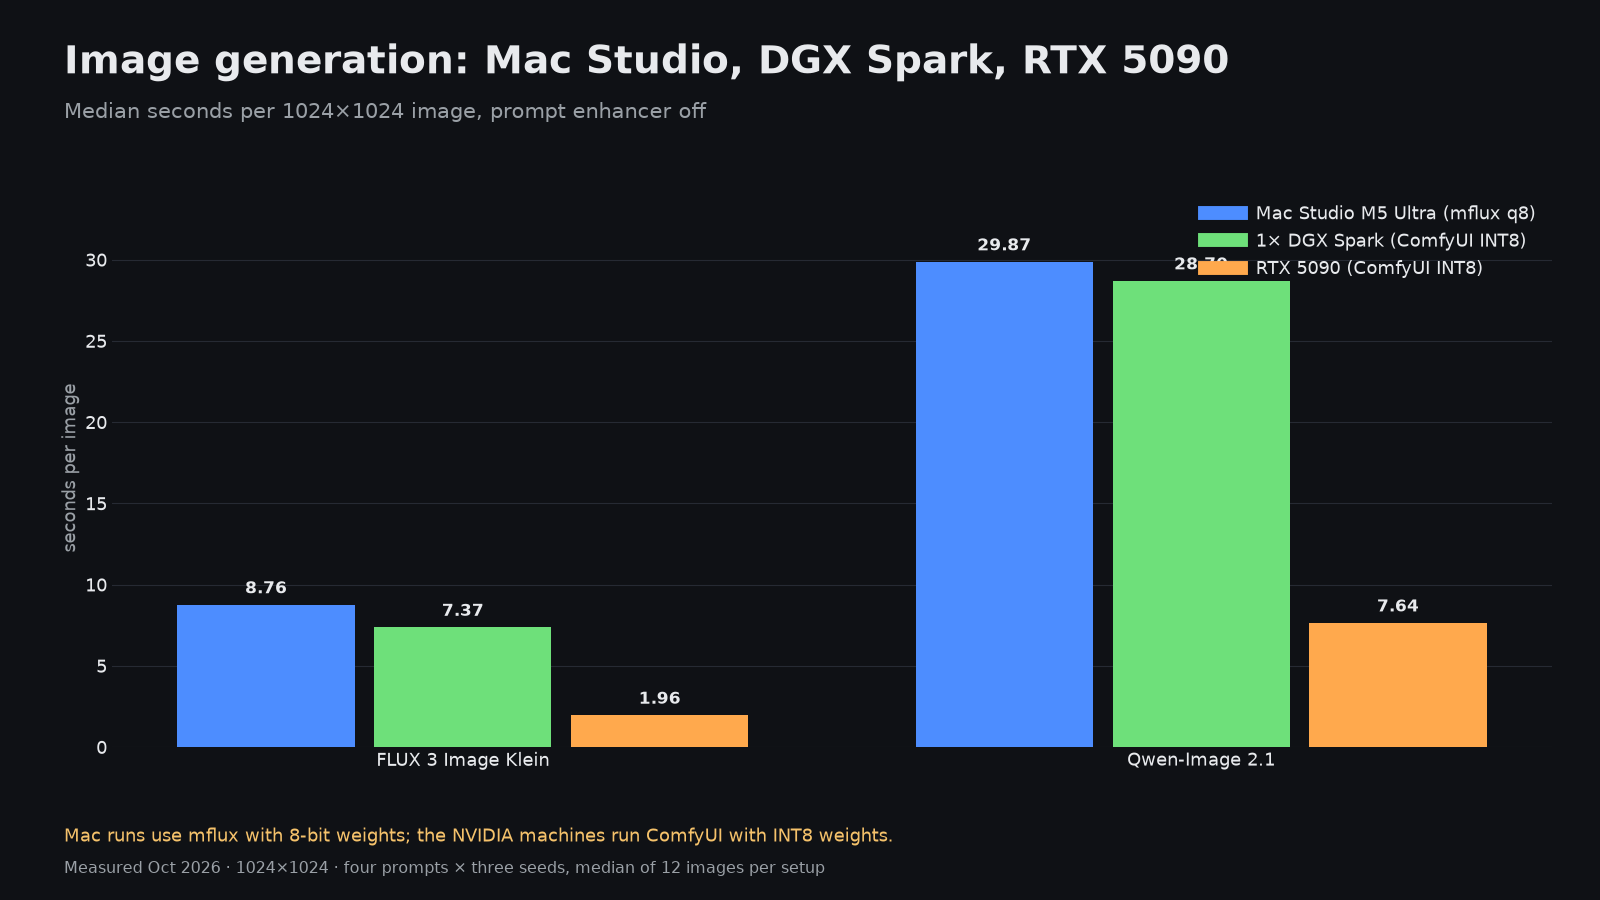
Pour les modèles de diffusion, aucune de ces machines n’est rapide. FLUX Klein met 8,76 s par image sur Mac et 7,37 s sur Spark ; Qwen-Image 2,1 nécessite 29,87 s et 28,7 s. Une RTX 5090 traite les mêmes images en 1,96 s et 7,64 s. Les 128 GB de la Spark lui permettent de gérer des tâches vidéo très volumineuses : redessiner un brouillon de 5 secondes en 2560×1440 avec Open-H3-Regenerate prend environ 22 minutes par clip, avec un pic de mémoire de 78,9 GiB, bien plus que ce que peut contenir une carte de 32 GB.
Lequel choisir pour quoi ?
- Une personne souhaitant la machine la plus rapide : le Mac Studio M5 Ultra. Il est deux à trois fois et demi plus rapide qu’une Spark avec les mêmes modèles et peut exécuter DeepSeek-V4,1-Flash seul à 74,2 tok/s.
- Créer un cluster progressivement : la Spark. Deux machines permettent d’exécuter DeepSeek-V4,1-Flash à la vitesse d’un Mac, tandis que quatre machines le font avec une quantification plus élevée.
- Outils exclusivement CUDA, points de contrôle NVFP4 ainsi que recettes vLLM ou SGLang : un Spark, car le logiciel que vous souhaitez est déjà conçu pour le prendre en charge.
- Images et vidéos courtes : aucun des deux. Placez une RTX 5090 à côté de celui que vous choisirez.
- Videos très volumineuses et tâches de diffusion gourmandes en mémoire : un Spark, grâce à ses 128 GB de mémoire accessible par la GPU.