Mac Studio M5 Ultra与DGX Spark:相同模型下的本地大语言模型运行速度对比。
Mac Studio M5 Ultra 256 GB与Nemotron、Qwen3.8及DeepSeek-V4.1-Flash平台上的1台、2台和4台DGX Spark服务器在解码、预填充、批量处理及图像处理方面的性能对比。
如果某个模型无法在游戏级GPU上运行,那么大多数人接下来会考虑的两种设备就是Mac Studio M5 Ultra和NVIDIA的DGX Spark。这两种设备都采用统一内存,都可放置在桌面上,且都被作为本地AI计算设备出售。但当用相同的模型对它们进行测试时,其表现却大相径庭。
这里的Mac指的是配备256GB统一内存的Mac Studio M5 Ultra。而DGX Spark则包括1GB、2GB或4GB版本的设备,每台拥有128GB内存,通过DirectX-7电缆相互连接以实现张量并行处理;除了NVIDIA自研的硬件外,这些多节点系统还使用了基于相同芯片的ASUS Ascent GX10、Gigabyte AI TOP ATOM以及Lenovo ThinkStation PGX设备。每次测试都使用相同的参数设置:512个标记的回答长度、预热阶段、中位数计算以及思考时间。
相同模型,两种设备
| 模型 | Mac Studio M5 Ultra | 1× DGX Spark | 2× DGX Spark | 4× DGX Spark |
|---|---|---|---|---|
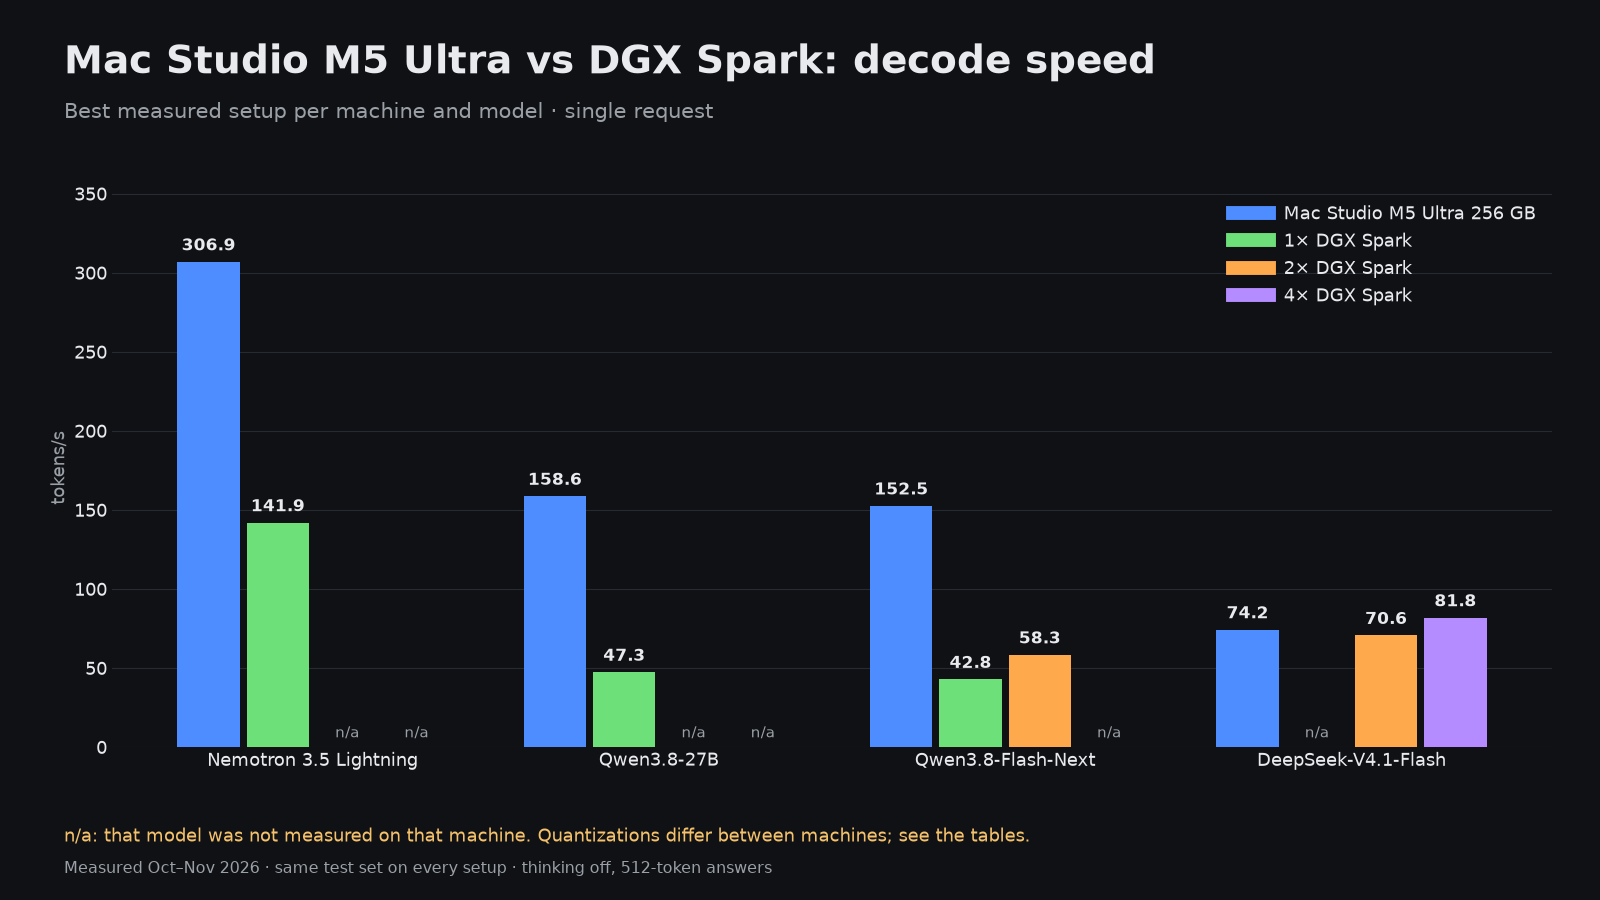
| Nemotron 3.5 Lightning 30B-A3B,MLX 4位量化,TensorFold 1.2.5 | 306.9 tok/s | 141.9 tok/s | 无数据 | 无数据 |
| 配备DFlash2和TensorFold的Qwen3.8-27B | 158.6 tok/s(MLX 4位量化) | 47.3 tok/s(EXL3 4.0 bpw量化) | 无数据 | 无数据 |
Nemotron 3.5 Lightning是最公平的对比对象:使用相同的TensorFold 1.2.5版本、相同的MLX 4位权重以及相同的MTP草稿。Mac的解码速度为306.9 tok/s,一台Spark的解码速度为141.9 tok/s。两者的质量相同(分别为51.4%和51.9%),这正是相同权重应有的结果。在这些测试中,Spark的GPU时钟频率被限制在2200 MHz。
在密集型Qwen3.8-27B模型上,差距更为明显:Mac上的处理速度为158.6 tok/s,而单个Spark节点仅为47.3 tok/s。内存带宽决定了密集解码的性能,M5 Ultra的内存带宽远高于单个GB10节点。Qwen3.8-Flash-Next模型也呈现相同趋势,即便两个Spark节点以张量并行方式运行(58.3 tok/s),仍远远落后于单个Mac节点(152.5 tok/s)。
DeepSeek-V4.1-Flash模型则是Spark集群迎头赶上的领域
大型MoE模型改变了这一局面。在Mac上,TensorFold的Metal引擎以2/3位量化格式运行时,处理速度可达74.2 tok/s,同时会占用256 GB内存中的206.3 GiB。两个采用2.5 bpw EXL3量化格式的Spark节点处理速度可达70.6 tok/s,而四个采用4.0 bpw量化格式的Spark节点处理速度可达81.8 tok/s——这是唯一一种在该模型上性能超越Mac且采用更高量化级别的配置。
所有设备的表现都很接近:Mac的准确率为67.4%,两台Sparks的准确率为66.1%,四台Sparks的准确率为66.6%。Mac还支持其他DeepSeek版本:采用Q2量化方式的ds4引擎在54.5 tokens/秒的速度下准确率为69.7%,而采用LSQ3量化方式的oMLX引擎在消耗225.6 GiB内存的情况下,准确率为60.0%,速度为63.8 tokens/秒。
提示词处理
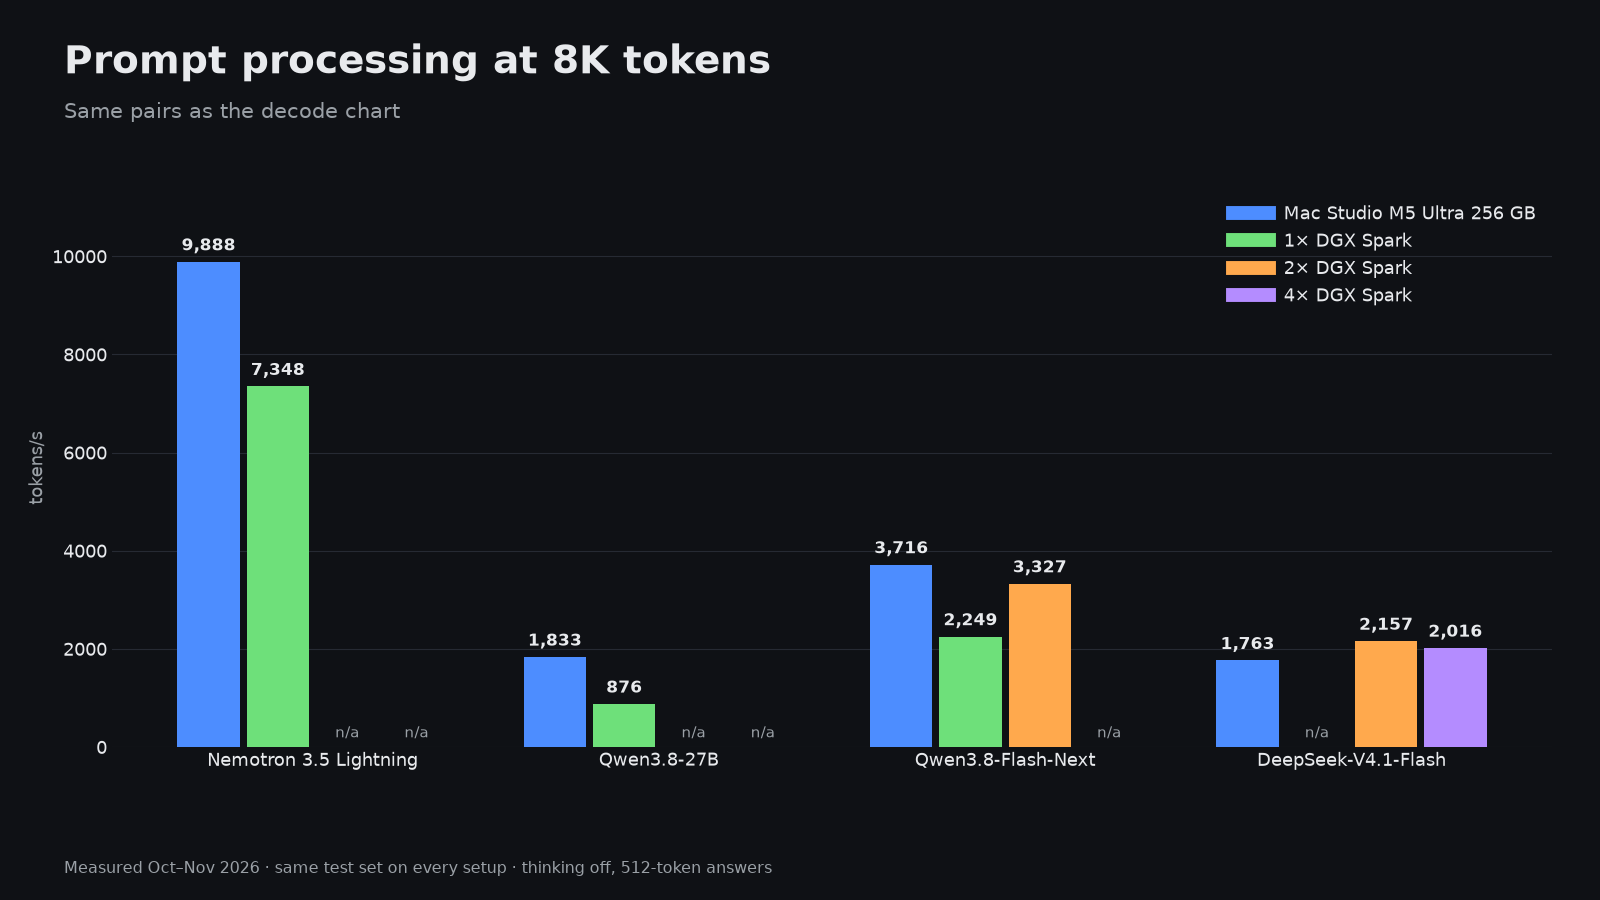
预填充速度比解码速度更快。在Nemotron Lightning上,Mac处理8K长度的提示语时速为9,888个标记/秒,而单个Spark处理时的速率为7,348个标记/秒。在密集型模型Qwen3.8-27B上,这一数值分别为1,833和876。在DeepSeek-V4.1-Flash上,Spark版本更具优势:两台设备处理时的速率为2,157个标记/秒,四台设备则为2,016个标记/秒,而Mac的速率为1,763个标记/秒。在DeepSeek上处理32K长度的提示语时,Mac的首个标记生成时间为18.3秒,两台Spark设备为17.9秒,四台则为15.8秒。
并行请求
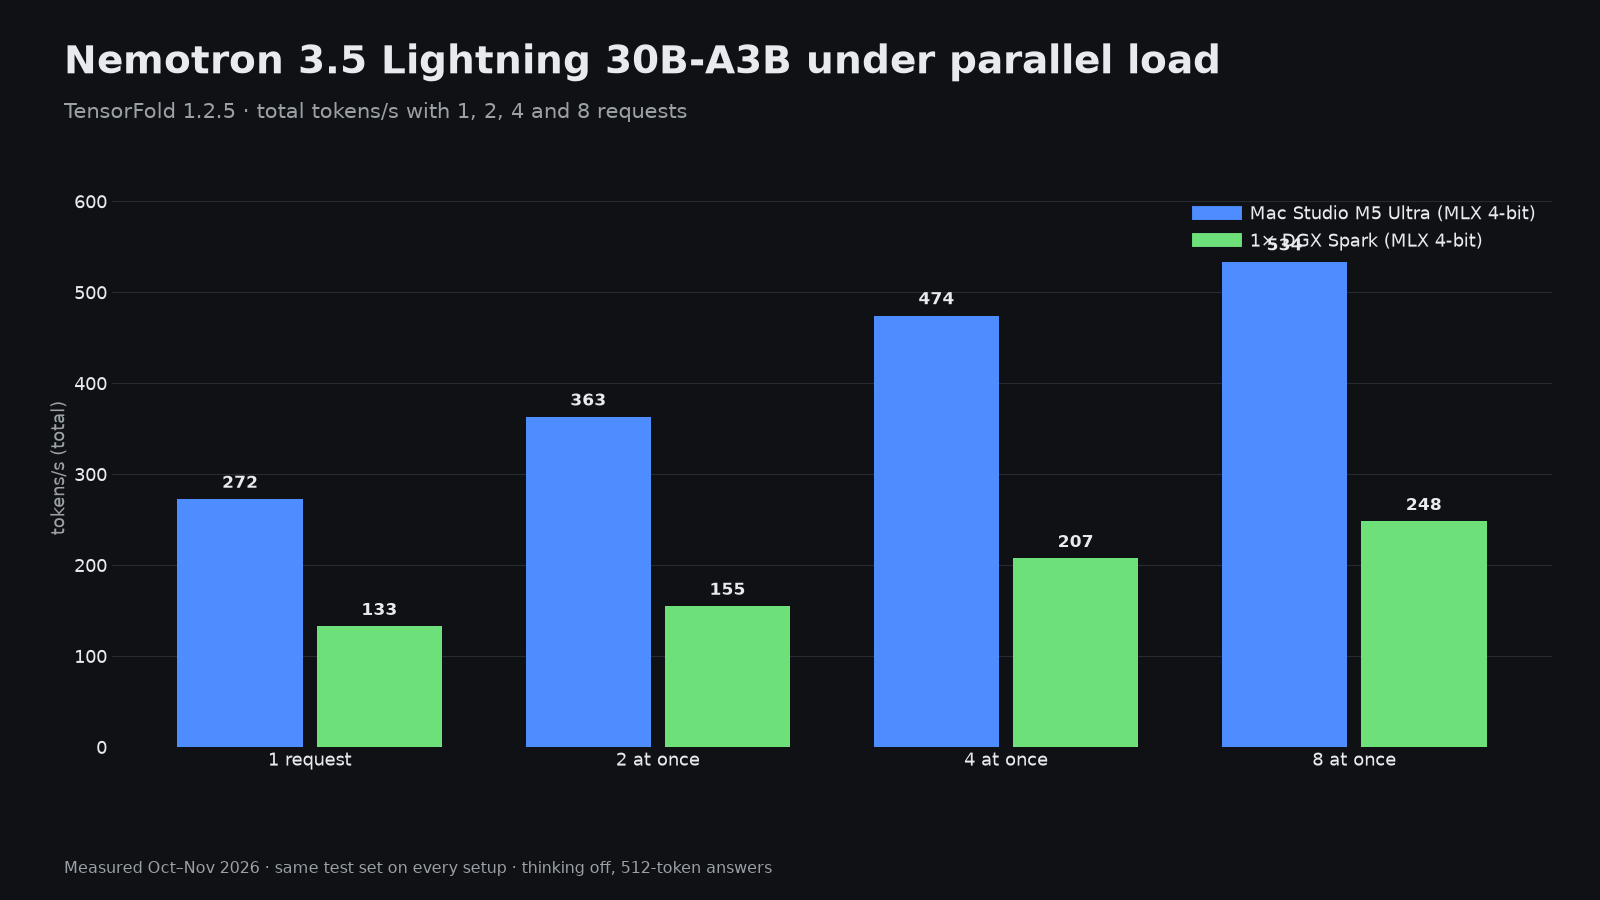
在MoE模型上,这两台机器的批量处理性能都很出色。在处理8个并行请求时,Mac的总处理速度为533.5 tok/s,而Spark为248.0 tok/s。在DeepSeek平台上,4台Spark在处理8个请求时的总速度为141.2 tok/s,Mac则为84.5 tok/s。
图像与视频
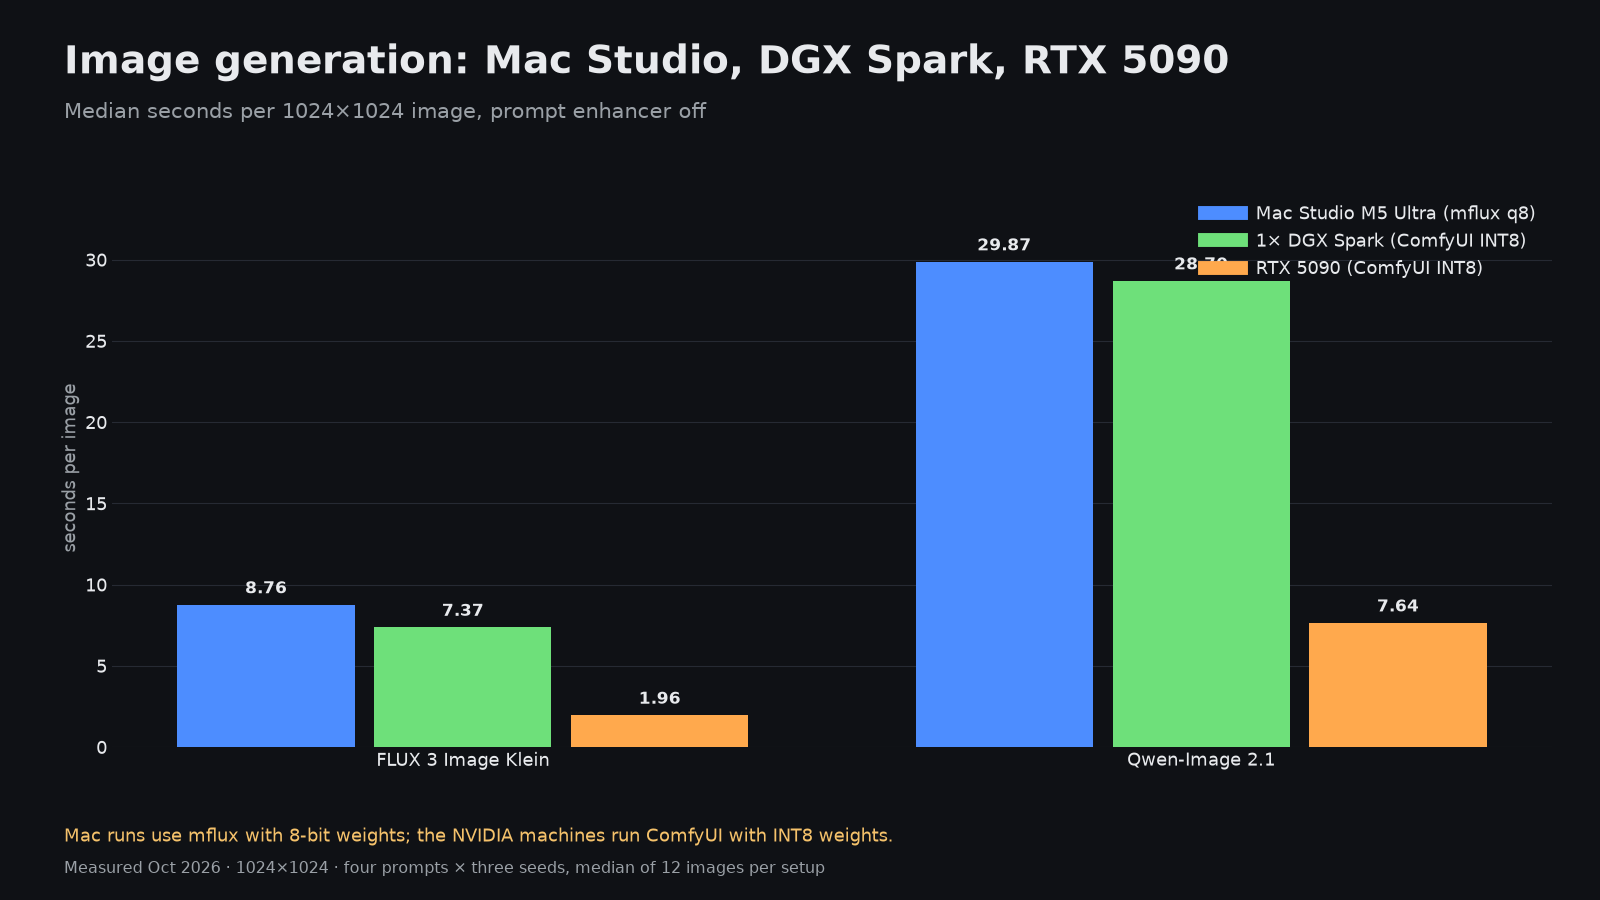
对于扩散模型而言,这两种机器的速度都不算快。FLUX Klein在Mac上的处理时间为每张图片8.76秒,在Spark上为7.37秒;Qwen-Image 2.1则分别为29.87秒和28.7秒。而RTX 5090处理相同图片的时间仅为1.96秒和7.64秒。Spark拥有128 GB的显存,因此能够处理非常大的视频任务:使用Open-H3-Regenerate以2560×1440的分辨率重新生成5秒长的视频片段时,内存峰值可达78.9 GiB,每段视频的处理时间约为22分钟,这远远超过了32 GB显存显卡的承载能力。
何种场景选哪种
- 需要最快单台设备的用户:Mac Studio M5 Ultra。在处理相同模型时,它的速度是Spark的2到3.5倍,还能以74.2 tok/s的速度独立运行DeepSeek-V4.1-Flash。
- 计划逐步构建集群的用户:选择Spark。两台设备即可以与Mac相同的速度运行DeepSeek-V4.1-Flash,而四台设备则可通过更高精度的量化方式实现相同性能。