Pruebas de rendimiento de LLM locales en RTX 5090: mismo Qwen3.8-27B, de 67 a 253 tokens por segundo.
Qwen3.8-27B en una RTX 5090 mediante TensorFold, NInfer, ExLlamaV3, Qwentin y vLLM: decodificación, relleno previo, rendimiento en paralelo, calidad y qué stack utilizar.
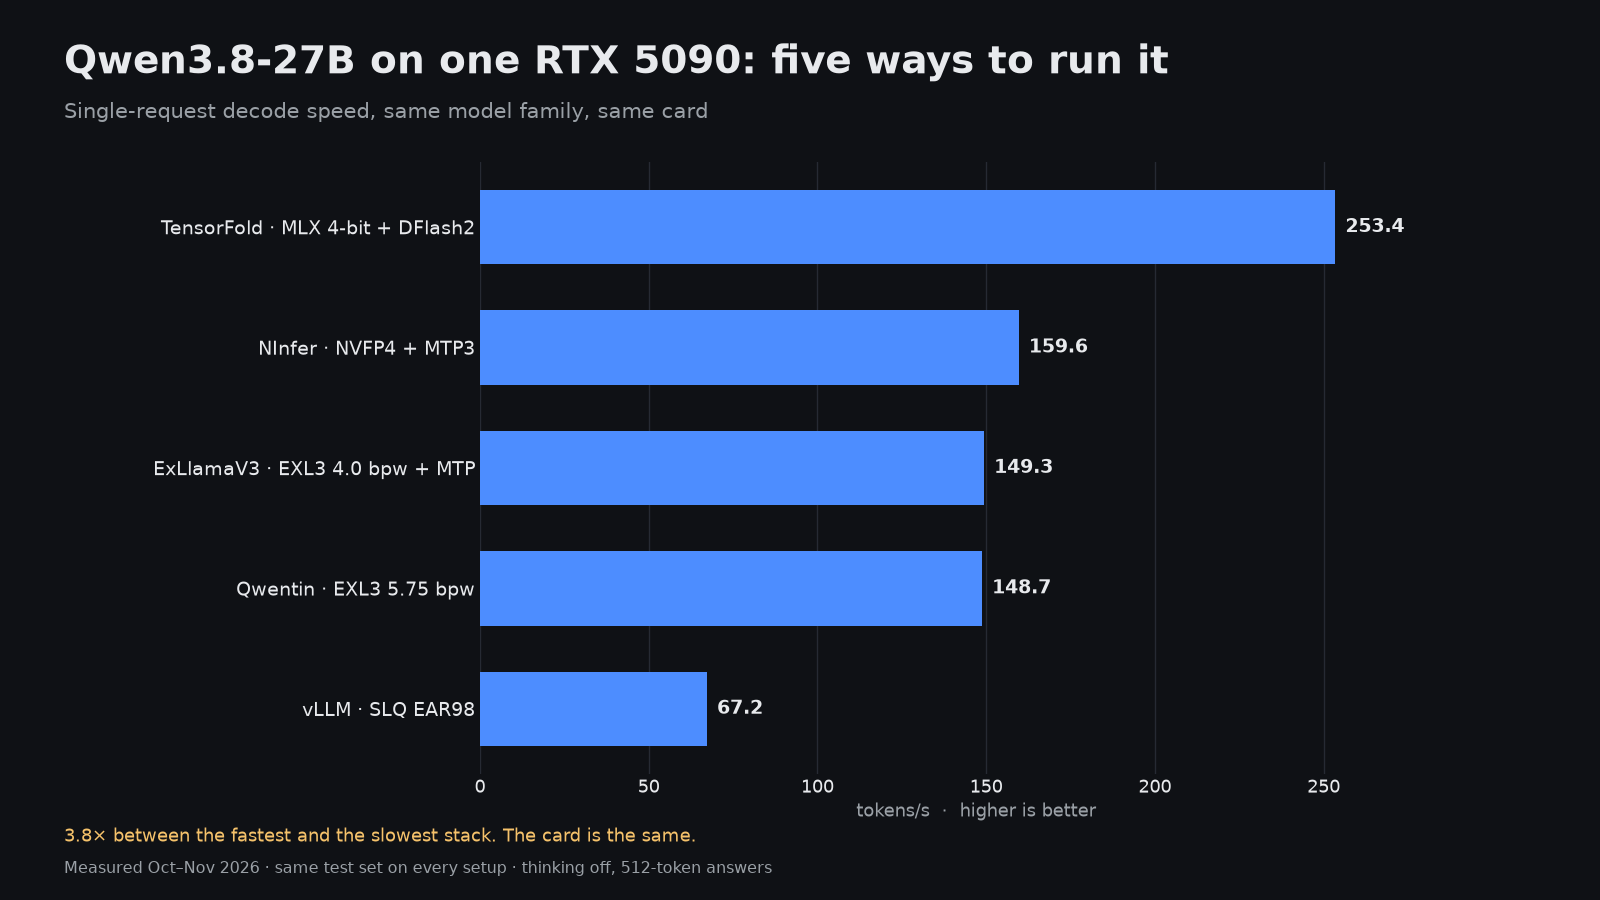
Si se utiliza el mismo Qwen3.8-27B en la misma RTX 5090, se pueden obtener entre 67.2 y 253.4 tokens por segundo. La diferencia radica en el motor, la cuantización y el método de decodificación especulativa asociado. Se midieron cinco configuraciones completas con un mismo conjunto de herramientas y parámetros de calidad, por lo que la comparación se centra en la capa de software y no en el hardware.
La tarjeta es una RTX 5090 de 32 GB. La decodificación corresponde a la mediana de las respuestas de 512 tokens obtenidas con un prompt de código y uno de prosa; el tiempo de relleno previo y el tiempo del primer token se miden con 2K, 8K y 32K tokens; el rendimiento en paralelo es la cantidad total de tokens por segundo en 1, 2, 4 y 8 solicitudes simultáneas.
Cinco configuraciones para un mismo modelo
| Motor | Cuantización | Decodificación, tok/s | Código / prosa | Relleno previo 8K, tok/s | Primer token a 32K | Calidad promedio | Contexto más grande | VRAM máxima |
|---|---|---|---|---|---|---|---|---|
| TensorFold + DFlash2 | MLX 4-bit | 253.4 | 268.2 / 238.7 | 5,033 | 7.7 s | 62.9 % | 256K | 27.3 GiB |
| NInfer + MTP3 | NVFP4 | 159.6 | 169.0 / 150.1 | 10,628 | 3.6 s | 65.3 % | 240,000 | 28.9 GiB |
| ExLlamaV3 + MTP | EXL3 4.0 bpw | 149.3 | 154.5 / 144.2 | 3,484 | 10.5 s | 67.6 % | 128K | 18.9 GiB |
| Qwentin + MTP | EXL3 5.75 bpw | 148.7 | 158.3 / 139.2 | 2,569 | 13.7 s | 67.9 % | 128K | 29.7 GiB |
| vLLM, sin especulación | SLQ EAR98 | 67.2 | 67.2 / 67.1 | 3,803 | 9.5 s | 64.3 % | 74,752 | 29.5 GiB |
La decodificación especulativa explica la mayor parte de la diferencia
vLLM ejecuta este modelo sin especulación y alcanza 67.2 tok/s, con código y prosa en torno a 0.1 tok/s. Eso es más o menos lo que logra la tarjeta cuando cada token pasa por el modelo completo. Los otros cuatro métodos elaboran los tokens de antemano y los verifican en una sola pasada, y de ahí proviene el aumento de 2× a 4× en la velocidad.
Los métodos difieren. NInfer utiliza cabezales MTP3 con un cabezal lm-head adicional para la elaboración preliminar, y el 52.8 % de las propuestas elaboradas son aceptadas. TensorFold emplea un elaborador DFlash2 separado; solo el 20.0 % de sus propuestas son aceptadas, pero cada pasada de verificación es lo suficientemente económica como para que siga ganando por una amplia ventaja en la decodificación de flujo único. Las solicitudes de código son más rápidas que las de prosa en todos los métodos basados en especulación (268.2 vs 238.7 tok/s en TensorFold), ya que el código es más predecible y las propuestas preliminares tienen más éxito en ser aceptadas.
Prefill cuenta una historia diferente
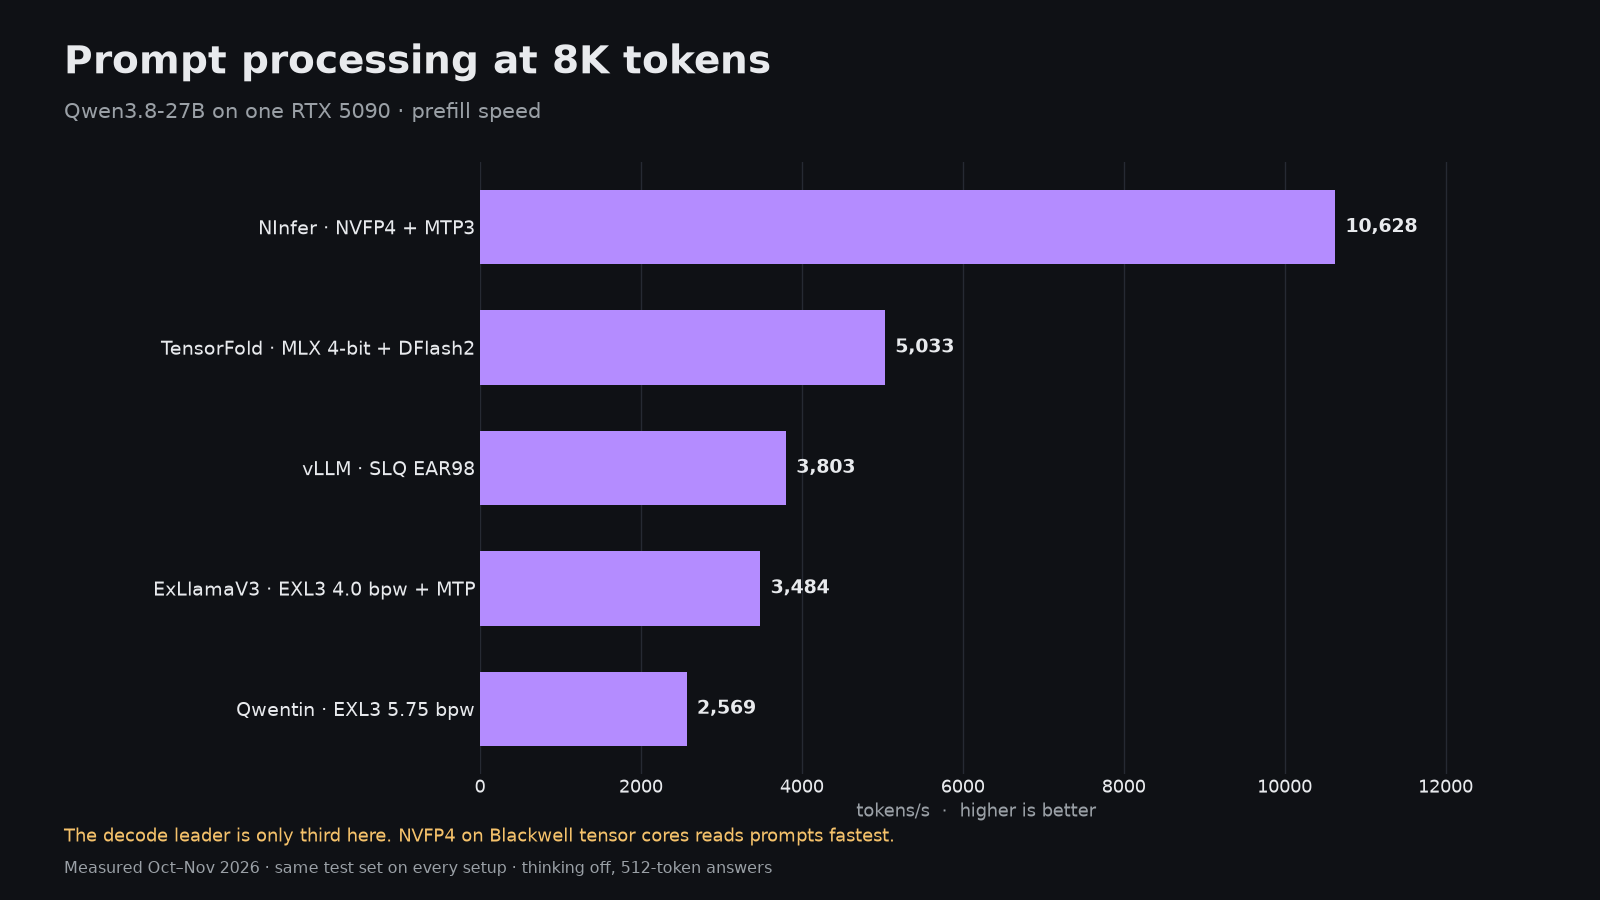
Al ordenar por velocidad de procesamiento de prompts, el orden cambia. NInfer con NVFP4 procesa un prompt de 8K a 10,628 tok/s y devuelve el primer token de un prompt de 32K en 3.6 s. TensorFold ocupa el segundo lugar con 5,033 tok/s, seguido por vLLM con 3,803, ExLlamaV3 con 3,484 y Qwentin con 2,569. En el caso de agentes de programación que reenvían contextos extensos, NInfer ahorra varios segundos por turno en comparación con todos los demás aquí.
Atender a más de un usuario
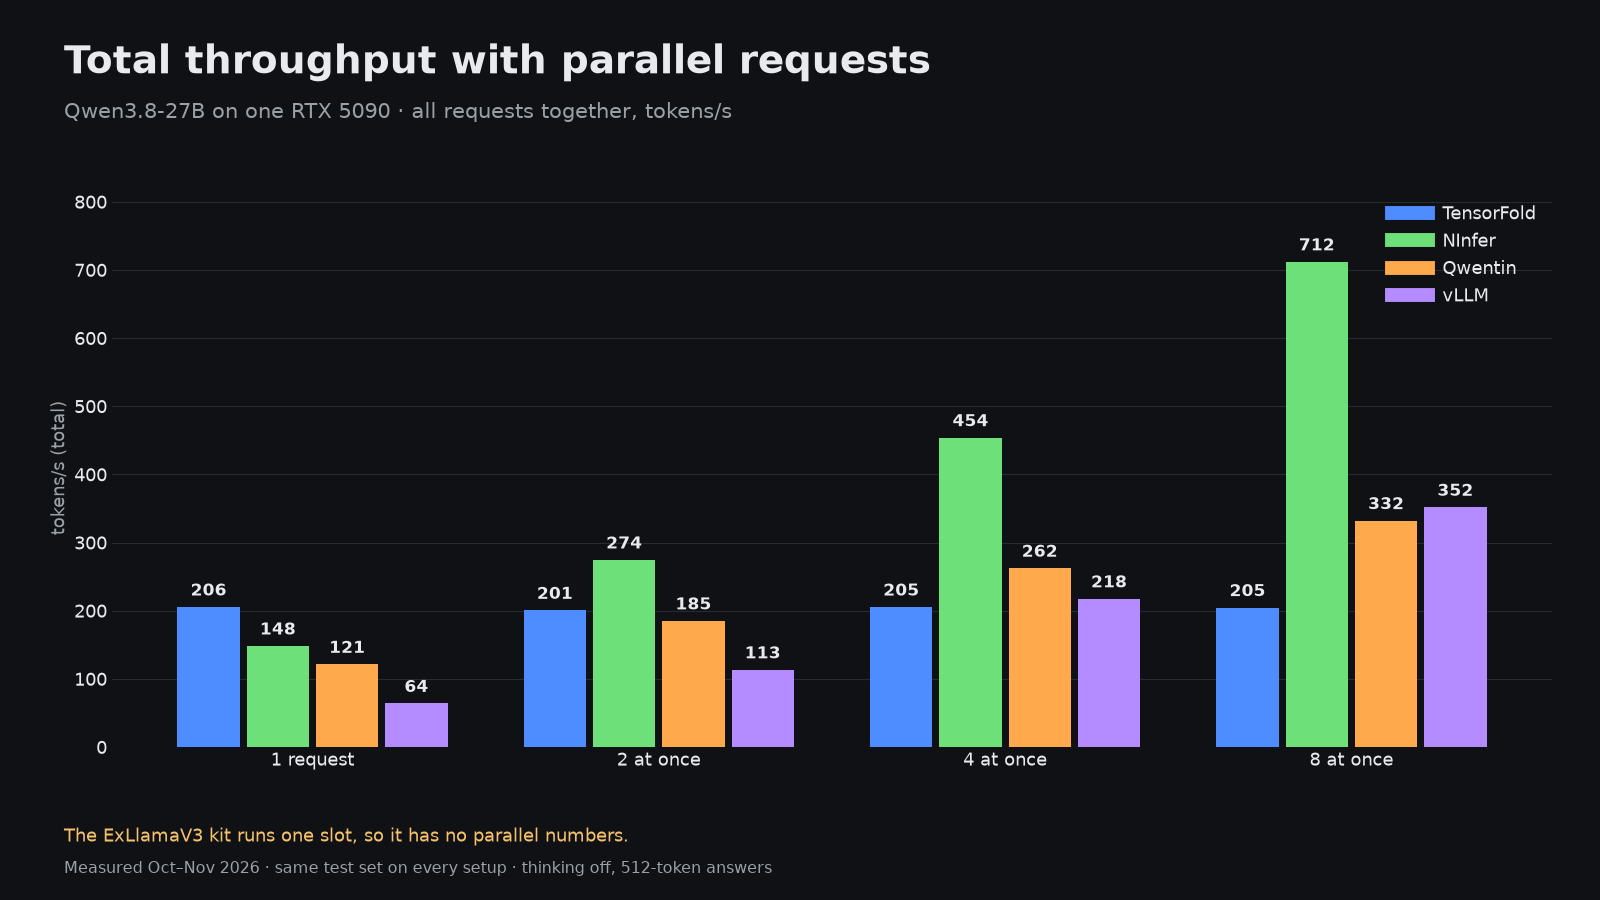
Con ocho solicitudes simultáneas, NInfer alcanza un rendimiento total de 711.9 tok/s, vLLM 351.8 y Qwentin 332.2. TensorFold se mantiene en aproximadamente 204.6 tok/s independientemente del número de solicitudes, mientras que el kit ExLlamaV3 solo puede procesar una solicitud a la vez. Si el sistema sirve a un equipo, varios agentes o un ciclo de evaluación, NInfer es la opción clara; si solo sirve a una persona, TensorFold es la mejor opción.
¿El conjunto rápido da resultados peores?
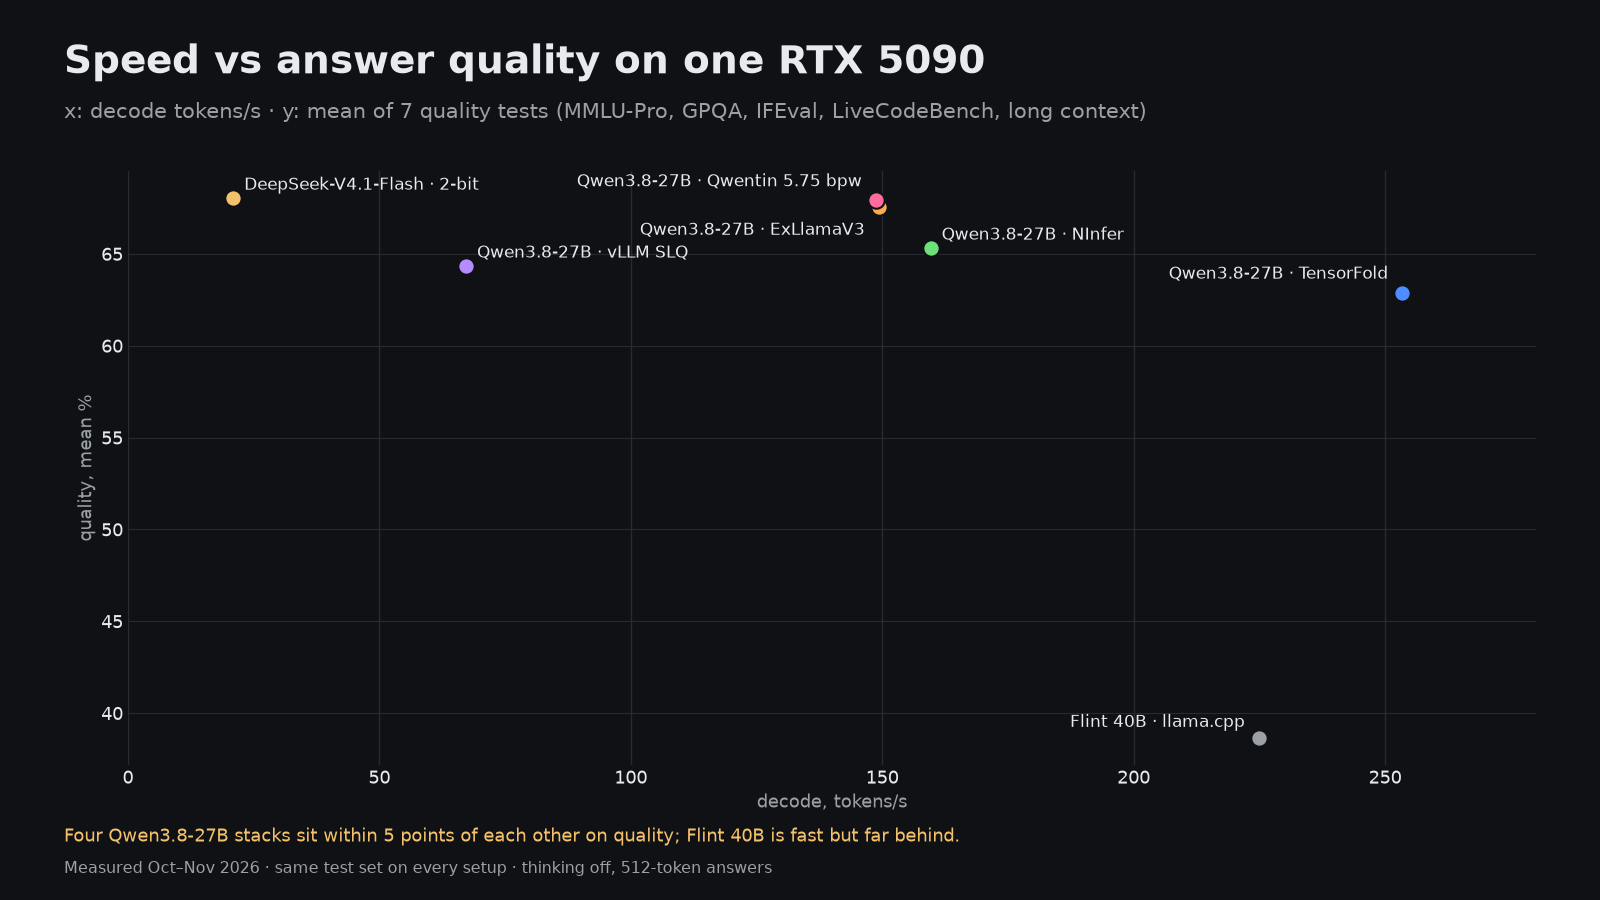
En cierta medida, este gráfico refleja más el nivel de cuantización que las características del motor de procesamiento. La versión Qwentin con 5.75 bpw obtiene la puntuación más alta, con un 67.9 %; le sigue ExLlamaV3 con 4.0 bpw y un 67.6 %; NInfer NVFP4 alcanza el 65.3 %, vLLM SLQ el 64.3 % y TensorFold MLX 4-bit el 62.9 %. Cada prueba presenta diferencias de varios puntos, por lo que las diferencias entre las versiones cercanas se consideran ruido estadístico; la diferencia de 5 puntos de la versión más alta a la más baja es real, pero pequeña en comparación con una diferencia de velocidad de 3.8 veces.
Otros modelos que vale la pena conocer con 32 GB
- Nemotron 3.5 Bolt 74B-A9B en TensorFold decodifica a 242.7 tok/s y procesa prompts de 8K a 11,014 tok/s con 30.2 GiB de memoria. Se ha medido su velocidad pero aún no está clasificado; su promedio de calidad en las pruebas realizadas hasta ahora es del 56.9 %.
- Flint 40B NVFP4 en llama.cpp funciona a 224.9 tok/s con un contexto de 256K, pero su promedio de calidad es solo del 38.6 %.
- DeepSeek-V4.1-Flash, un modelo de 340 GB, se ejecuta en esta tarjeta a través de Project Maya, con la mayor parte de los recursos procesados en 96 GB de RAM y un disco NVMe de 4 TB. Decodifica a 20.9 tok/s y obtiene una puntuación del 68.0 %, la mejor calidad entre todas las configuraciones de 32 GB disponibles. Es lento, pero funciona.
Vídeos e imágenes en la RTX 5090
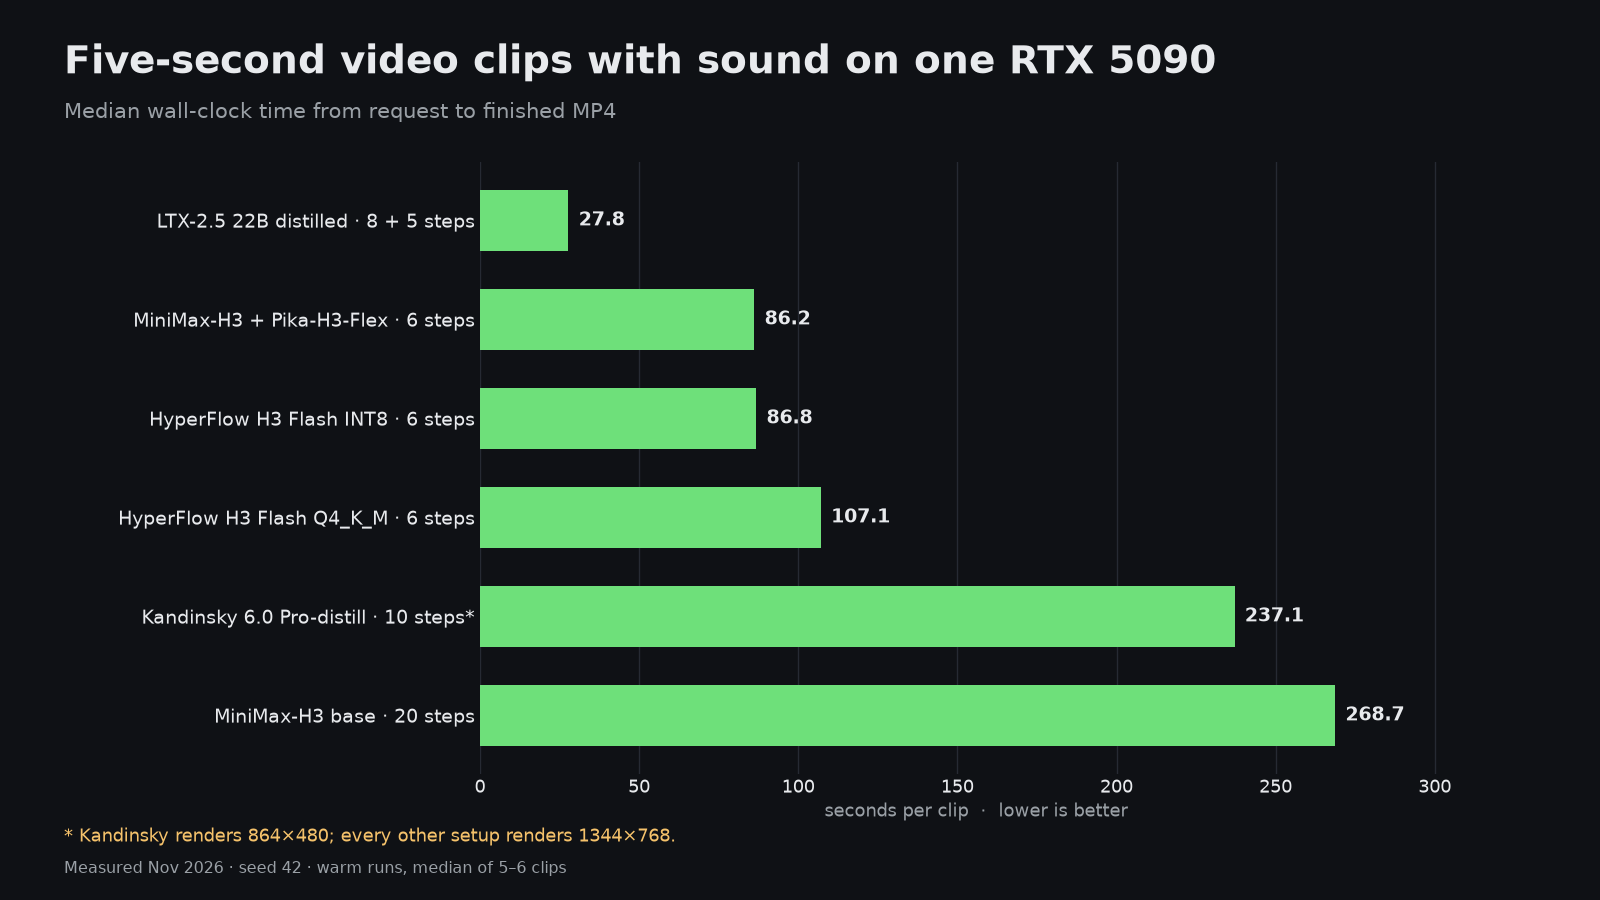
Esta misma tarjeta es una potente solución para videos. LTX-2.5 22B logra procesar un clip de 5 segundos en resolución 1344×768 con sonido en 27.8 s. MiniMax-H3 con la distilación Pika-H3-Flex tarda 86.2 s, HyperFlow H3 Flash INT8 86.8 s, y el modelo base MiniMax-H3 de 20 pasos 268.7 s. En cuanto a imágenes fijas, FLUX Klein necesita 1.96 s por imagen, Qwen-Image 2.1 7.64 s y MOSS 12.81 s.
¿Qué conjunto elegir?
- Un usuario para chat y programación: TensorFold con DFlash2 a 253.4 tok/s y un contexto de 256K.
- Agentes, RAG o varios usuarios: NInfer con NVFP4, con 10,628 tok/s de carga previa y 711.9 tok/s en ocho solicitudes.
- Mejores respuestas a buena velocidad: Qwentin EXL3 5.75 bpw o ExLlamaV3 4.0 bpw, ambos cerca de 150 tok/s con las puntuaciones de calidad más altas.
- Servicio compatible con OpenAI y familiar, sin necesidad de construcción personalizada: vLLM, que acepta unos 67 tok/s por flujo.
- Atención al VRAM: cuatro de los cinco conjuntos alcanzan más de 27 GiB en su punto máximo, así que, si es posible, utilice la GPU integrada del ordenador de escritorio.