Бенчмарки локальних LLM на RTX 5090: той самий Qwen3.8-27B, 67–253 токенів на секунду.
Qwen3.8-27B на одному RTX 5090 за допомогою TensorFold, NInfer, ExLlamaV3, Qwentin та vLLM: декодування, попереднє заповнення, паралельна продуктивність, якість та вибір інструментального комплексу для виконання.
Якщо встановити ту саму модель Qwen3.8-27B на ту саму карту RTX 5090, можна досягти швидкості обробки від 67,2 до 253,4 токенів на секунду. Різниця полягає у двигуні, процедурі квантації та методі спекулятивного декодування. П’ять повних конфігурацій, наведених нижче, були протестовані за допомогою ідентичного обладнання та набору інструментів для оцінки якості, тож порівняння стосується саме програмного забезпечення, а не апаратного.
Карта — це одна RTX 5090 об’ємом 32 ГБ. Швидкість декодування визначається як медіана значень для відповідей довжиною 512 токенів на кодові та прозові запити; час заповнення попередніми даними та час обробки першого токена вимірюються для об’ємів 2K, 8K та 32K токенів; паралельна продуктивність — це загальна кількість токенів на секунду при одночасному обробленні 1, 2, 4 та 8 запитів.
П’ять конфігурацій для однієї моделі
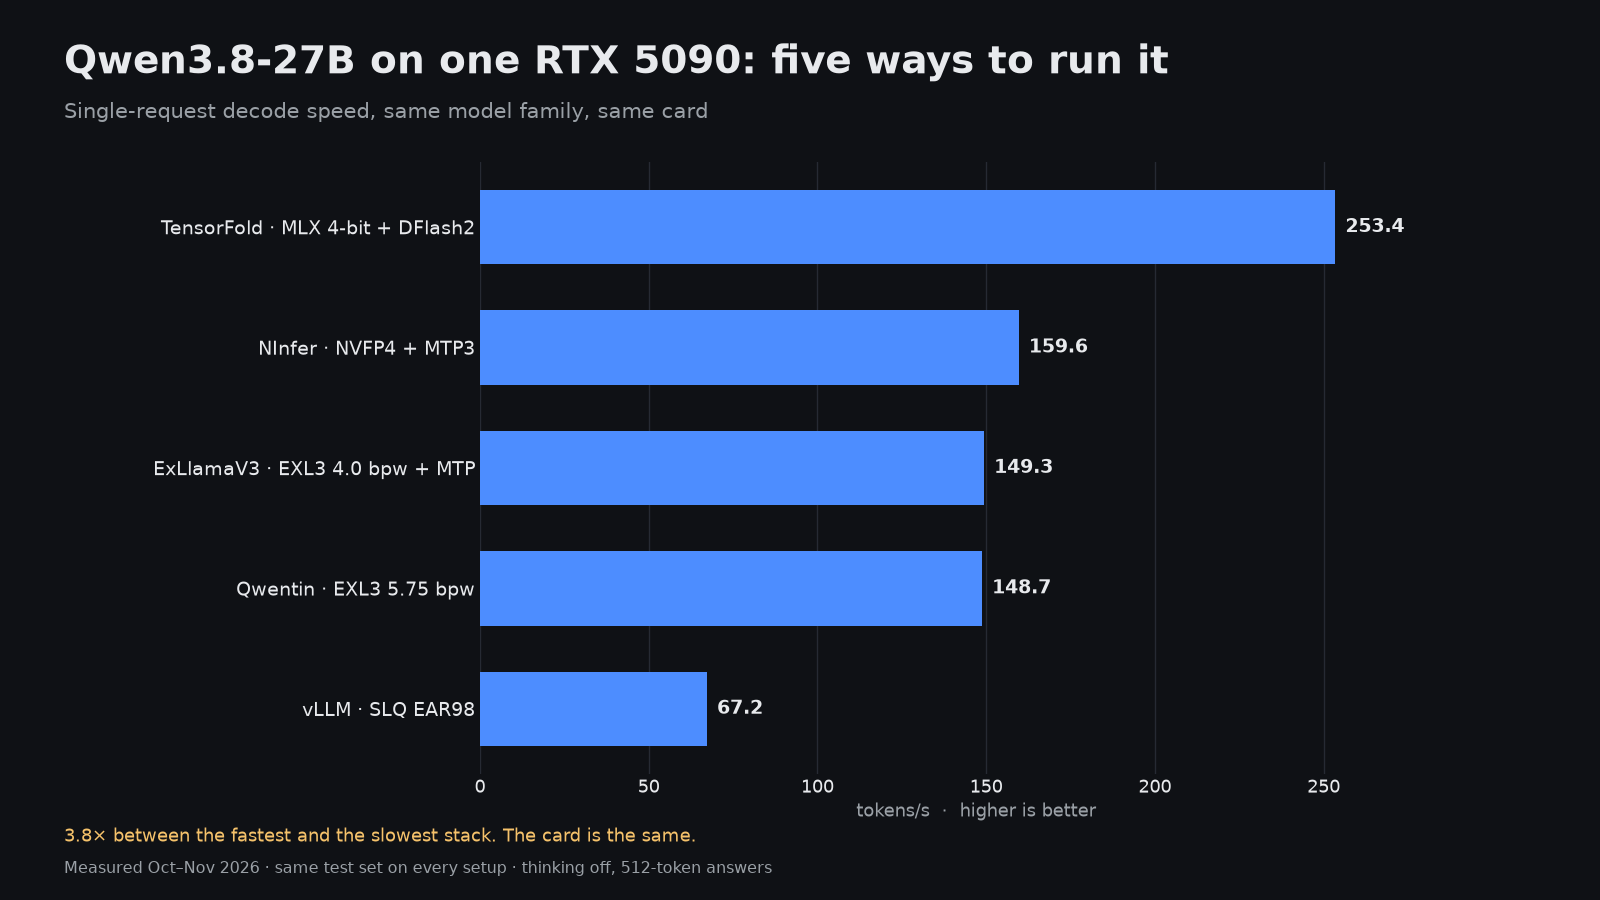
| Інструмент | Квантування | Швидкість декодування, ток/с | Код / проза | Заповнення 8K, ток/с | Перший ток при 32K | Середній рівень якості | Максимальний контекст | Максимальна кількість VRAM |
|---|---|---|---|---|---|---|---|---|
| TensorFold + DFlash2 | MLX 4-біт | 253,4 | 268,2 / 238,7 | 5 033 | 7,7 с | 62,9 % | 256K | 27,3 ГіБ |
| NInfer + MTP3 | NVFP4 | 159,6 | 169.0 / 150.1 | 10,628 | 3.6 с | 65.3 % | 240,000 | 28.9 ГіБ |
| ExLlamaV3 + MTP | EXL3 4.0 bpw | 149.3 | 154.5 / 144.2 | 3,484 | 10.5 с | 67.6 % | 128K | 18.9 ГіБ |
| Qwentin + MTP | EXL3 5.75 bpw | 148.7 | 158.3 / 139.2 | 2,569 | 13.7 с | 67.9 % | 128K | 29.7 ГіБ |
| vLLM, без спекуляцій | SLQ EAR98 | 67.2 | 67.2 / 67.1 | 3,803 | 9.5 с | 64.3 % | 74,752 | 29.5 ГіБ |
Спекулятивне декодування пояснює більшу частину різниці
vLLM запускає цю модель без спекуляцій та досягає швидкості 67,2 ток/с, причому для коду та прози цей показник становить 0,1 ток/с. Це приблизно те, що досягає карта, коли кожен ток проходить через повну модель. Інші чотири системи спочатку генерують токени наперед та перевіряють їх за один прохід, і саме тому швидкість їх роботи в 2–4 рази вища.
Методи відрізняються. NInfer використовує голови MTP3 з додатковою головою lm-head для генерації проєктів та отримує 52,8% прийнятих проєктів. TensorFold використовує окремий механізм DFlash2 для генерації проєктів; лише 20,0% його проєктів приймаються, але кожен прохід перевірки є достатньо дешевим, тому він все одно значно випереджає інші системи у розшифруванні одним потоком. Запити на код працюють швидше, ніж запити на прозу, у всіх системах зі спекуляціями (268,2 проти 238,7 ток/с у TensorFold), оскільки код є більш передбачуваним, а проєкти генеруються частіше.
Prefill розповідає іншу історію
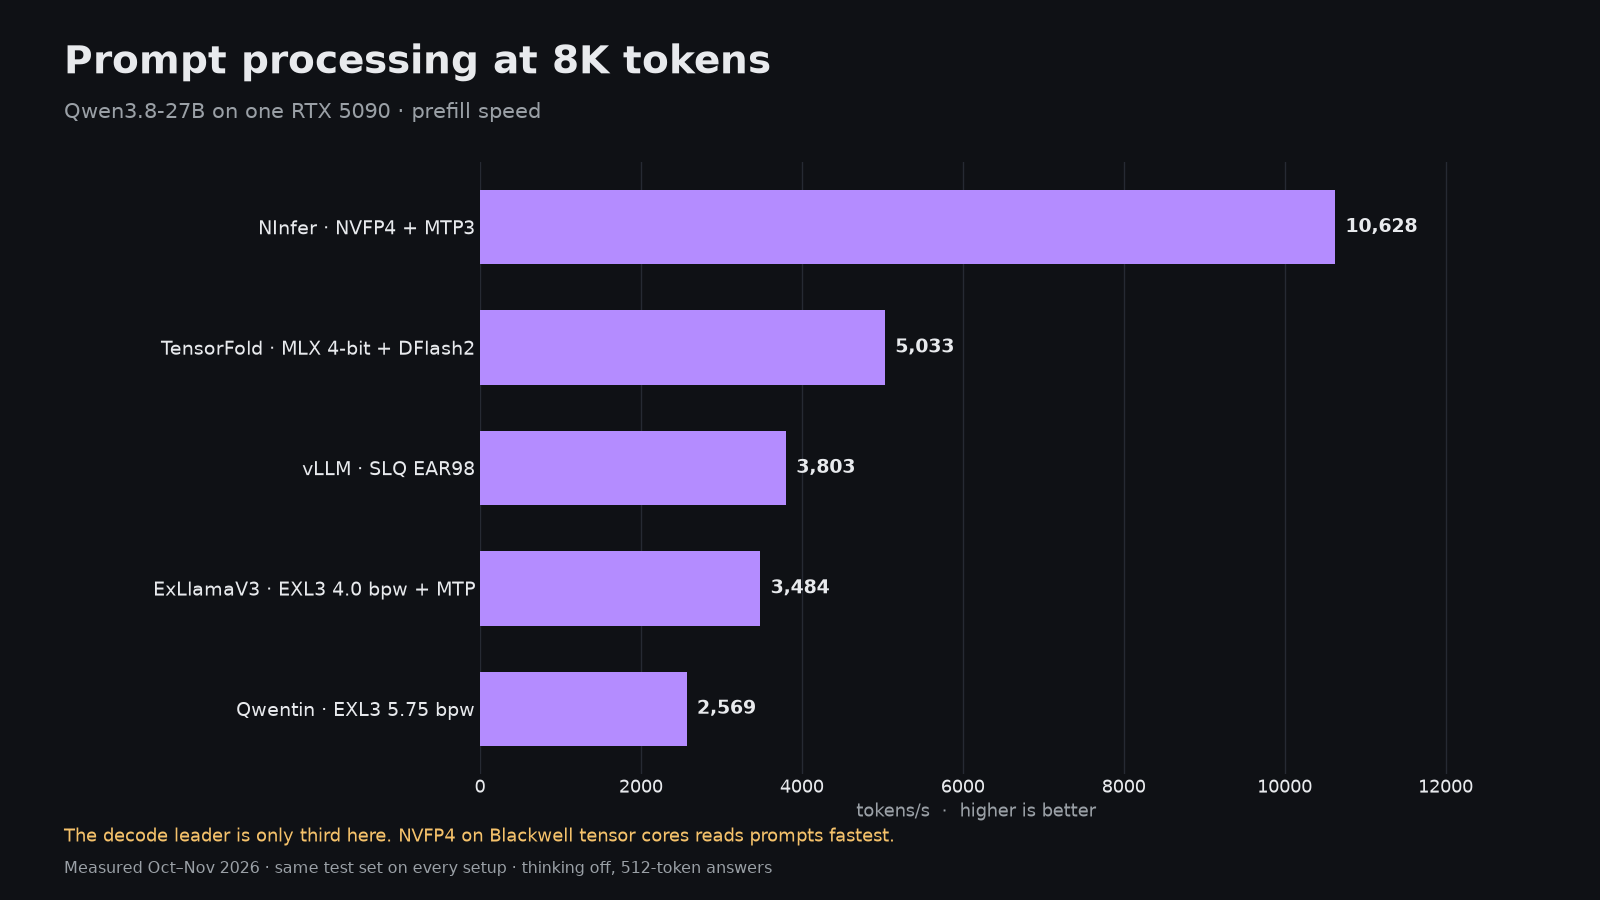
Якщо сортувати за швидкістю обробки запитів, порядок змінюється. NInfer з технологією NVFP4 обробляє 8K-запит зі швидкістю 10,628 токенів/с та повертає перший токен 32K-запиту за 3,6 секунди. TensorFold посідає друге місце зі швидкістю 5,033 токенів/с, далі йдуть vLLM зі швидкістю 3,803 токенів/с, ExLlamaV3 зі швидкістю 3,484 токенів/с та Qwentin зі швидкістю 2,569 токенів/с. Для агентів з кодуванням, які пересилають великі обсяги контексту, NInfer економить кілька секунд на кожен крок порівняно з усіма іншими засобами тут.
Обслуговування кількох користувачів
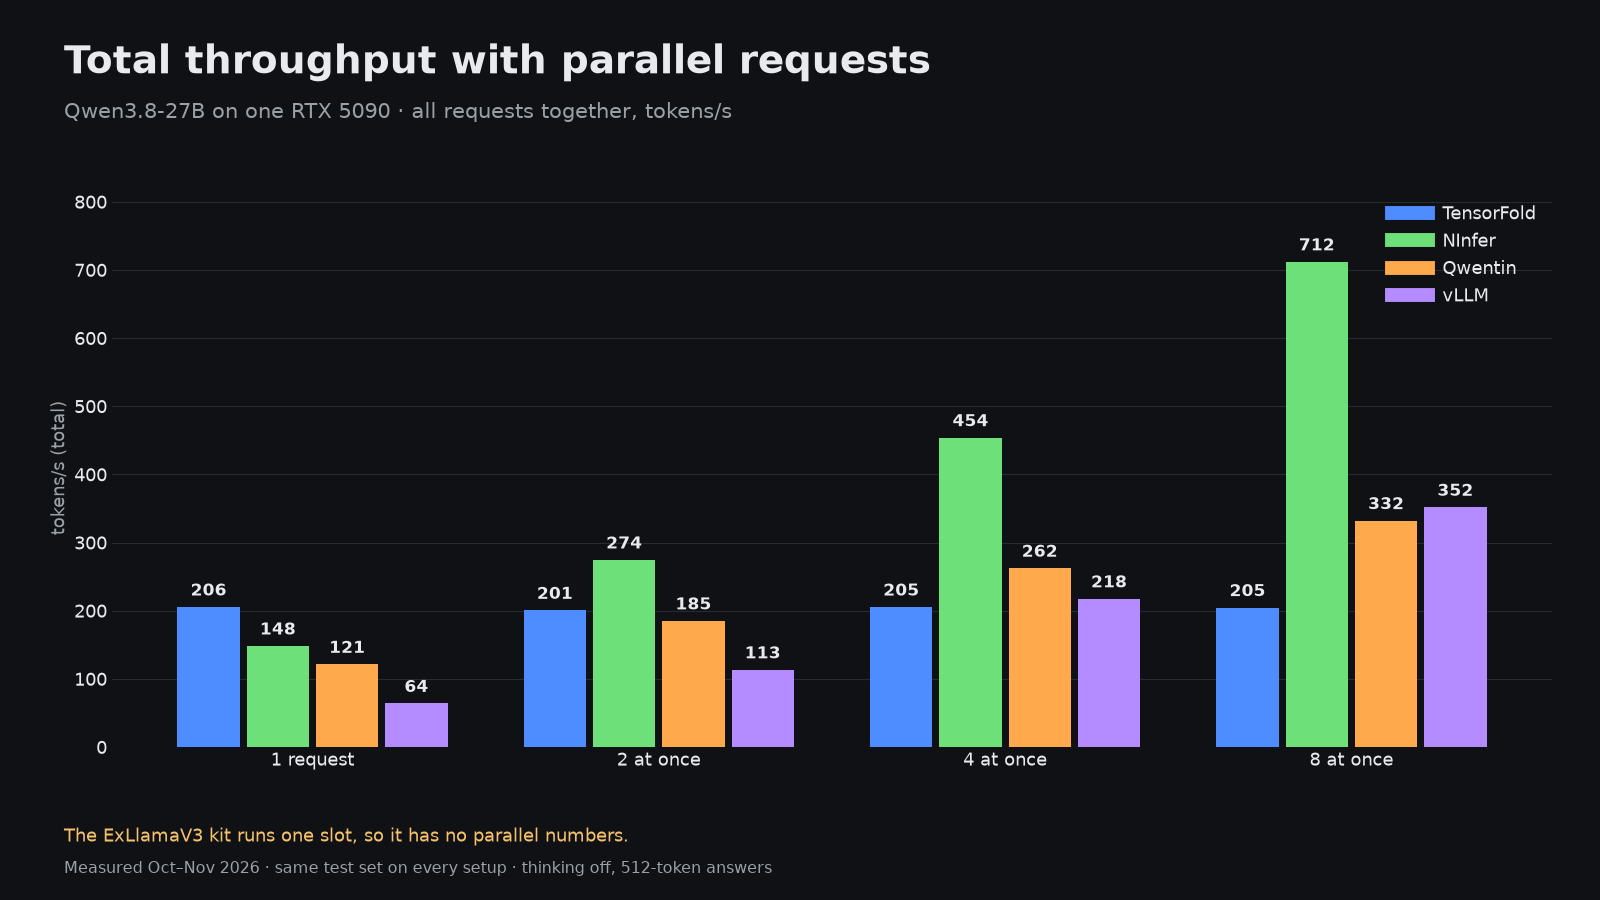
При восьми одночасних запитах NInfer досягає загальної пропускної здатності 711,9 ток/с, vLLM — 351,8, а Qwentin — 332,2. TensorFold ж залишається на рівні близько 204,6 ток/с незалежно від кількості запитів, а набір ExLlamaV3 обробляє лише один запит. Якщо система призначена для команди, кількох агентів чи циклу оцінки, NInfer є очевидним вибором; якщо ж вона призначена для однієї особи, то краще обрати TensorFold.
Чи погіршує швидкий стек результати?
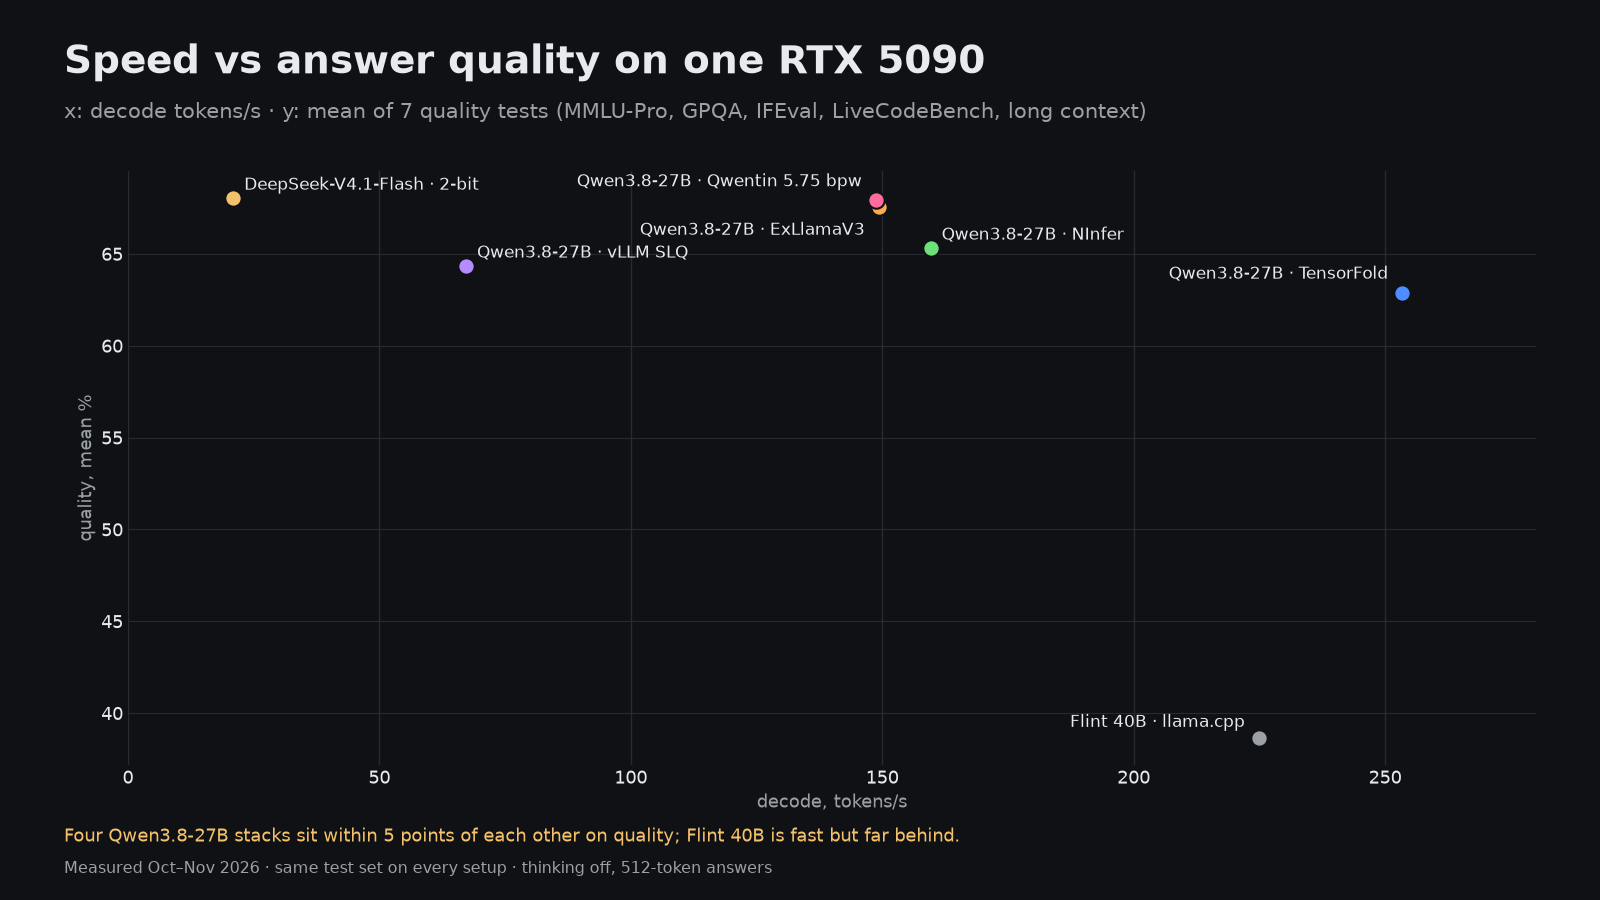
Цей показник більше відображає рівень квантування, ніж характеристики самого двигуна обробки. Версія Qwentin із коефіцієнтом 5,75 bpw досягає найвищого рівня — 67,9%, за нею йде ExLlamaV3 із коефіцієнтом 4,0 bpw з показником 67,6%, NInfer NVFP4 — 65,3%, vLLM SLQ — 64,3%, а TensorFold MLX 4-bit — 62,9%. Окремі тести мають різницю у кілька пунктів, тож розбіжності між сусідніми показниками є результатом варіацій; різниця у 5 пунктів від найвищого до найнижчого показника є реальною, але незначною порівняно з різницею у швидкості у 3,8 рази.
Інші моделі, які варто знати для 32 ГБ
- Nemotron 3.5 Bolt 74B-A9B у TensorFold декодує зі швидкістю 242,7 ток/с та читає запити розміром 8K зі швидкістю 11 014 ток/с при використанні 30,2 ГБ пам’яті. Його оцінюють за швидкістю, але ще не встановлено рейтинг; середній показник якості за проведені тести становить 56,9 %.
- Flint 40B NVFP4 у llama.cpp працює зі швидкістю 224,9 ток/с при контексті обсягом 256 КБ, але середній показник якості становить лише 38,6 %.
- DeepSeek-V4.1-Flash — модель обсягом 340 ГБ — працює на цій відеокарті через Project Maya, причому більшість елементів обробки перенесені на 96 ГБ оперативної пам’яті та 4 ТБ диска NVMe. Він декодує зі швидкістю 20,9 ток/с та досягає показника 68,0 %, що є найкращим показником якості серед усіх конфігурацій обсягом 32 ГБ. Швидкість низька, але функціонує.
Відео та зображення на RTX 5090
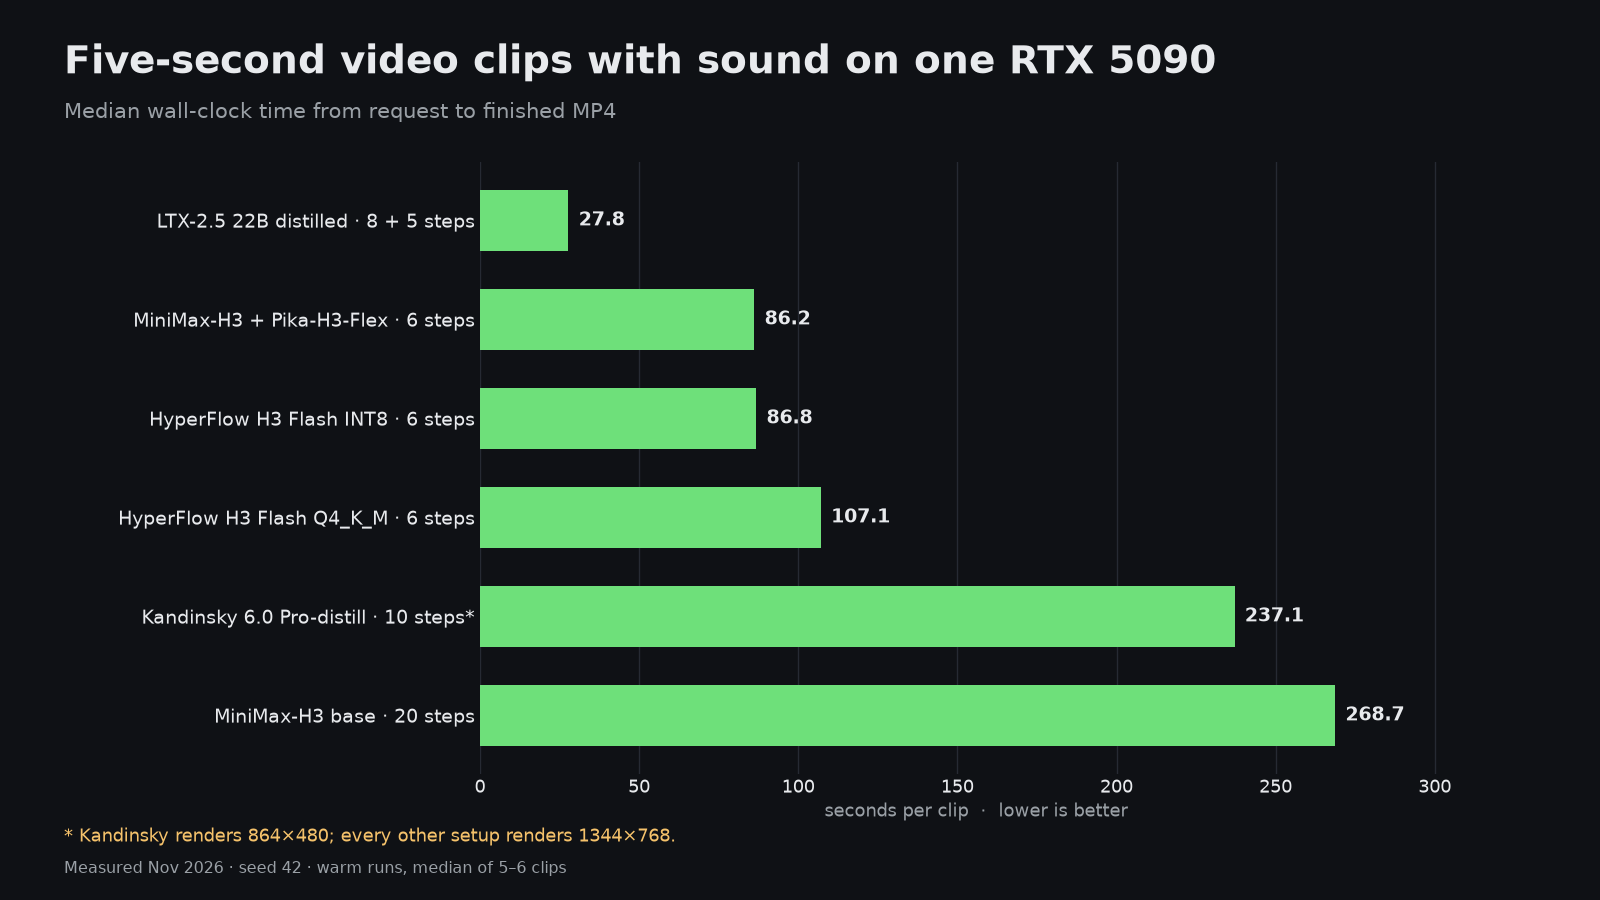
Ця ж відеокарта є потужним інструментом для обробки відео. LTX-2.5 22B завершує обробку 5-секундного кліпу у форматі 1344×768 з звуком за 27,8 секунди. MiniMax-H3 з технологією Pika-H3-Flex потребує 86,2 секунди, HyperFlow H3 Flash INT8 — 86,8 секунди, а базова версія MiniMax-H3 з 20 кроками обробки — 268,7 секунди. Для статичних зображень FLUX Klein потребує 1,96 секунди на зображення, Qwen-Image 2.1 — 7,64 секунди, а MOSS — 12,81 секунди.
Який набір обрати
- Для одного користувача, чату та програмування: TensorFold з DFlash2 зі швидкістю обробки 253,4 токена/с та контекстом обсягом 256 Кб.
- Агенти, RAG або кілька користувачів: NInfer з NVFP4 — 10 628 токів/с під час попереднього заповнення та 711,9 токів/с при виконанні восьми запитів.
- Найкращі відповіді з хорошою швидкістю: Qwentin EXL3 5,75 бп/с або ExLlamaV3 4,0 бп/с; обидва досягають майже 150 токів/с та мають найвищі оцінки якості.
- Знайомий формат роботи, сумісний з OpenAI, без необхідності створення власної версії: vLLM, який підтримує приблизно 67 токів/с на потік.
- Стежте за VRAM: чотири з п’яти систем досягають піку понад 27 ГБ, тому, якщо можливо, використовуйте інтегровану відеокарту на десктопі.