Tests de performance des LLM locaux sur RTX 5090 : même Qwen3.8-27B, de 67 à 253 tokens par seconde.
Qwen3.8-27B sur une RTX 5090 via TensorFold, NInfer, ExLlamaV3, Qwentin et vLLM : décodage, préremplissage, débit en parallèle, qualité et choix du stack à utiliser.
En utilisant le même Qwen3.8-27B sur la même RTX 5090, on peut obtenir des performances allant de 67,2 à 253,4 tokens par seconde. La différence réside dans le moteur, la quantification et la méthode de décodage spéculatif associée. Les cinq configurations présentées ci-dessous ont été mesurées avec un ensemble d’équipements et de critères de qualité identiques, ce qui permet de comparer uniquement la pile logicielle et non le matériel.
La carte est une RTX 5090 32 GB unique. Le décodage correspond à la médiane des réponses de 512 tokens obtenues pour des prompts en code et en prose ; le temps de préremplissage et celui du premier token sont mesurés pour 2 K, 8 K et 32 K tokens ; la capacité de traitement en parallèle correspond au nombre total de tokens par seconde générés pour 1, 2, 4 et 8 requêtes simultanées.
Cinq configurations pour un même modèle
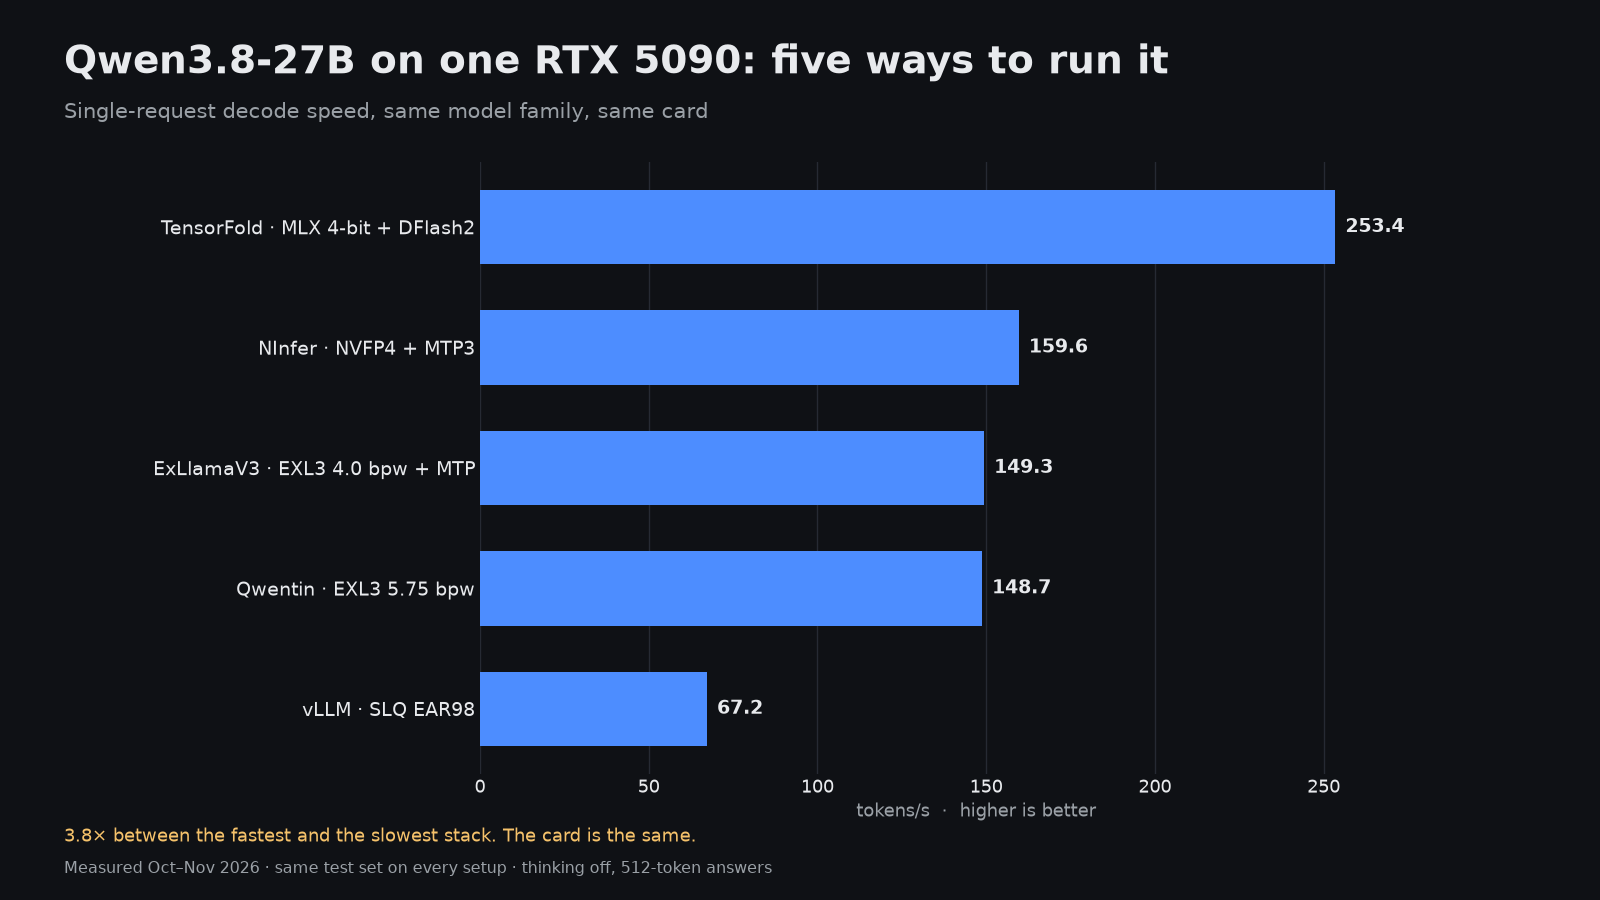
| Moteur | Quantification | Décodage, tok/s | Code / prose | Prefill 8K, tok/s | Premier token à 32K | Moyenne de qualité | Contexte maximal | VRAM maximale |
|---|---|---|---|---|---|---|---|---|
| TensorFold + DFlash2 | MLX 4-bit | 253,4 | 268,2 / 238,7 | 5 033 | 7,7 s | 62,9 % | 256K | 27,3 GiB |
| NInfer + MTP3 | NVFP4 | 159,6 | 169,0 / 150,1 | 10 628 | 3,6 s | 65,3 % | 240 000 | 28,9 GiB |
| ExLlamaV3 + MTP | EXL3 4,0 bpw | 149,3 | 154,5 / 144,2 | 3 484 | 10,5 s | 67,6 % | 128 K | 18,9 GiB |
| Qwentin + MTP | EXL3 5,75 bpw | 148,7 | 158,3 / 139,2 | 2 569 | 13,7 s | 67,9 % | 128 K | 29,7 GiB |
| vLLM, sans spéculation | SLQ EAR98 | 67,2 | 67,2 / 67,1 | 3 803 | 9,5 s | 64,3 % | 74 752 | 29,5 GiB |
La décodage spéculatif explique la majeure partie de l’écart
vLLM exécute ce modèle sans spéculations et atteint 67,2 tok/s, avec un temps de traitement pour le code et la prose autour de 0,1 tok/s. C’est à peu près ce que fait la carte lorsque chaque token est traité par le modèle complet. Les quatre autres méthodes préparent d’abord les tokens en avance puis les vérifient en une seule passe, ce qui explique l’augmentation de 2 à 4 fois du rendement.
Les méthodes diffèrent. NInfer utilise des têtes MTP3 avec une étape supplémentaire de préparation avec lm-head, et 52,8 % des propositions générées sont acceptées. TensorFold emploie un outil de préparation DFlash2 distinct ; seuls 20,0 % de ses propositions sont acceptés, mais chaque passe de vérification étant suffisamment rapide, il gagne néanmoins de loin dans le décodage en flux unique. Les prompts de code sont plus rapides que ceux de prose avec toutes les méthodes spéculatives (268,2 contre 238,7 tok/s sur TensorFold), car le code est plus prévisible et les propositions correctes apparaissent plus fréquemment.
Prefill raconte une histoire différente
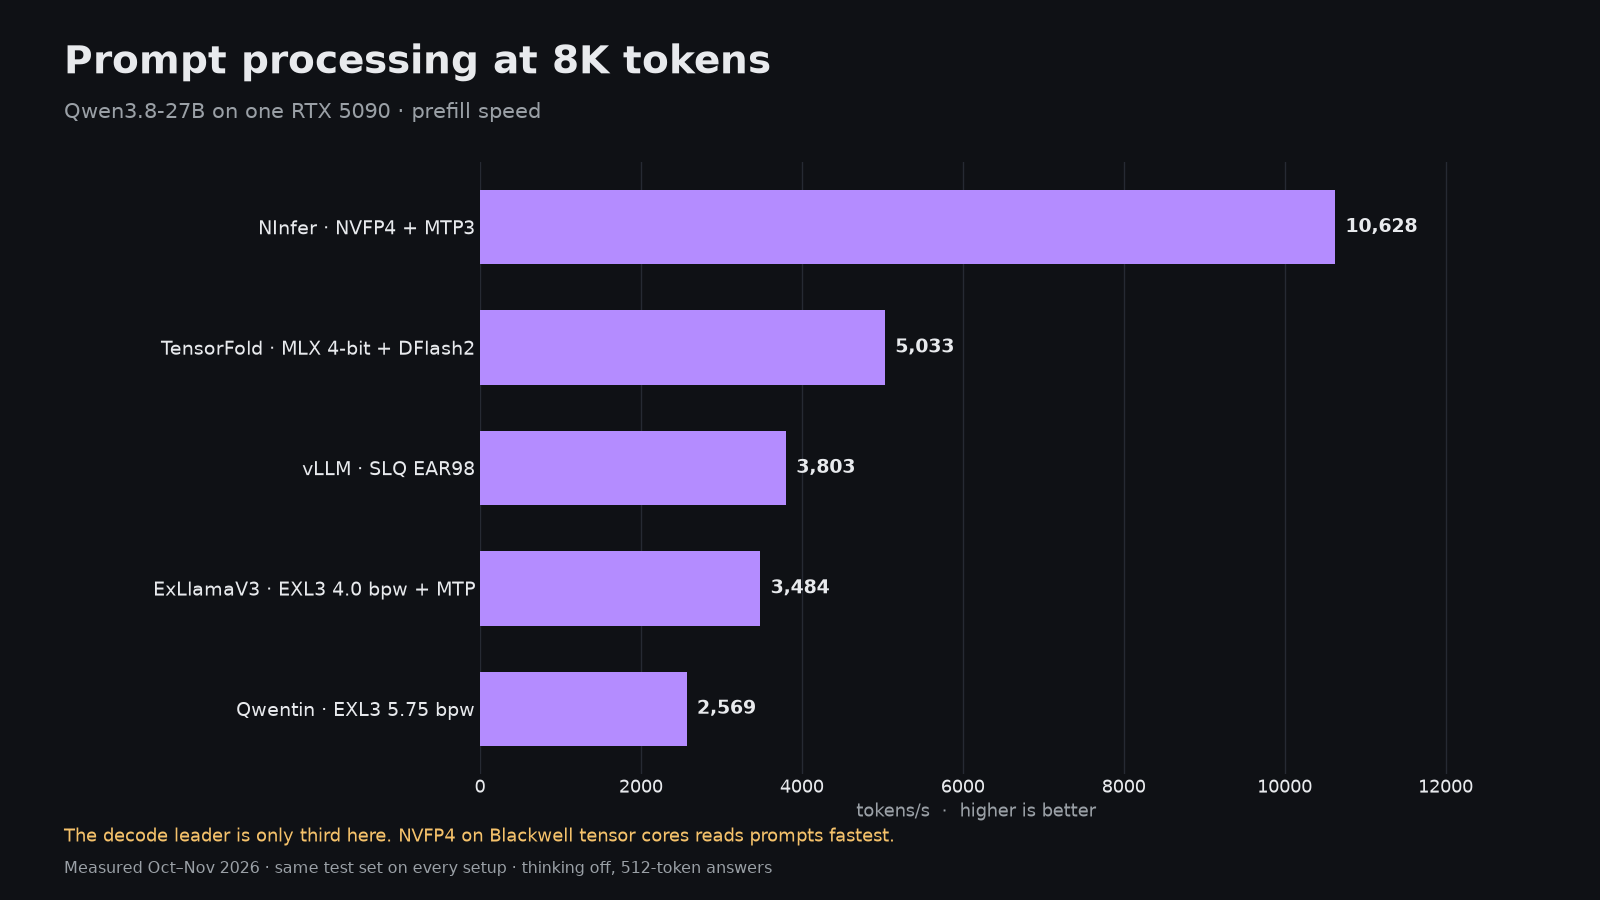
Lorsque le classement se fait selon la vitesse de traitement des prompts, l’ordre change. NInfer avec NVFP4 traite un prompt de 8K à 10 628 tok/s et restitue le premier token d’un prompt de 32K en 3,6 s. TensorFold arrive en deuxième position avec 5 033 tok/s, suivi de vLLM à 3 803, d’ExLlamaV3 à 3 484 et de Qwentin à 2 569. Pour les agents de codage qui renvoient des contextes volumineux, NInfer gagne plusieurs secondes par tour par rapport aux autres solutions ici présentes.
Fournir des services à plusieurs utilisateurs
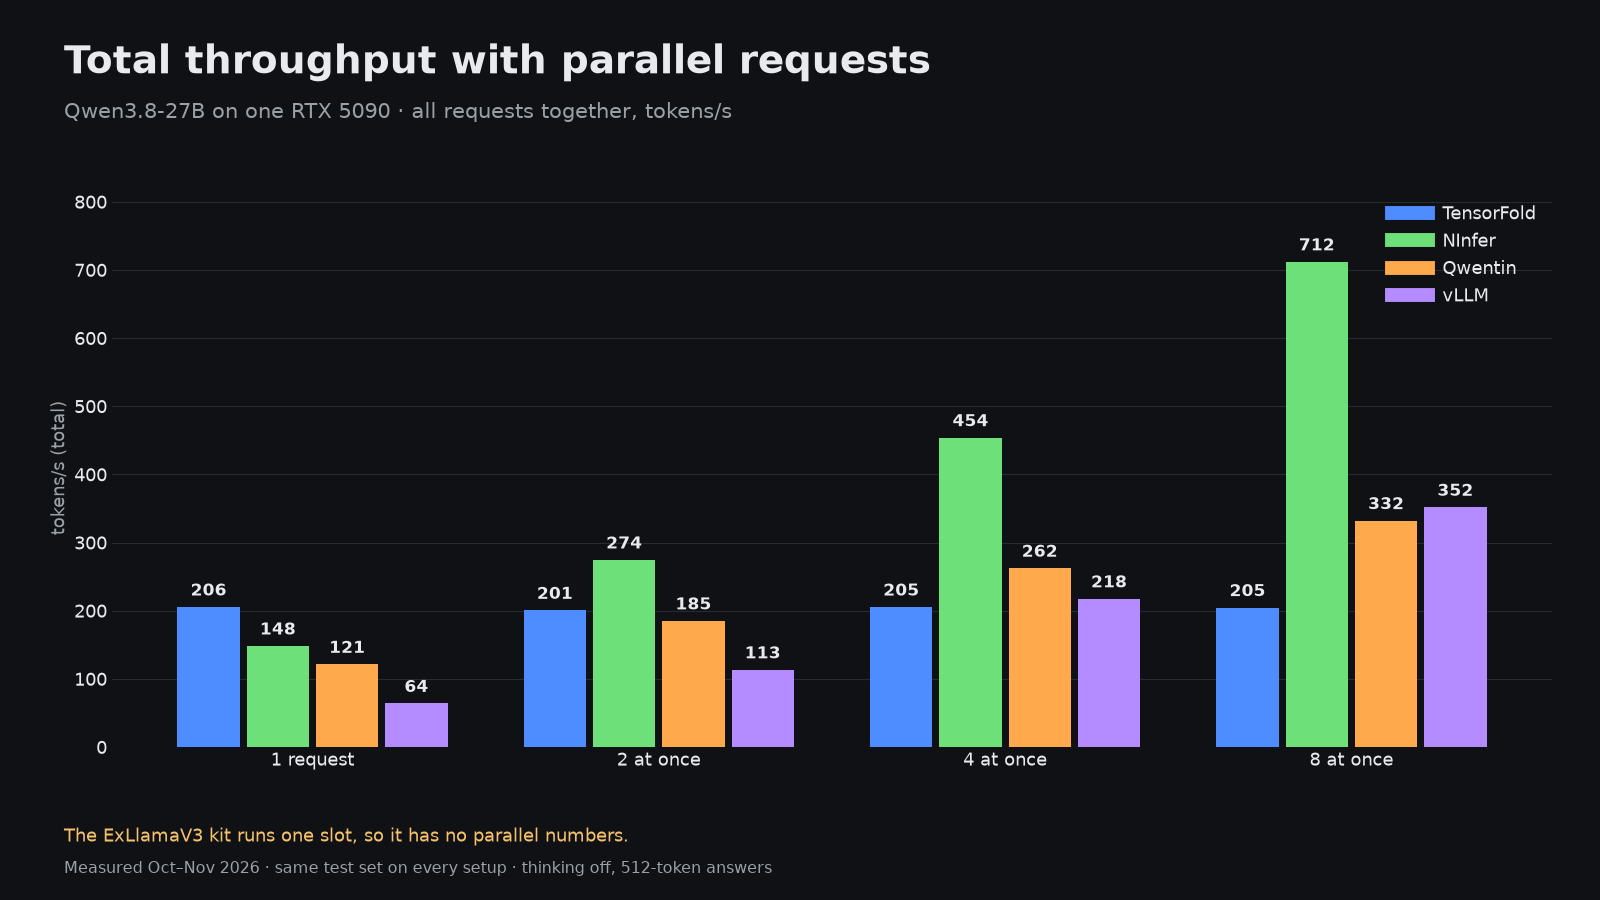
Avec huit requêtes simultanées, NInfer atteint un débit total de 711,9 tok/s, vLLM 351,8 et Qwentin 332,2. TensorFold reste autour de 204,6 tok/s quel que soit le nombre de requêtes, tandis que le kit ExLlamaV3 ne gère qu’une seule requête à la fois. Si l’outil sert une équipe, plusieurs agents ou un cycle d’évaluation, NInfer est clairement le choix idéal ; s’il sert une seule personne, c’est TensorFold.
Le stack rapide donne-t-il de moins bons résultats ?
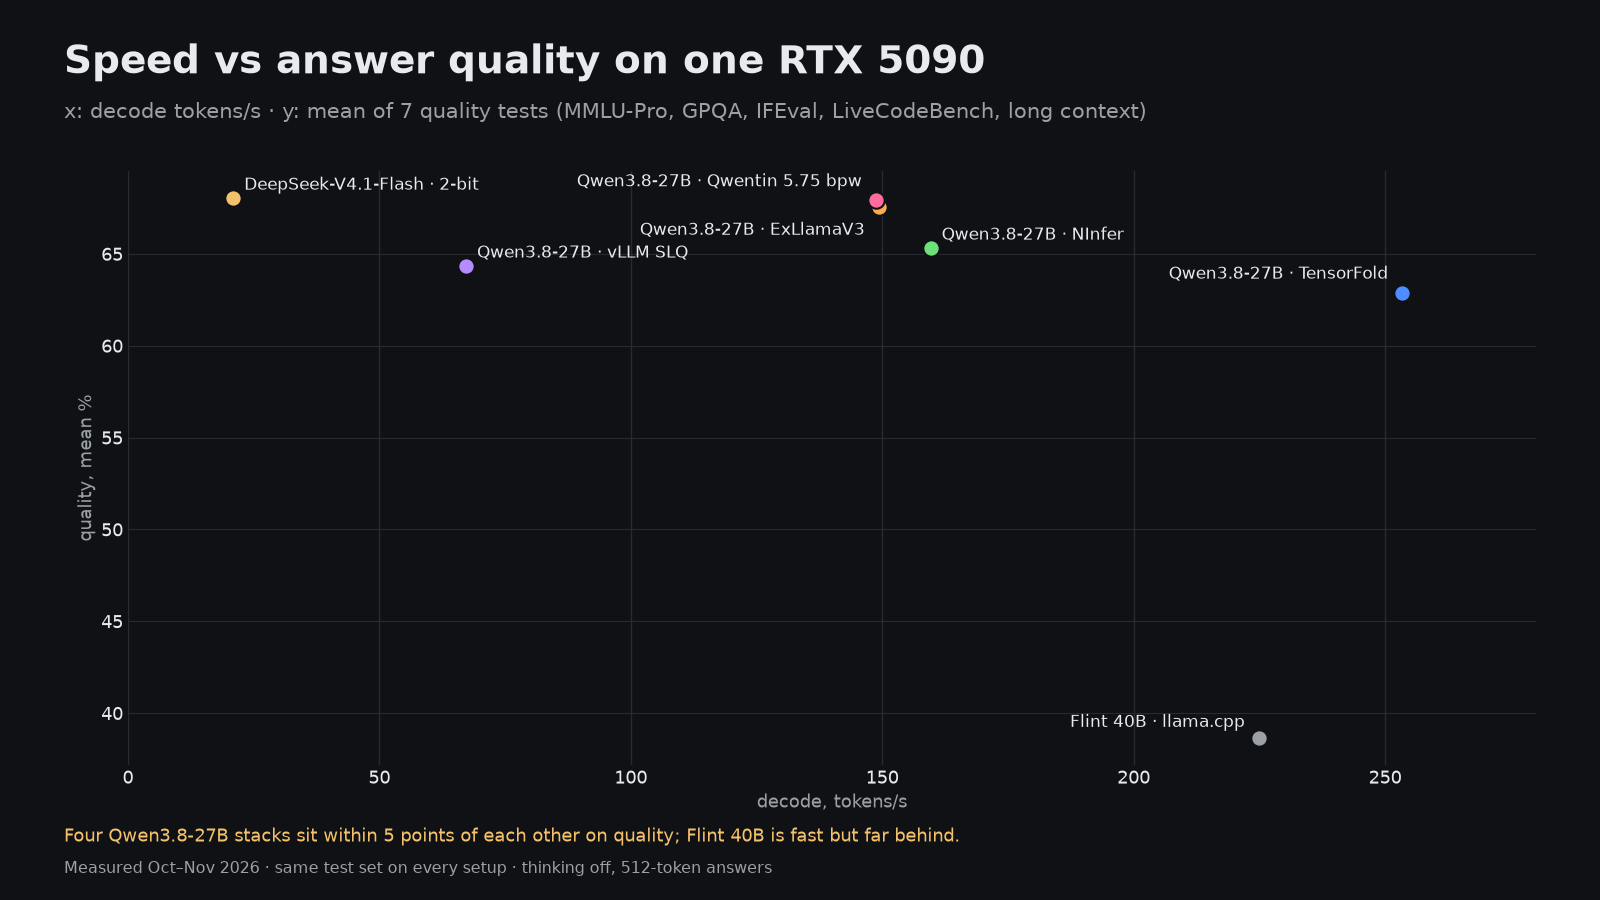
Il prend en compte davantage le niveau de quantification que le moteur lui-même. La version Qwentin avec 5,75 bpw obtient le meilleur score à 67,9 %, suivie par ExLlamaV3 avec 4,0 bpw à 67,6 %, NInfer NVFP4 à 65,3 %, vLLM SLQ à 64,3 % et TensorFold MLX 4-bit à 62,9 %. Chaque test présente des écarts de plusieurs points, de sorte que les différences entre les versions voisines relèvent du bruit statistique ; l’écart de 5 points du meilleur au pire est réel mais faible par rapport à une différence de vitesse de 3,8 fois.
Autres modèles à connaître pour 32 GB
- Nemotron 3.5 Bolt 74B-A9B dans TensorFold décode à 242,7 tok/s et lit des prompts de 8K à 11 014 tok/s avec 30,2 GiB de mémoire. Sa vitesse a été mesurée mais il n’a pas encore été classé ; sa moyenne de qualité sur les tests réalisés jusqu’à présent est de 56,9 %.
- Flint 40B NVFP4 dans llama.cpp fonctionne à 224,9 tok/s avec un contexte de 256 K, mais sa moyenne de qualité n’est que de 38,6 %.
- DeepSeek-V4.1-Flash, un modèle de 340 GB, s’exécute sur cette carte via Project Maya, la plupart des composants étant déplacés vers 96 GB de RAM et un disque NVMe de 4 TB. Il décode à 20,9 tok/s et obtient un score de 68,0 %, ce qui représente la meilleure qualité parmi toutes les configurations de 32 GB ici. C’est lent, mais ça fonctionne.
Vidéos et images sur la RTX 5090
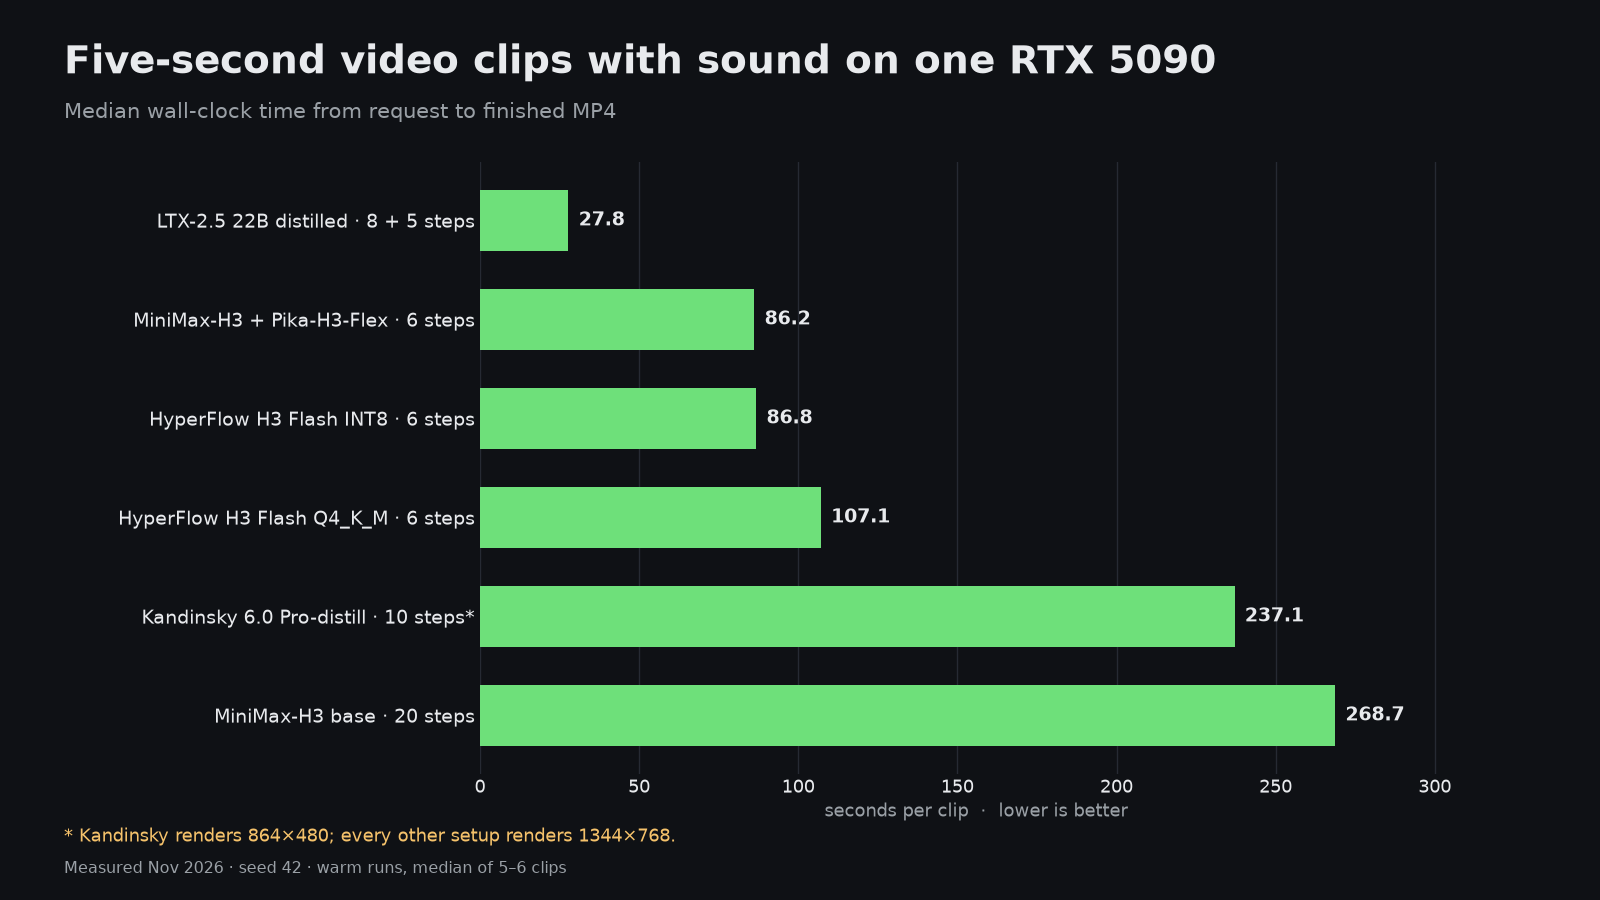
Cette même carte constitue un véritable outil de traitement vidéo performant. LTX-2.5 22B, après distillation, termine la génération d’un extrait vidéo de 5 secondes en 1344×768 avec son en 27,8 s. MiniMax-H3 avec la distillation Pika-H3-Flex met 86,2 s, HyperFlow H3 Flash INT8 86,8 s, et le modèle de base MiniMax-H3 à 20 étapes 268,7 s. Pour les images statiques, FLUX Klein nécessite 1,96 s par image, Qwen-Image 2.1 7,64 s et MOSS 12,81 s.
Quel ensemble choisir ?
- Un utilisateur pour le chat et la programmation : TensorFold avec DFlash2, à 253,4 tok/s et avec un contexte de 256 K.
- Agents, RAG ou plusieurs utilisateurs : NInfer avec NVFP4, atteignant 10 628 tok/s pour le préremplissage et 711,9 tok/s sur huit requêtes.
- Melhores réponses à une bonne vitesse : Qwentin EXL3 à 5,75 bpw ou ExLlamaV3 à 4,0 bpw, tous deux proches de 150 tok/s avec les meilleures notes de qualité.
- Servir compatible OpenAI et familier, sans nécessité de construction personnalisée : vLLM, capable d’accepter environ 67 tok/s par flux.
- Surveillez la VRAM : quatre des cinq configurations atteignent plus de 27 GiB en pic, donc utilisez la carte graphique intégrée de l’ordinateur de bureau si possible.