Testy lokalnych modeli LLM na RTX 5090: ten sam Qwen3.8-27B, od 67 do 253 tokenów na sekundę.
Qwen3.8-27B na jednym RTX 5090 przy użyciu TensorFold, NInfer, ExLlamaV3, Qwentin i vLLM: dekodowanie, wypełnianie danych z góry, przepustowość równoległa, jakość oraz wybór odpowiedniego zestawu narzędzi do uruchomienia.
Jeśli zainstalujesz ten sam Qwen3.8-27B na tym samym RTX 5090, uzyskasz prędkość od 67,2 do 253,4 tokenów na sekundę. Różnica wynika z silnika, metody kwantyzacji oraz sposobu dekodowania. Poniżej przedstawiono pięć kompletnych konfiguracji zmierzonych za pomocą identycznego zestawu narzędzi i standardów jakości, dzięki czemu porównanie dotyczy wyłącznie oprogramowania, a nie sprzętu.
Karta to pojedynczy RTX 5090 o pojemności 32 GB. Dekodowanie odbywa się na podstawie mediany wyników dla 512 tokenów w przypadku zadań tekstowych i prozatorskich; czas wypełniania danych i czas generowania pierwszego tokena mierzony jest przy ilości tokenów 2K, 8K i 32K; prędkość przetwarzania równoległego to łączna liczba tokenów na sekundę przy 1, 2, 4 i 8 jednoczesnych zapytaniach.
Pięć rozwiązań dla jednego modelu
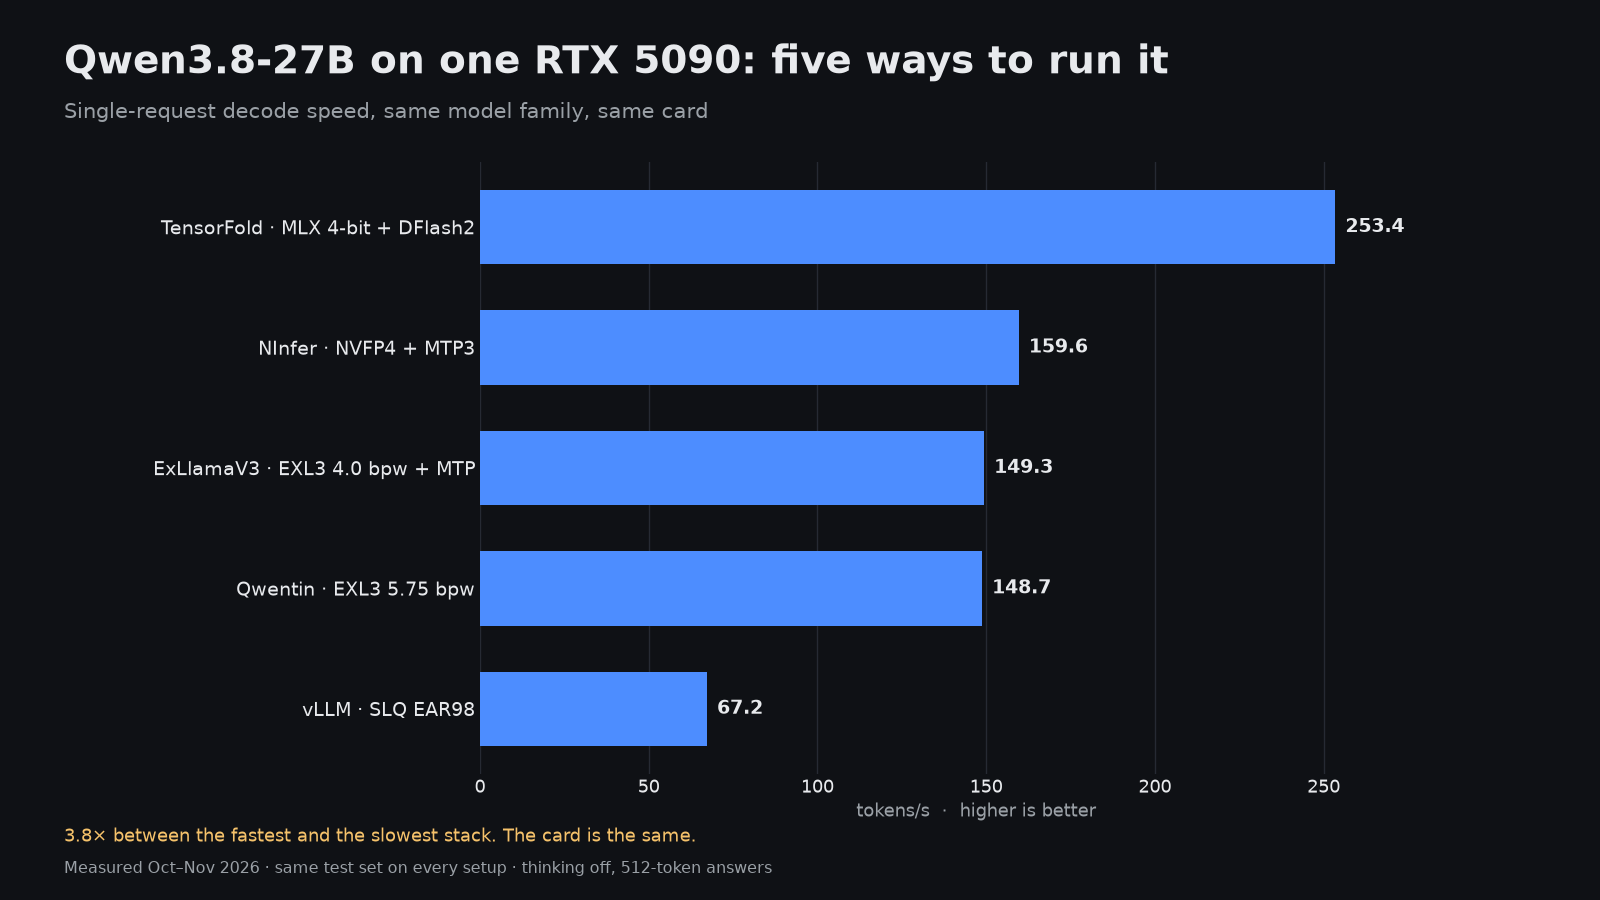
| Narzędzie | Quantyzacja | Szybkość dekodowania, tok/s | Kod / proza | Prefill 8K, tok/s | Pierwszy token przy 32K | Średnia jakość | Największy kontekst | Maksymalna ilość VRAM |
|---|---|---|---|---|---|---|---|---|
| TensorFold + DFlash2 | MLX 4-bit | 253,4 | 268,2 / 238,7 | 5 033 | 7,7 s | 62,9 % | 256K | 27,3 GiB |
| NInfer + MTP3 | NVFP4 | 159,6 | 169,0 / 150,1 | 10 628 | 3,6 s | 65,3 % | 240 000 | 28,9 GiB |
| ExLlamaV3 + MTP | EXL3 4,0 bpw | 149,3 | 154,5 / 144,2 | 3 484 | 10,5 s | 67,6 % | 128K | 18,9 GiB |
| Qwentin + MTP | EXL3 5,75 bpw | 148,7 | 158,3 / 139,2 | 2 569 | 13,7 s | 67,9 % | 128K | 29,7 GiB |
| vLLM, bez spekulacji | SLQ EAR98 | 67,2 | 67,2 / 67,1 | 3 803 | 9,5 s | 64,3 % | 74 752 | 29,5 GiB |
Spekulatywne dekodowanie wyjaśnia większość różnicy
vLLM uruchamia ten model bez spekulacji i osiąga prędkość 67,2 tok/s, przy czym kod i proza przekraczają ten poziom o zaledwie 0,1 tok/s. To mniej więcej tyle, ile potrafi karta, gdy każdy token przechodzi przez cały model. Pozostałe cztery rozwiązania tworzą wstępne wersje tokenów z góry i weryfikują je za jednym razem, stąd różnica 2× do 4× w prędkości.
Metody się różnią. NInfer wykorzystuje głowy MTP3 z dodatkową głową do tworzenia wstępnych wersji i uzyskuje 52,8% przyjętych wstępnych wersji tokenów. TensorFold używa oddzielnego narzędzia DFlash2 do tworzenia wstępnych wersji; przyjmuje ono jedynie 20,0% takich wstępnych wersji, ale każda faza weryfikacji jest na tyle tania, że nadal wygrywa w dekodowaniu jednoprzepływowym z dużą przewagą. Prompty kodowe są szybsze od tekstów prozatorskich we wszystkich rozwiązaniach opartych na spekulacjach (268,2 vs 238,7 tok/s w przypadku TensorFold), ponieważ kod jest bardziej przewidywalny, a wstępne wersje tokenów pojawiają się częściej.
Prefill opowiada inną historię
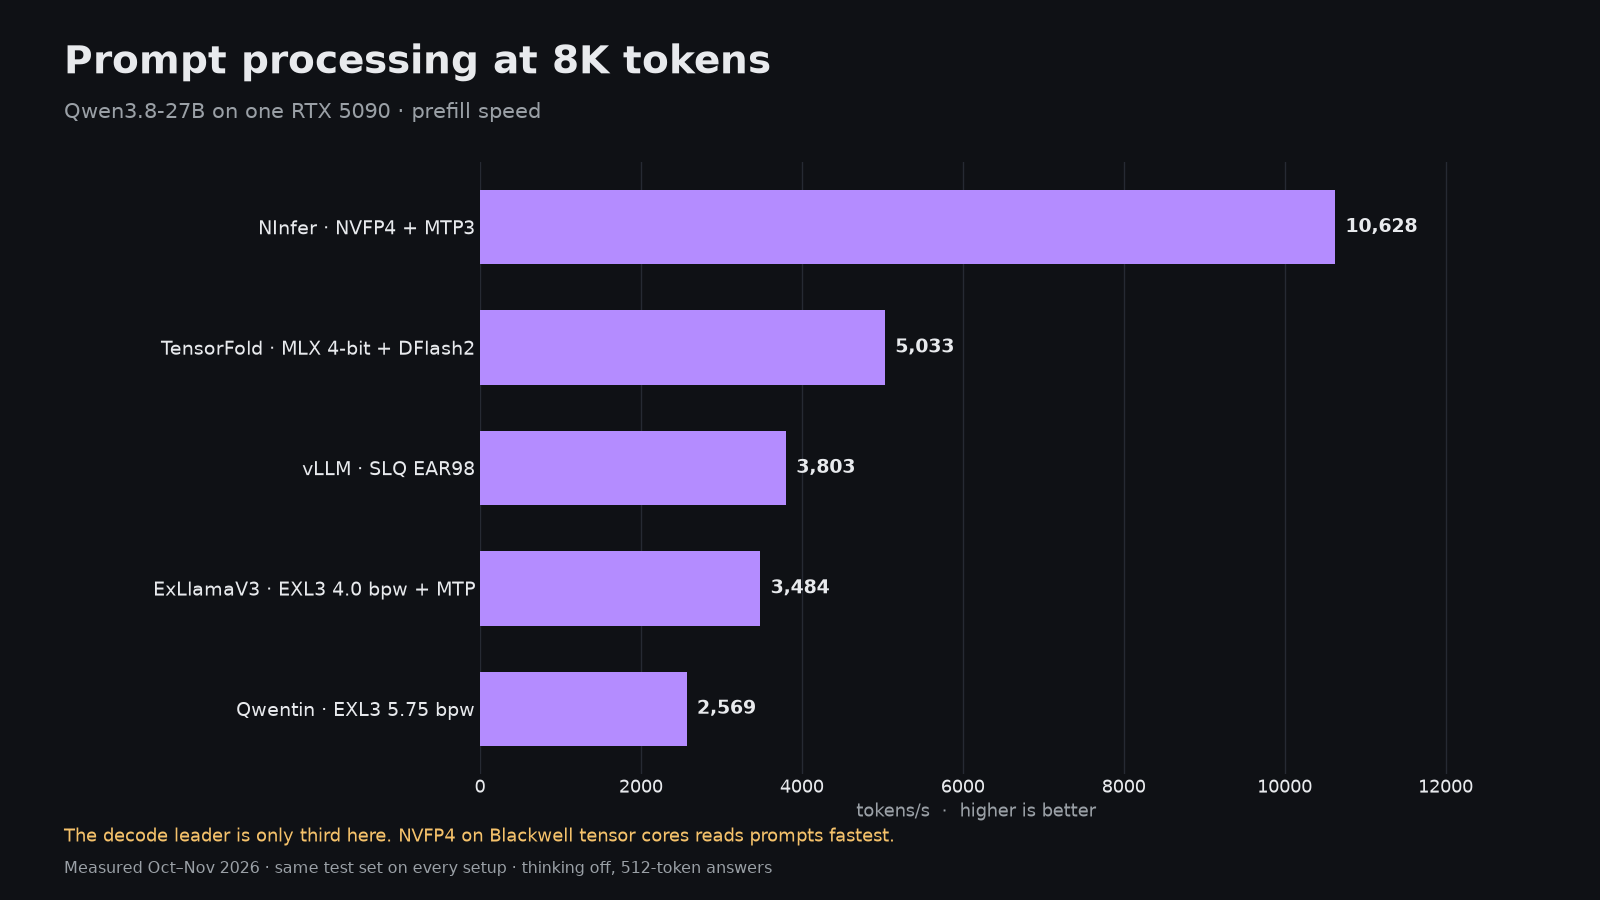
Gdy sortujemy według szybkości przetwarzania zapytań, kolejność się zmienia. NInfer z technologią NVFP4 przetwarza zapytanie o długości 8K tokenów z szybkością 10 628 tokenów na sekundę i zwraca pierwszy token zapytania o długości 32K tokenów w ciągu 3,6 sekundy. TensorFold zajmuje drugie miejsce z szybkością 5 033 tokenów na sekundę, następnie vLLM z 3 803 tokenami na sekundę, ExLlamaV3 z 3 484 tokenami na sekundę, a Qwentin z 2 569 tokenami na sekundę. W przypadku agentów do programowania, które wysyłają duże konteksty, NInfer oszczędza kilka sekund na rundę w porównaniu ze wszystkimi pozostałymi rozwiązaniami.
Służenie więcej niż jednemu użytkownikowi
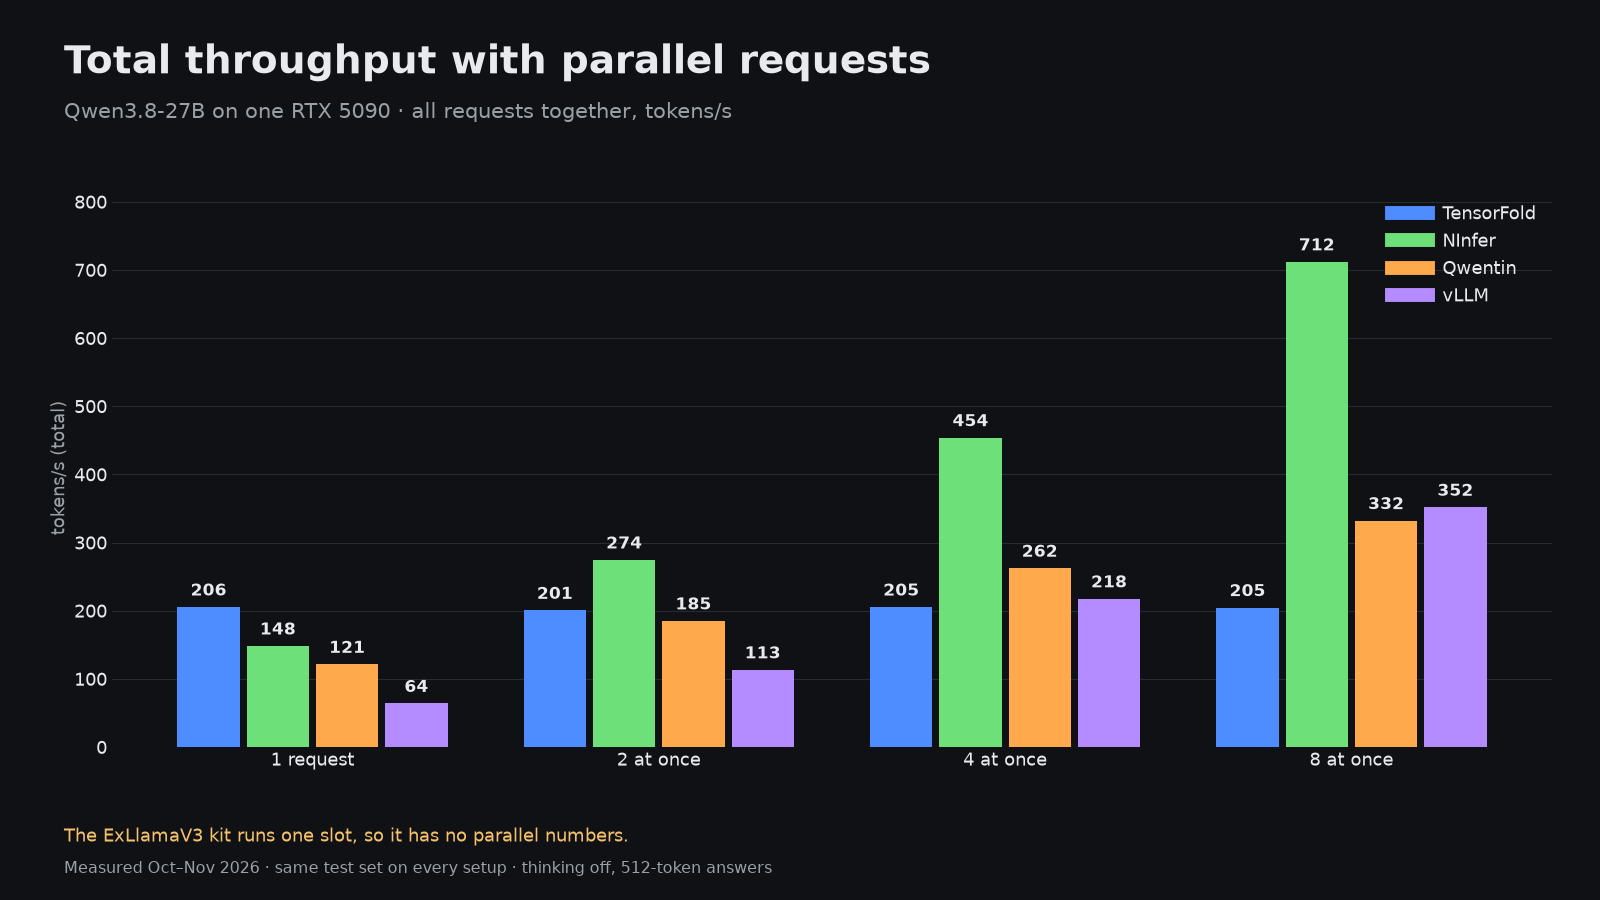
Przy ośmiu jednoczesnych żądaniach NInfer osiąga łącznie 711,9 tok/s, vLLM 351,8, a Qwentin 332,2. TensorFold utrzymuje się na poziomie około 204,6 tok/s niezależnie od liczby przychodzących żądań, natomiast zestaw ExLlamaV3 obsługuje tylko jedno żądanie. Jeśli system ma służyć zespołowi, kilku agentom lub pętli oceny, NInfer jest oczywistym wyborem; jeśli ma służyć jednej osobie, wybierany jest TensorFold.
Czy szybszy stack daje gorsze wyniki?
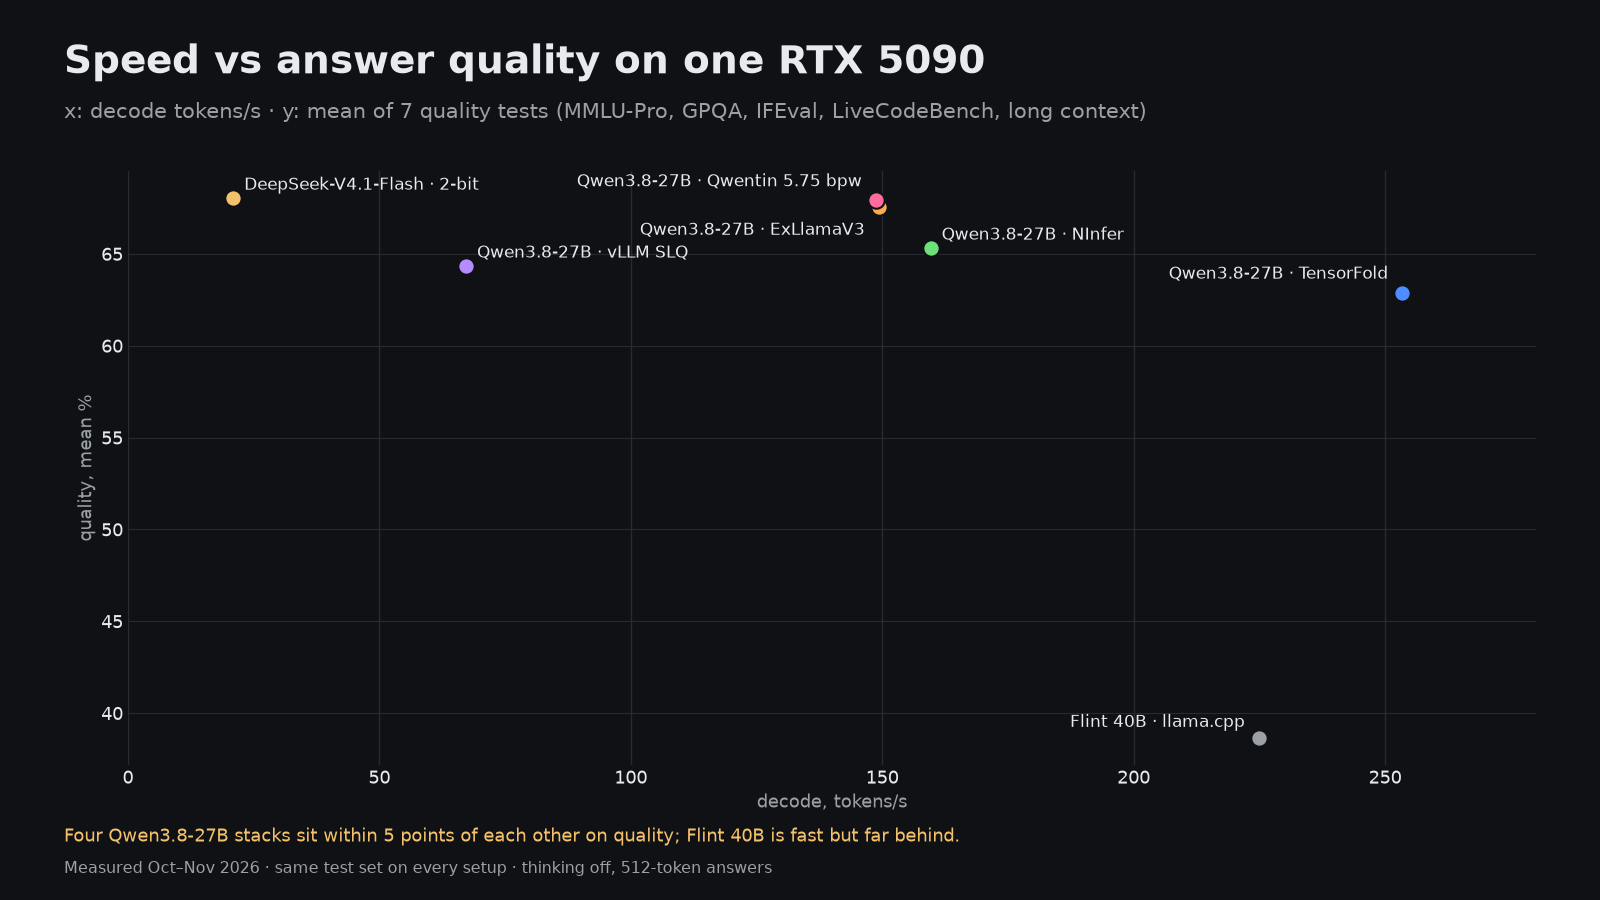
Niewiele, ale ten wskaźnik bardziej odzwierciedla poziom kwantyzacji niż sam silnik. Wersja Qwentin z 5,75 bpw osiąga najwyższy wynik na poziomie 67,9%, za nią plasuje się ExLlamaV3 z 4,0 bpw – 67,6%, NInfer NVFP4 na poziomie 65,3%, vLLM SLQ 64,3%, a TensorFold MLX 4-bit 62,9%. Poszczególne testy dają różnice sięgające kilku punktów, więc różnice pomiędzy sąsiadującymi wynikami należą do zakresu normalnych odchyleń; różnica 5 punktów pomiędzy najwyższym a najniższym wynikiem jest rzeczywista, ale niewielka w porównaniu z 3,8-krotną różnicą w szybkości.
Inne modele godne uwagi przy 32 GB pamięci
- Nemotron 3.5 Bolt 74B-A9B w TensorFold dekoduje z prędkością 242,7 tok/s i odczytuje prompty 8K z prędkością 11 014 tok/s przy użyciu 30,2 GiB pamięci. Jego szybkość została zmierzona, ale jeszcze nie został sklasyfikowany; średnia jakość w przeprowadzonych dotychczas testach wynosi 56,9 %.
- Flint 40B NVFP4 w llama.cpp działa z prędkością 224,9 tok/s przy kontekście 256K, ale jego średnia jakość wynosi zaledwie 38,6 %.
- DeepSeek-V4.1-Flash, model o pojemności 340 GB, działa na tej karcie dzięki Project Maya, przy czym większość zasobów jest przenoszona na 96 GB pamięci RAM oraz dysk NVMe o pojemności 4 TB. Dekoduje z prędkością 20,9 tok/s i osiąga wynik 68,0 %, co stanowi najlepszą jakość wśród wszystkich konfiguracji 32 GB. Jest wolny, ale funkcjonuje.
Wideo i obrazy na RTX 5090
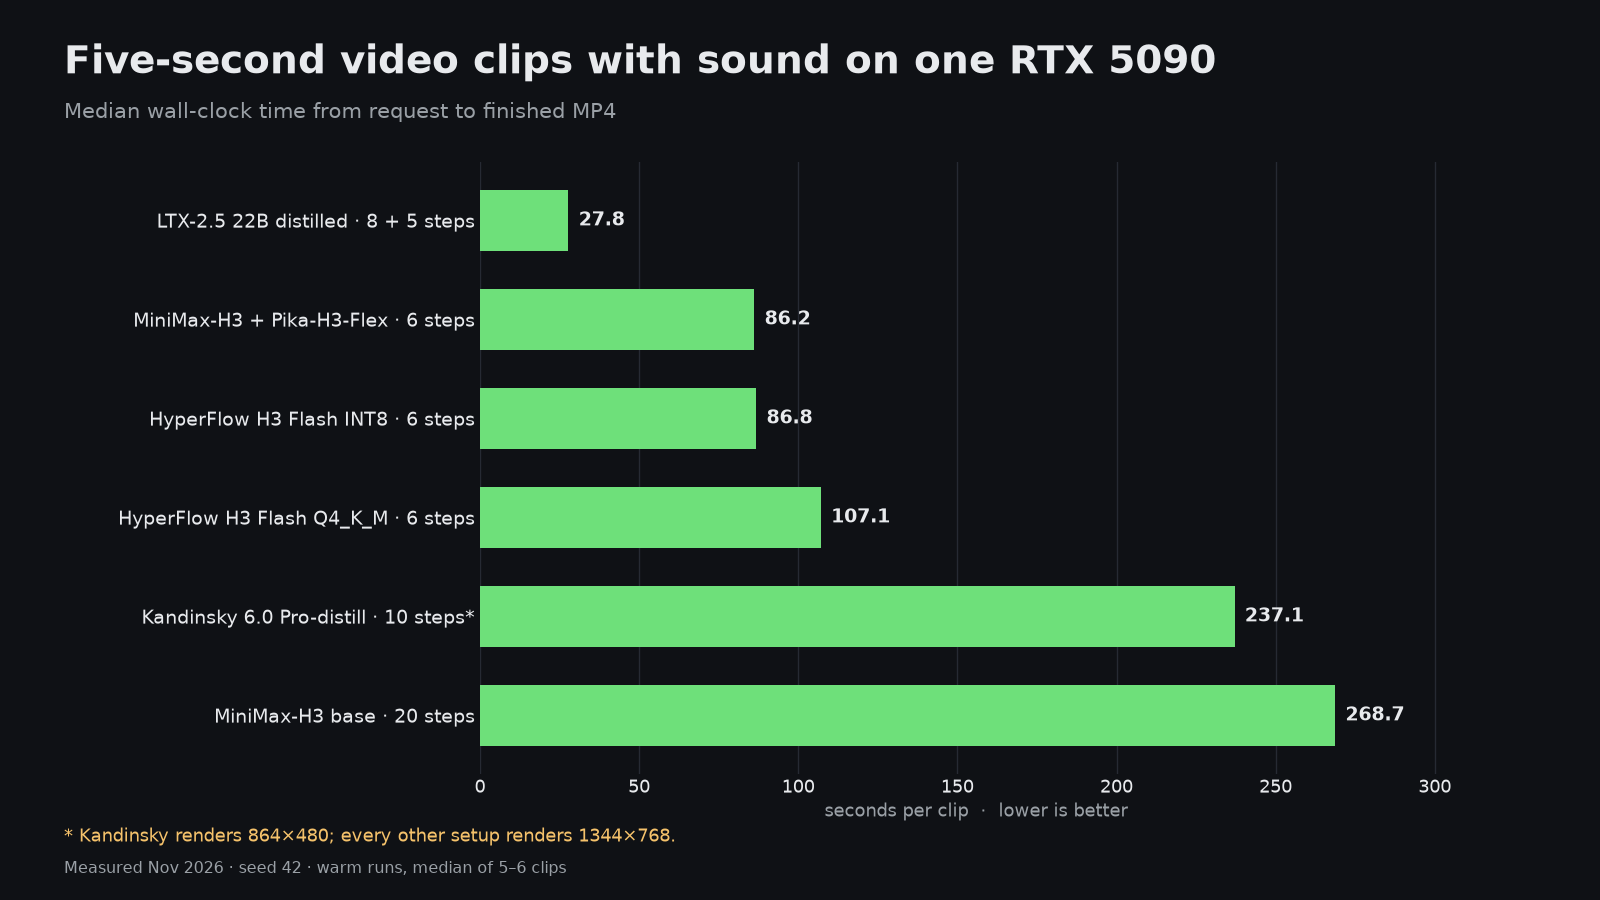
Ta sama karta sprawdza się doskonale do przetwarzania wideo. Model LTX-2.5 22B po przetworzeniu 5-sekundowego klipu w rozdzielczości 1344×768 z dźwiękiem potrzebuje 27,8 s. MiniMax-H3 z technologią Pika-H3-Flex potrzebuje 86,2 s, HyperFlow H3 Flash INT8 – 86,8 s, a podstawowy model MiniMax-H3 z 20 etapami przetwarzania – 268,7 s. W przypadku obrazów statycznych FLUX Klein potrzebuje 1,96 s na obraz, Qwen-Image 2.1 – 7,64 s, a MOSS – 12,81 s.
Który zestaw wybrać
- Jeden użytkownik, czat i programowanie: TensorFold z DFlash2 o szybkości 253,4 tok/s i kontekście o pojemności 256K.
- Agenci, RAG lub kilku użytkowników: NInfer z NVFP4 – 10 628 toków/s przy wypełnianiu uprzednim i 711,9 toków/s przy ośmiu zapytaniach.
- Najlepsze odpowiedzi przy dobrej szybkości: Qwentin EXL3 5,75 bpw lub ExLlamaV3 4,0 bpw, oba blisko 150 toków/s przy najwyższych ocenach jakości.
- Znany serwer kompatybilny z OpenAI bez konieczności tworzenia własnej wersji: vLLM, obsługujący około 67 toków/s na strumień.
- Uwaga na VRAM: cztery z pięciu rozwiązań osiągają wartości powyżej 27 GiB, więc jeśli to możliwe, użyj zintegrowanej karty graficznej w komputerze stacjonarnym.