RTX 5090本地LLM基准测试:同样使用Qwen3.8-27B模型,每秒处理67至253个标记。
在TensorFold、NInfer、ExLlamaV3、Qwentin和vLLM环境下,使用单块RTX 5090运行Qwen3.8-27B模型:解码性能、预填充能力、并行处理效率、质量表现以及推荐使用的框架。
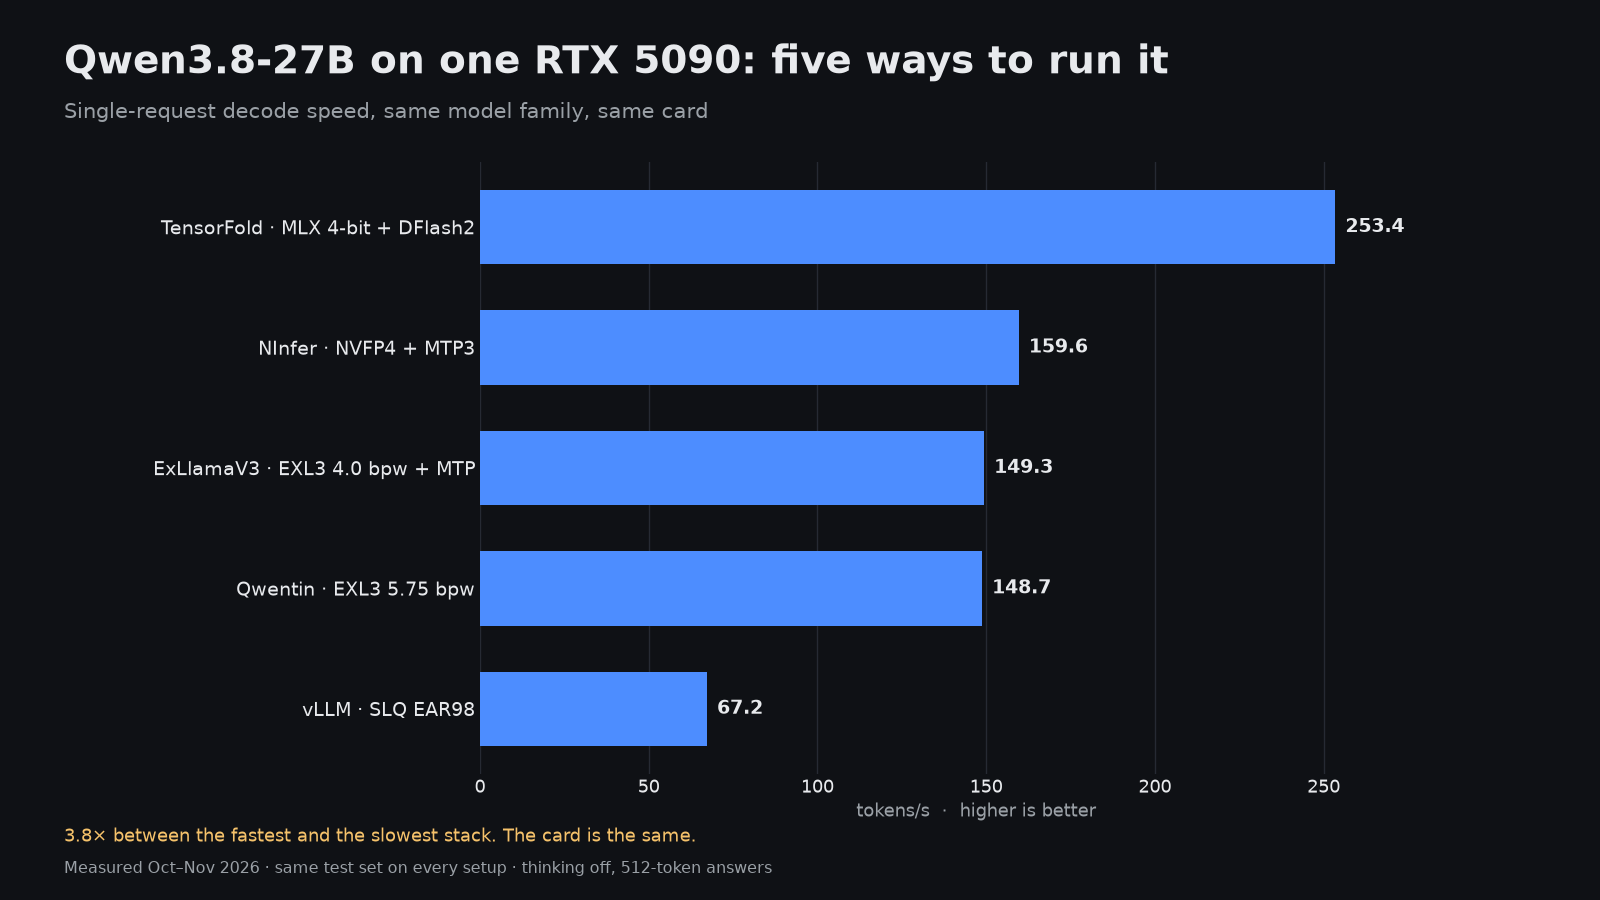
在相同的 RTX 5090 上运行相同的 Qwen3.8-27B 模型,其每秒生成的语料量可在 67.2 到 253.4 个标记之间。差异源于引擎本身、量化方式以及相关的推测性解码方法。下文中列出的五组完整配置均使用相同的测试工具与质量评估体系进行测量,因此该对比侧重于软件堆栈而非硬件差异。
该显卡为单块 32 GB 容量的 RTX 5090。解码性能为针对代码提示和散文提示生成的 512 个标记长度答案的中值;预填充时间与首个标记生成时间则在 2K、8K 和 32K 个标记的测试条件下进行测量;并行处理能力则指同时处理 1、2、4 和 8 个请求时的总每秒生成标记数。
同一模型的五种软件堆栈
| 引擎 | 量化格式 | 解码速度,tok/s | 代码/散文 | 8K预填充速度,tok/s | 32K时的首个token生成时间 | 质量平均值 | 最大上下文长度 | 峰值显存使用量 |
|---|---|---|---|---|---|---|---|---|
| TensorFold + DFlash2 | MLX 4位 | 253.4 | 268.2 / 238.7 | 5,033 | 7.7秒 | 62.9% | 256K | 27.3 GiB |
| NInfer + MTP3 | NVFP4 | 159.6 | 169.0 / 150.1 | 10,628 | 3.6 秒 | 65.3 % | 240,000 | 28.9 GiB |
| ExLlamaV3 + MTP | EXL3 4.0 bpw | 149.3 | 154.5 / 144.2 | 3,484 | 10.5 秒 | 67.6 % | 128K | 18.9 GiB |
| Qwentin + MTP | EXL3 5.75 bpw | 148.7 | 158.3 / 139.2 | 2,569 | 13.7 秒 | 67.9 % | 128K | 29.7 GiB |
| vLLM,无推测 | SLQ EAR98 | 67.2 | 67.2 / 67.1 | 3,803 | 9.5 秒 | 64.3 % | 74,752 | 29.5 GiB |
推测性解码解释了大部分差异
vLLM在无推测模式下运行该模型,速度为67.2 tok/s,代码和普通文本的生成速度均在0.1 tok/s左右。这大致相当于每个标记都经过完整模型处理时的性能。其他四种方案都是先提前生成标记,再一次性进行验证,因此速度能达到前者的2到4倍。
这些方法的实现方式不同。NInfer使用MTP3模块并额外加入lm-head进行标记生成,其中52.8%的生成标记被接受。TensorFold则使用独立的DFlash2模块进行标记生成,仅有20.0%的生成标记被接受,但由于每次验证的成本很低,它仍然以较大优势胜出。在所有采用推测模式的方案中,代码提示语的生成速度都快于普通文本(在TensorFold上分别为268.2 tok/s和238.7 tok/s),因为代码更具规律性,标记生成的频率也更高。
Prefill的表现则有所不同
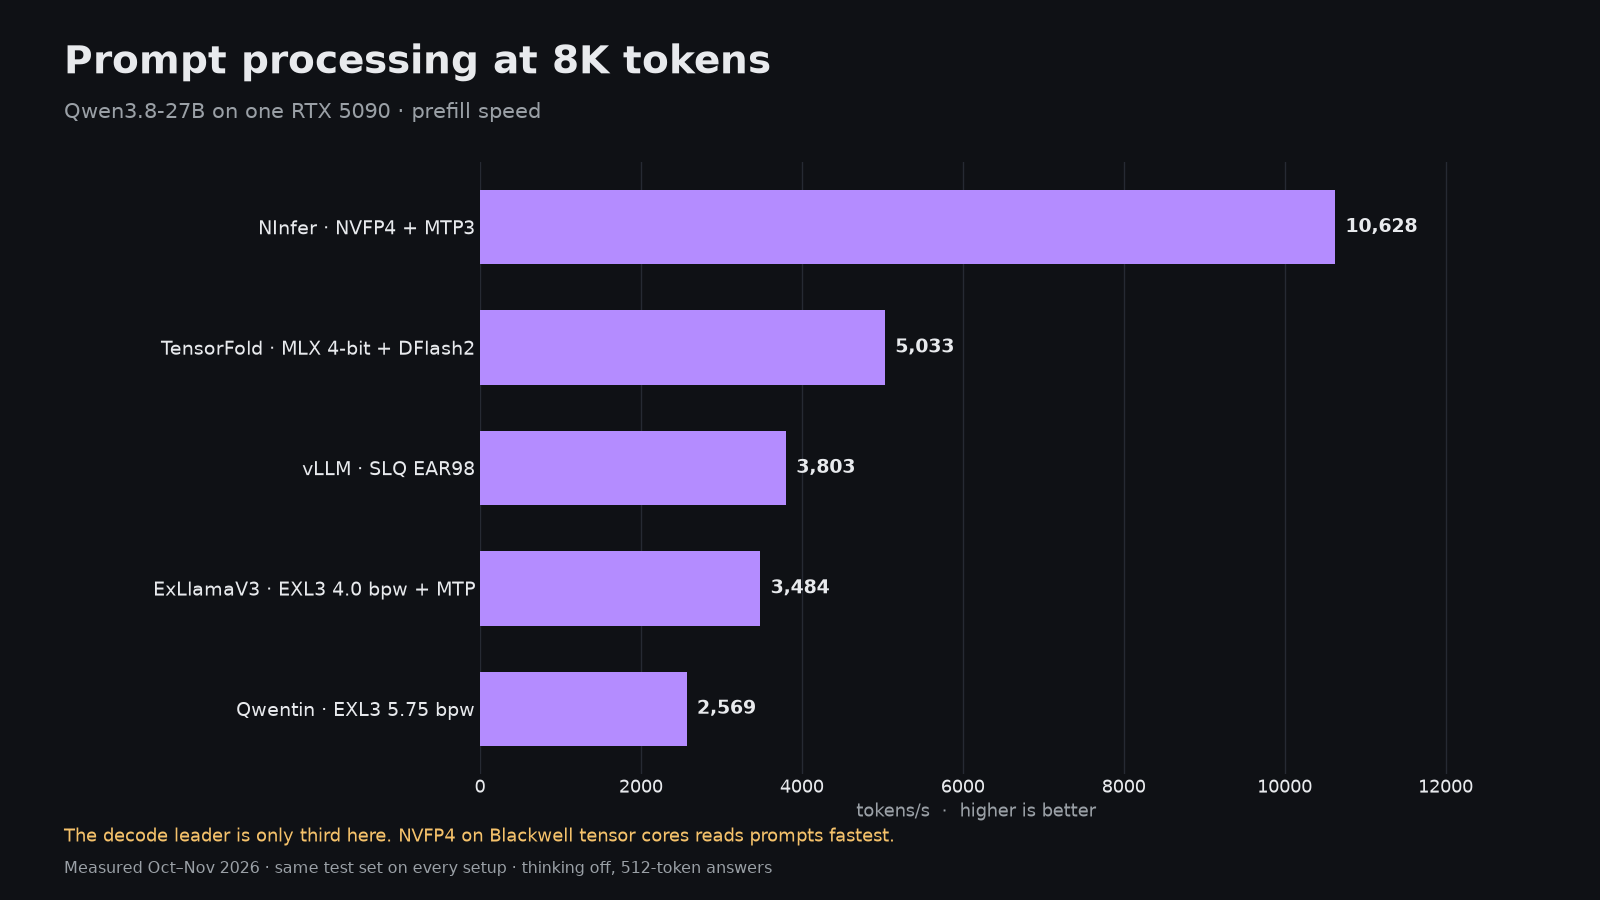
若按提示语处理速率排序,顺序会发生变化。使用NVFP4技术的NInfer处理8K长度提示语的速率为10,628个标记/秒,而处理32K长度提示语的首个标记仅需3.6秒。TensorFold位居第二,速率为5,033个标记/秒,其次是vLLM的3,803个标记/秒、ExLlamaV3的3,484个标记/秒,以及Qwentin的2,569个标记/秒。对于需要重新传输大量上下文的编程型模型,NInfer每轮的处理时间比其他所有模型都短几秒。
服务多个用户
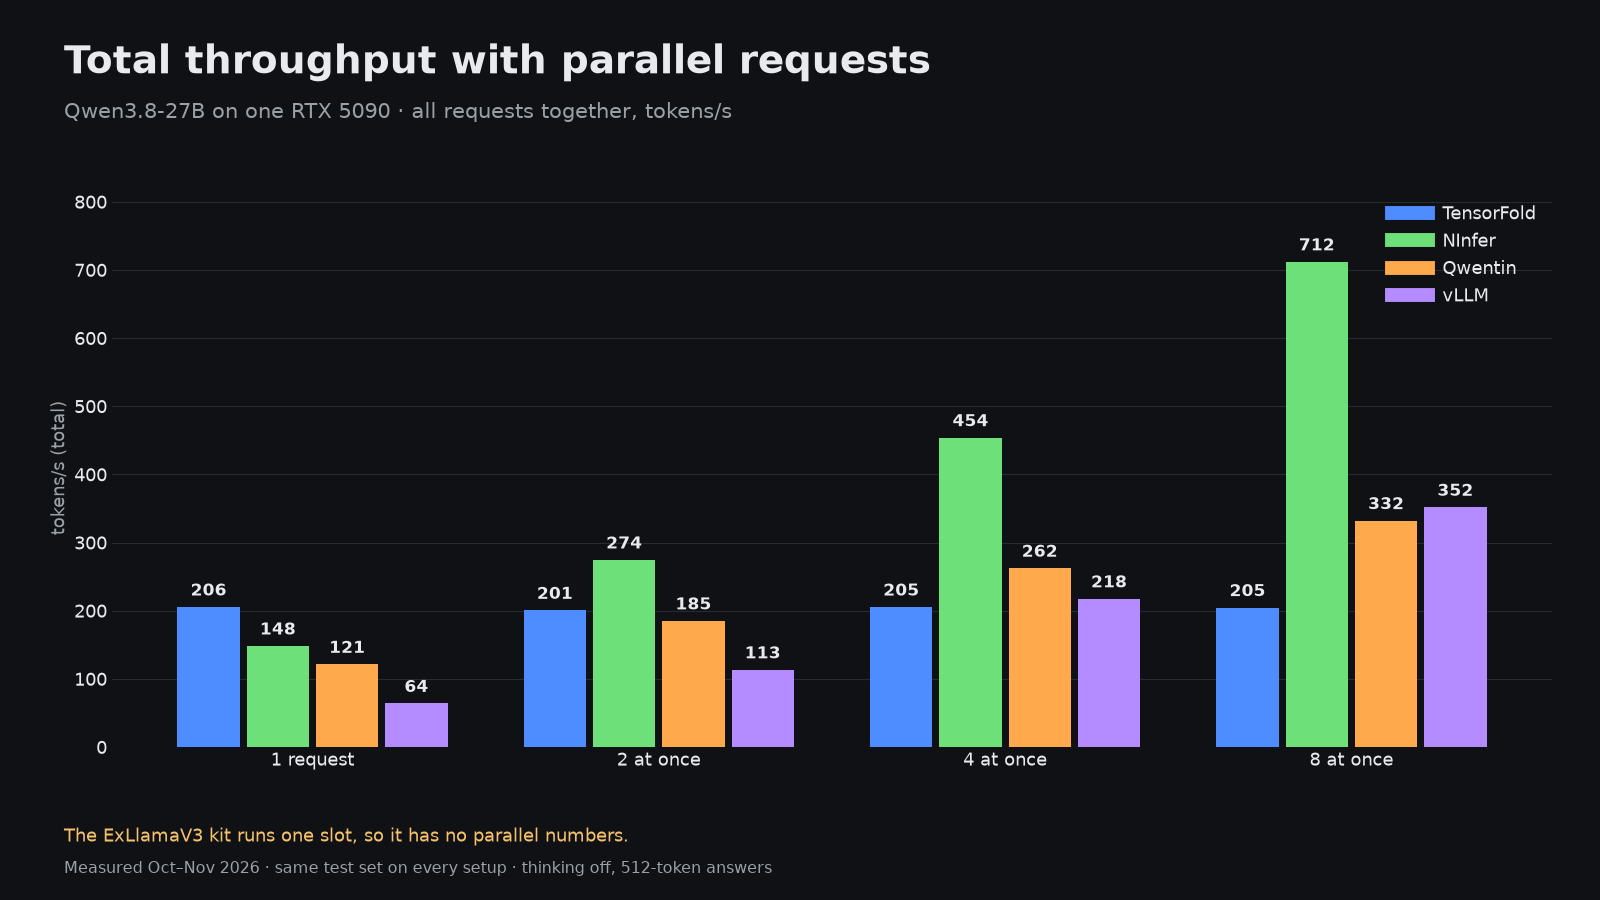
在同时处理8个请求时,NInfer的总吞吐量为711.9 tok/s,vLLM为351.8 tok/s,Qwentin为332.2 tok/s。无论有多少请求进入,TensorFold的吞吐量始终在204.6 tok/s左右,而ExLlamaV3套件仅能处理单个请求。如果该系统是为团队、多个智能体或评估循环服务,NInfer显然是更佳选择;若仅为单人使用,则TensorFold更为合适。
快速处理方案的表现是否更差?
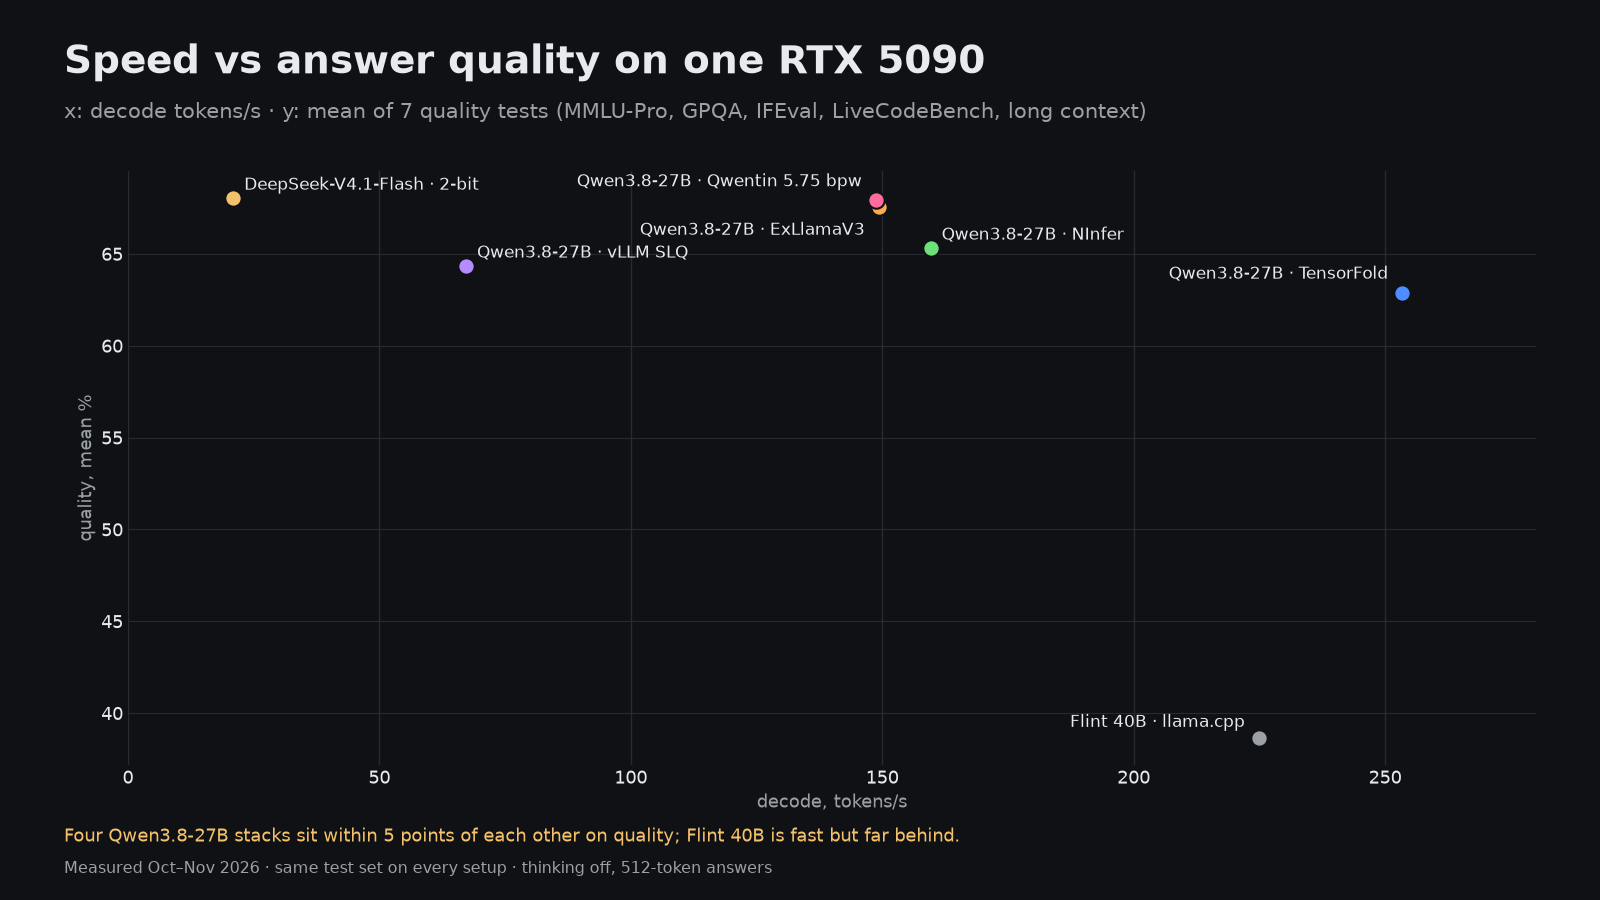
从图表可以看出,该指标更多反映的是量化程度而非引擎本身的性能。Qwentin版本在5.75比特/字的量化率下得分最高,为67.9%;ExLlamaV3在4.0比特/字的量化率下得分为67.6%;NInfer NVFP4得分为65.3%;vLLM SLQ得分为64.3%;TensorFold MLX 4位量化版本得分为62.9%。各项测试结果之间存在几分的差异,因此相邻模型之间的差距可视为随机波动;从最高分到最低分的5分差距虽然存在,但与3.8倍的速度差异相比就显得微不足道了。
32GB显存值得关注的其它模型
- TensorFold环境中的Nemotron 3.5 Bolt 74B-A9B解码速度为242.7 tok/s,能在30.2 GiB内存下以11,014 tok/s的速度处理8K长度的提示词。该模型已进行速度测试但尚未排名;目前测试中的平均质量得分仅为56.9%。
- 在llama.cpp环境中运行的Flint 40B NVFP4在256K上下文长度下的解码速度为224.9 tok/s,但其平均质量得分仅为38.6%。
- DeepSeek-V4.1-Flash是一款340 GB规模的模型,通过Project Maya在该显卡上运行,大部分模型参数被加载到96 GB的RAM和4 TB的NVMe硬盘中。其解码速度为20.9 tok/s,质量得分达68.0%,是所有32 GB配置中的最佳表现。虽然速度较慢,但依然可以正常使用。
RTX 5090上的视频与图像处理
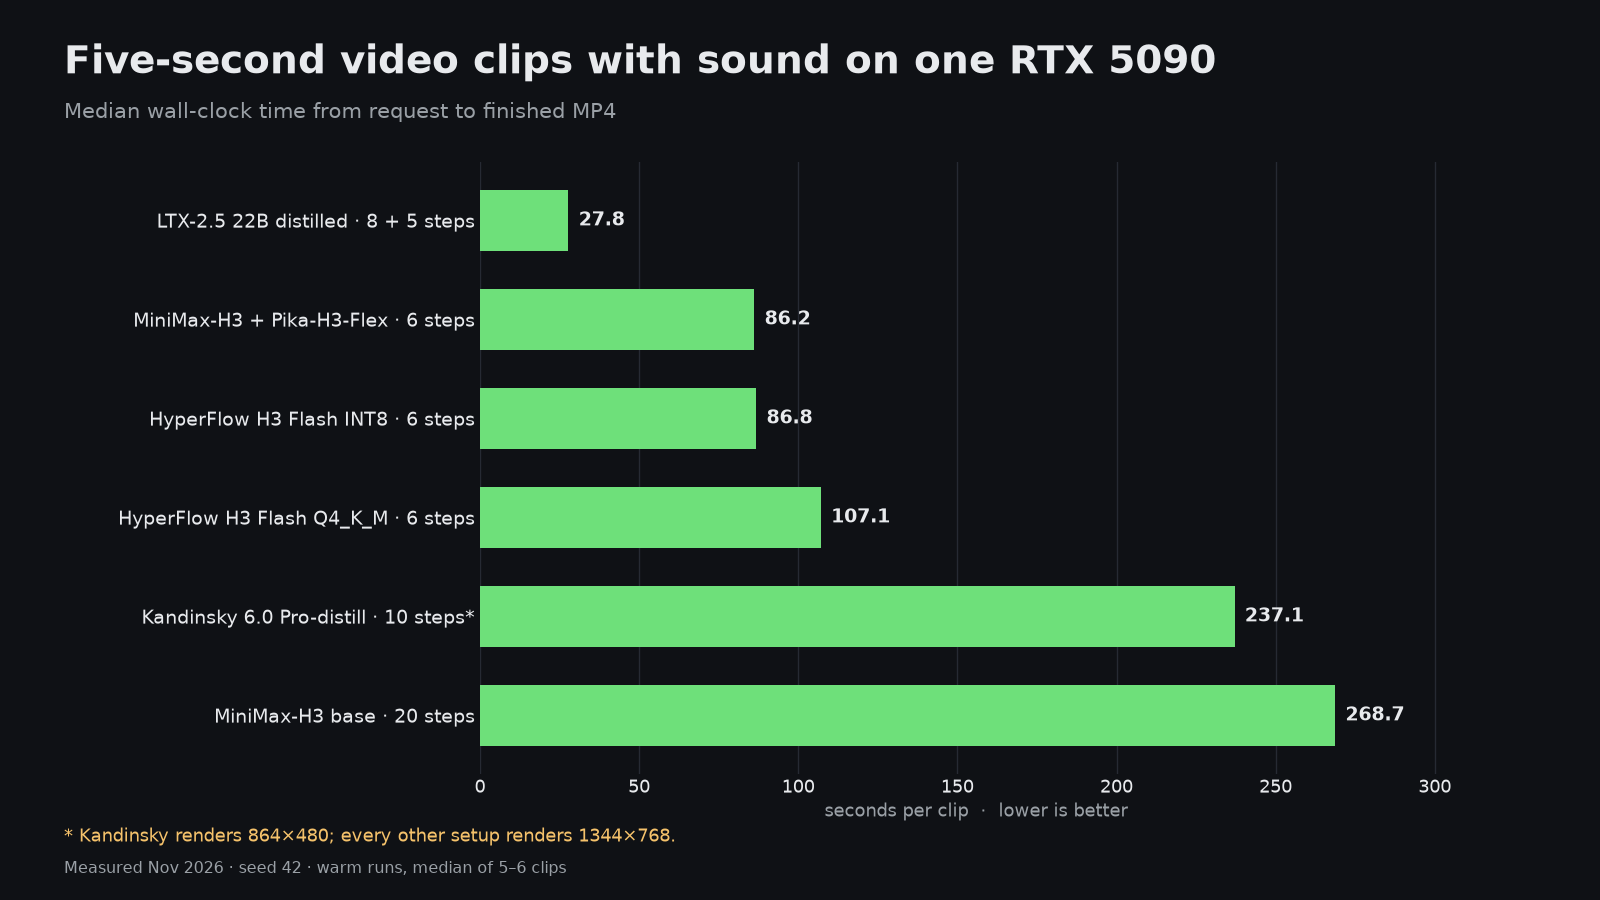
同一张显卡在视频处理方面也表现强劲。经过LTX-2.5 22B蒸馏优化的模型处理5秒、分辨率为1344×768且包含声音的视频片段仅需27.8秒。采用Pika-H3-Flex蒸馏优化的MiniMax-H3模型需要86.2秒,HyperFlow H3 Flash INT8模型需要86.8秒,而20步训练的MiniMax-H3基础模型则需要268.7秒。在处理静态图像方面,FLUX Klein每张图片的生成时间为1.96秒,Qwen-Image 2.1为7.64秒,MOSS则为12.81秒。
应选择哪种技术组合
- 适用于单人、聊天及编程场景:TensorFold搭配DFlash2,处理速度为253.4个token/秒,上下文长度为256K。