Lokale LLM-Benchmarks für RTX 5090: Derselbe Qwen3.8-27B, 67 bis 253 Token pro Sekunde.
Qwen3.8-27B auf einer RTX 5090 unter Verwendung von TensorFold, NInfer, ExLlamaV3, Qwentin und vLLM: Dekodierung, Vorausfüllen, paralleler Durchsatz, Qualität sowie welche Plattform zum Ausführen geeignet ist.
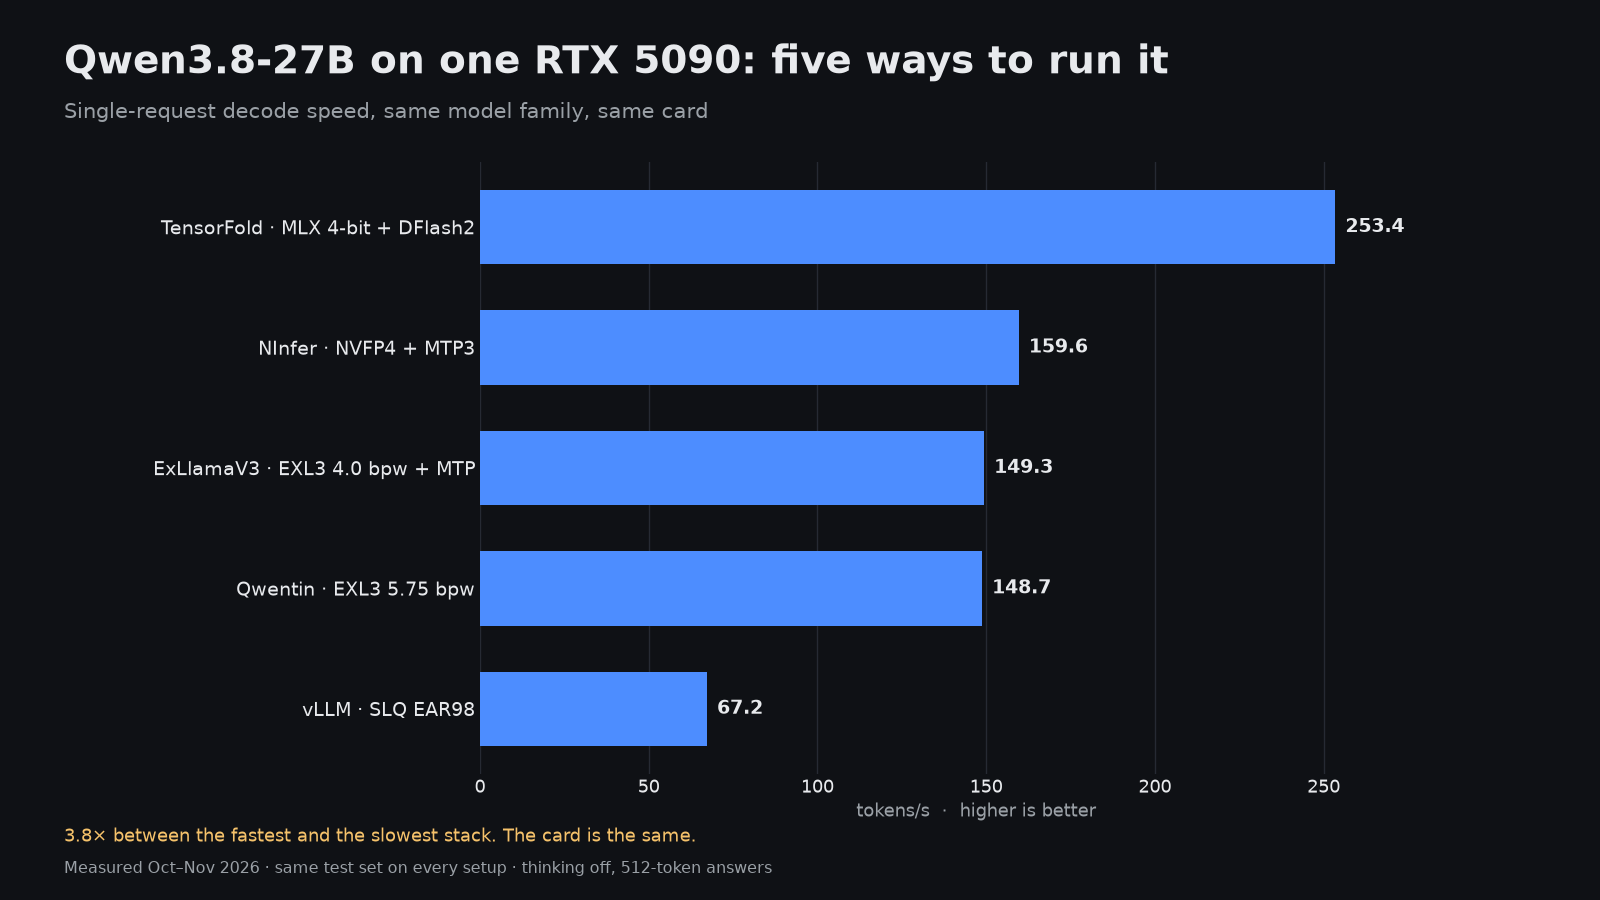
Setzen Sie denselben Qwen3.8-27B auf dieselbe RTX 5090, und Sie können Werte zwischen 67,2 und 253,4 Tokens pro Sekunde erzielen. Der Unterschied liegt im Engine, in der Quantisierung sowie in der verwendeten spekulativen Dekodiermethode. Die fünf unten aufgeführten vollständigen Konfigurationen wurden mit derselben Ausrüstung und dem gleichen Qualitätsmesssystem getestet, sodass der Vergleich auf die Softwarestacks und nicht auf die Hardware abzielt.
Es handelt sich um eine einzige RTX 5090 mit 32 GB Speicher. Die Dekodierleistung wird anhand des Median-Werts von 512-Token-Antworten auf Code- und Prosa-Aufforderungen ermittelt; die Zeit für das Vorausfüllen sowie für den ersten Token wird bei 2K, 8K und 32K Tokens gemessen; die parallele Durchsatzleistung gibt den Gesamtzahl der Tokens pro Sekunde bei 1, 2, 4 und 8 gleichzeitigen Anfragen an.
Fünf Stack-Optionen für ein Modell
| Engine | Quantisierung | Dekodiergeschwindigkeit, Tokel/s | Code / Prosa | Prefill 8K, Tokel/s | Erster Token bei 32K | Durchschnittliche Qualität | Größter Kontext | Höchster VRAM-Verbrauch |
|---|---|---|---|---|---|---|---|---|
| TensorFold + DFlash2 | MLX 4-bit | 253,4 | 268,2 / 238,7 | 5.033 | 7,7 s | 62,9 % | 256K | 27,3 GiB |
| NInfer + MTP3 | NVFP4 | 159,6 | 169,0 / 150,1 | 10.628 | 3,6 s | 65,3 % | 240.000 | 28,9 GiB |
| ExLlamaV3 + MTP | EXL3 4,0 bpw | 149,3 | 154,5 / 144,2 | 3.484 | 10,5 s | 67,6 % | 128K | 18,9 GiB |
| Qwentin + MTP | EXL3 5,75 bpw | 148,7 | 158,3 / 139,2 | 2.569 | 13,7 s | 67,9 % | 128K | 29,7 GiB |
| vLLM, ohne Spekulation | SLQ EAR98 | 67,2 | 67,2 / 67,1 | 3.803 | 9,5 s | 64,3 % | 74.752 | 29,5 GiB |
Spekulative Dekodierung erklärt den größten Teil des Unterschieds
vLLM führt dieses Modell ohne Spekulation aus und erreicht 67,2 Tokel pro Sekunde, wobei Code und Prosa jeweils bei etwa 0,1 Tokel pro Sekunde liegen. Das entspricht ungefähr der Leistung der Karte, wenn jeder Token durch das gesamte Modell verarbeitet wird. Die anderen vier Ansätze erstellen alle Tokens im Voraus und überprüfen sie in einer einzigen Passung – daraus resultieren die 2- bis 4-fach höheren Werte.
Die Methoden unterscheiden sich. NInfer verwendet MTP3-Headen mit einem zusätzlichen lm-Head zur Erstellung von Entwürfen, wobei 52,8 % der Entwürfe akzeptiert werden. TensorFold nutzt einen separaten DFlash2-Entwurfsmechanismus; nur 20,0 % seiner Entwürfe werden akzeptiert, doch da jede Überprüfungspassung ausreichend kostengünstig ist, gewinnt es dennoch mit großem Vorsprung im Einström-Dekodieren. Code-Aufforderungen sind auf allen spekulativen Ansätzen schneller als Prosa (268,2 gegen 238,7 Tokel pro Sekunde bei TensorFold), da Code vorhersehbarer ist und Entwürfe häufiger zustande kommen.
Prefill erzählt eine andere Geschichte
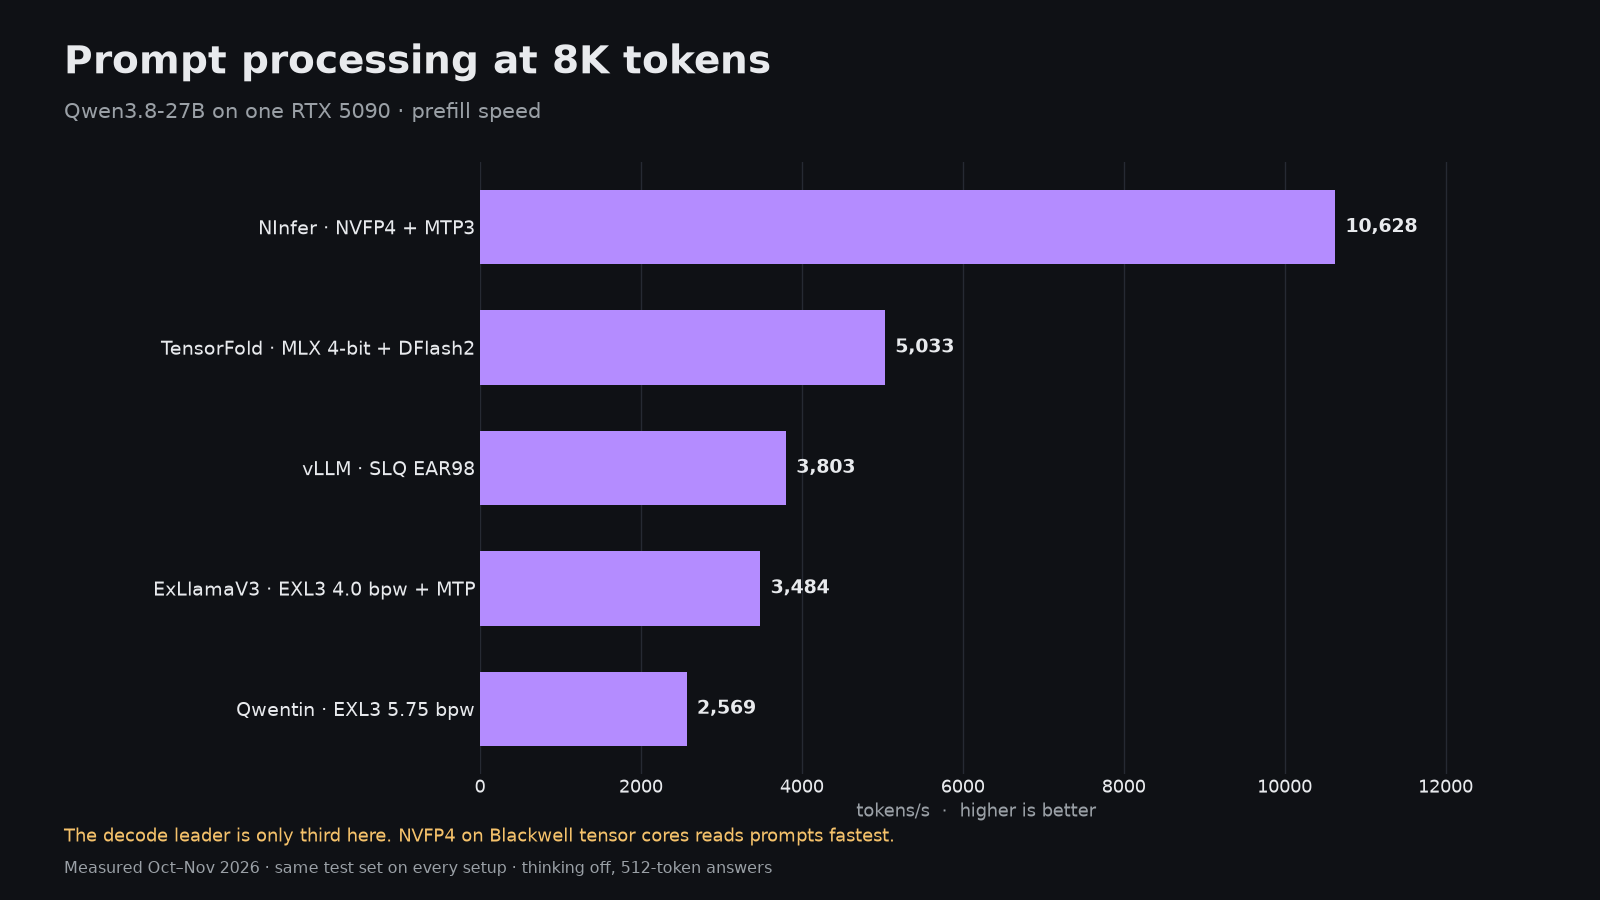
Wenn nach der Prompt-Verarbeitungsgeschwindigkeit sortiert wird, ändert sich die Reihenfolge. NInfer mit NVFP4 liest einen 8K-Prompt mit 10.628 Token pro Sekunde ein und gibt das erste Token eines 32K-Prompts in 3,6 Sekunden zurück. TensorFold liegt auf dem zweiten Platz mit 5.033 Token pro Sekunde, gefolgt von vLLM mit 3.803, ExLlamaV3 mit 3.484 und Qwentin mit 2.569. Bei Code-Agenten, die große Kontexte erneut senden, spart NInfer im Vergleich zu allen anderen hier mehrere Sekunden pro Turnus.
Dienstleistung für mehrere Benutzer
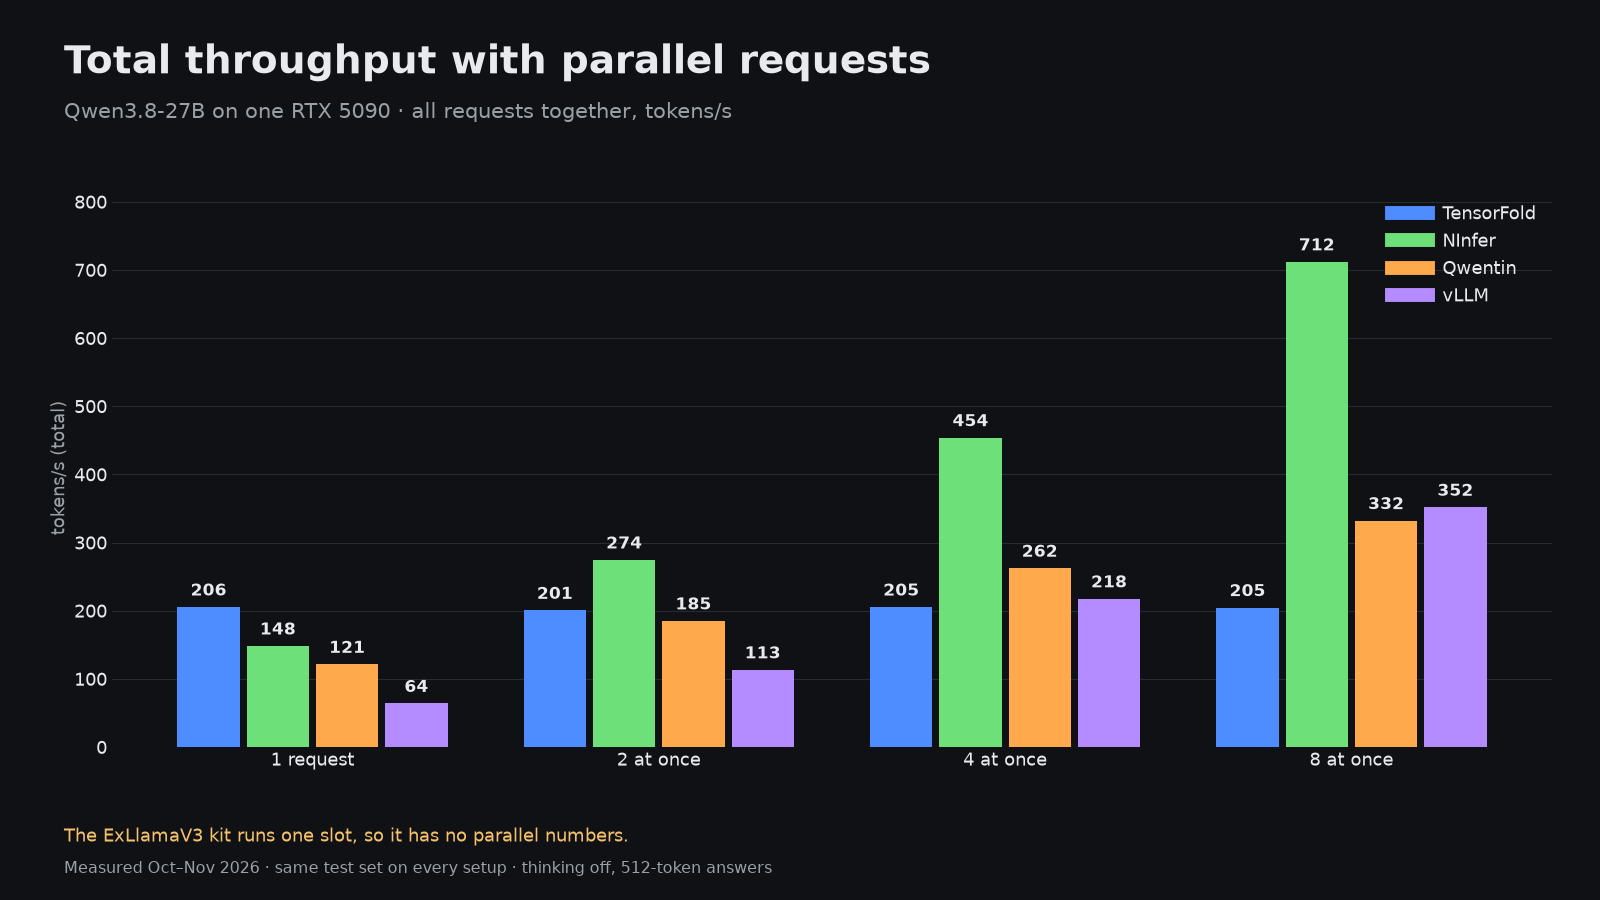
Bei acht gleichzeitigen Anfragen erzielt NInfer insgesamt 711,9 Tok/s, vLLM 351,8 und Qwentin 332,2. TensorFold hält unabhängig von der Anzahl der Anfragen bei etwa 204,6 Tok/s, während das ExLlamaV3-Kit nur einen Slot bereitstellt. Wenn der Systemeinsatz einem Team, mehreren Agenten oder einer Evaluierungszyklus dient, ist NInfer die klare Wahl; falls er nur einer Person dient, ist TensorFold geeigneter.
Liefern die schnellen Stacke schlechtere Ergebnisse?
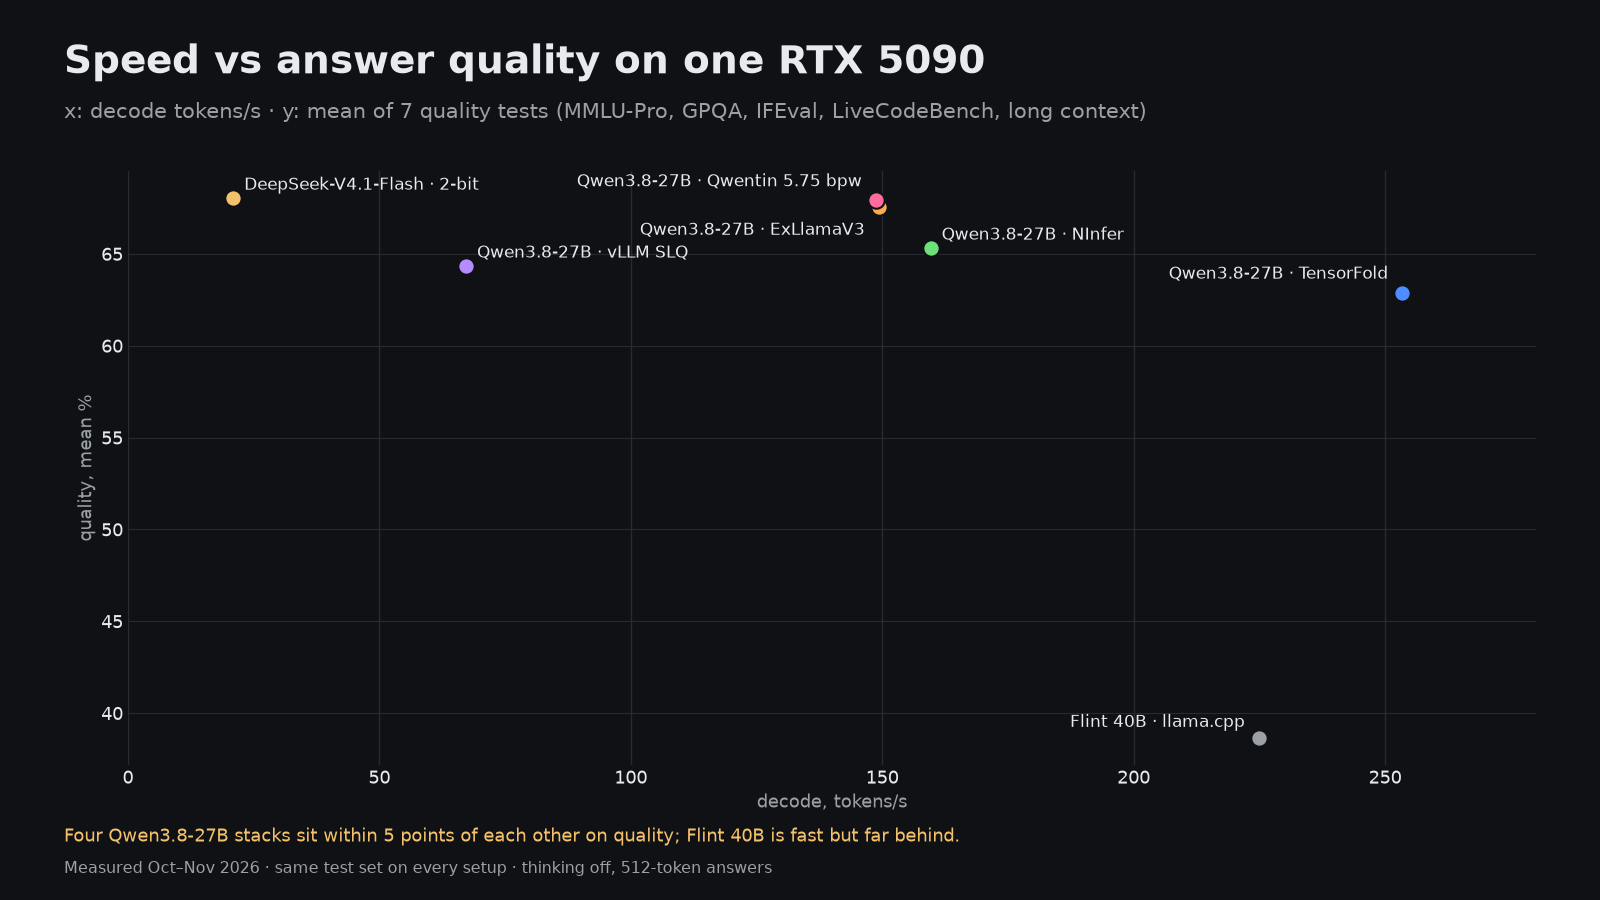
Es zeigt, dass die Quantisierung mehr Einfluss hat als der verwendete Engine. Die Qwentin-Version mit 5,75 bpw erzielt mit 67,9 % den höchsten Wert, gefolgt von ExLlamaV3 mit 4,0 bpw bei 67,6 %. NInfer NVFP4 liegt bei 65,3 %, vLLM SLQ bei 64,3 % und TensorFold MLX 4-bit bei 62,9 %. Die einzelnen Tests weisen Unterschiede von mehreren Punkten auf, sodass die Abstände zwischen den Werten im Rahmen des Rauschens liegen; der Unterschied von 5 Punkten von oben nach unten ist zwar real, aber im Vergleich zu einem Geschwindigkeitsunterschied von 3,8-fach unbedeutend.
Weitere Modelle, die man bei 32 GB kennen sollte
- Nemotron 3.5 Bolt 74B-A9B in TensorFold decodiert mit 242,7 Tok/S und liest 8K-Prompts mit 11.014 Tok/S bei 30,2 GiB. Die Geschwindigkeit wurde gemessen, doch es gibt noch keine Rangliste; die durchschnittliche Qualität in den bisherigen Tests liegt bei 56,9 %.
- Flint 40B NVFP4 in llama.cpp arbeitet mit 224,9 Tok/S bei einem Kontextumfang von 256K, doch die durchschnittliche Qualität beträgt nur 38,6 %.
- DeepSeek-V4.1-Flash, ein 340 GB großes Modell, läuft auf dieser Karte über Project Maya – wobei die meisten Experten auf 96 GB RAM sowie eine 4 TB große NVMe-Festplatte ausgelagert werden. Es decodiert mit 20,9 Tok/S und erreicht eine Qualität von 68,0 %, was die beste Qualität unter allen 32 GB-Setups hier darstellt. Langsam, aber funktionsfähig.
Video und Bilder auf der RTX 5090
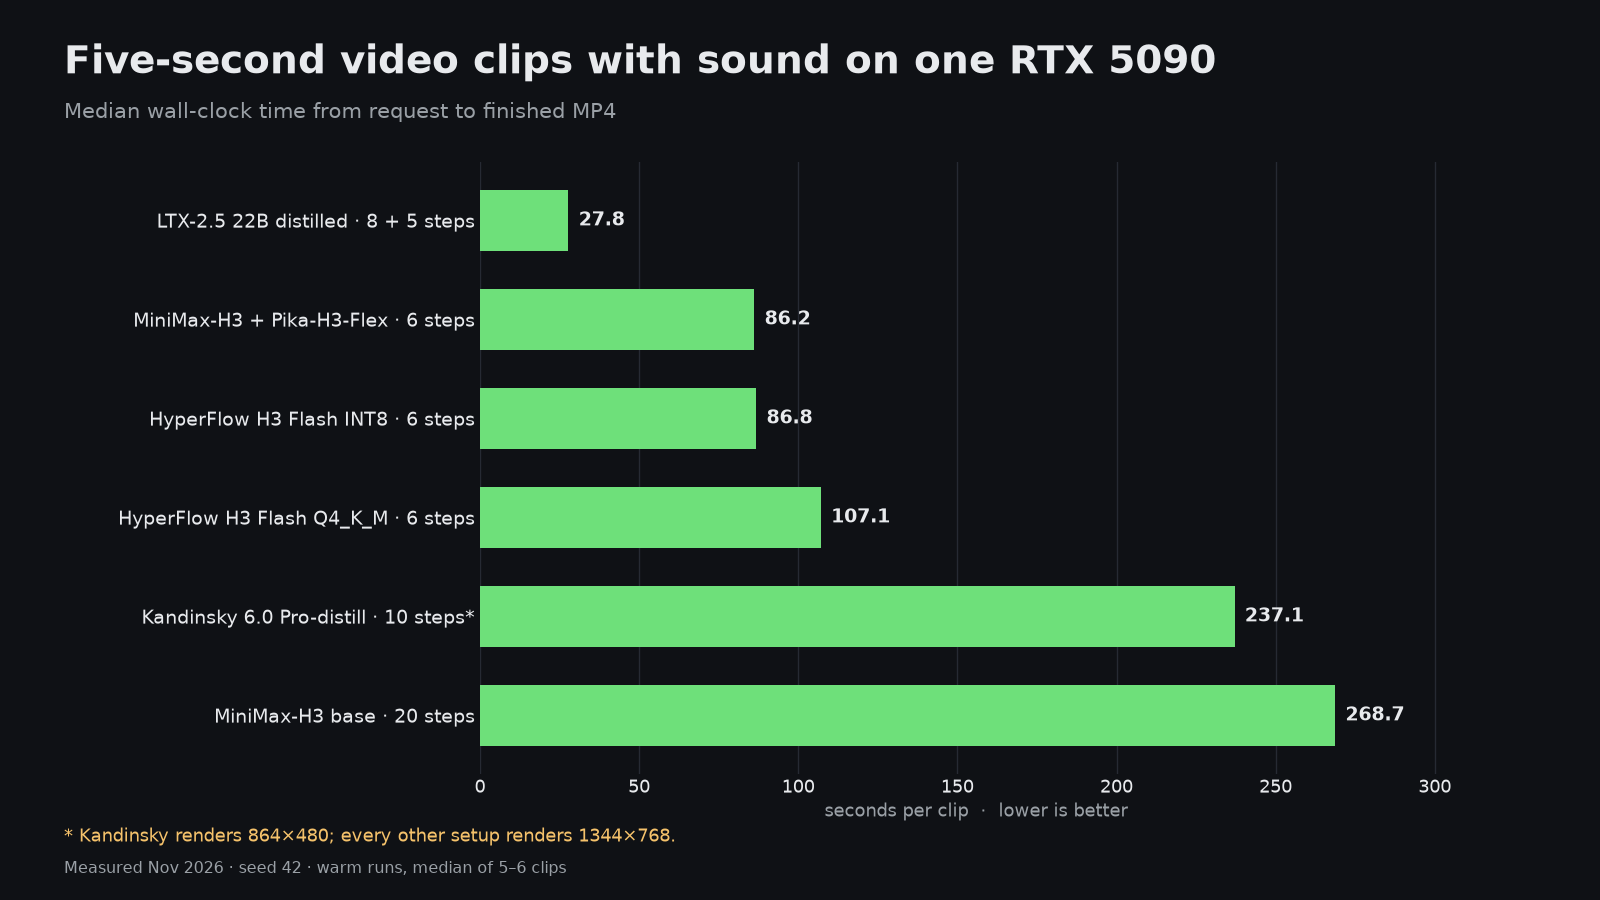
Die gleiche Karte ist eine leistungsstarke Video-Verarbeitungseinheit. LTX-2.5 22B schafft es, einen 5-sekündigen 1344×768-Clip mit Ton in 27,8 Sekunden zu verarbeiten. MiniMax-H3 mit der Pika-H3-Flex-Verarbeitung benötigt 86,2 Sekunden, HyperFlow H3 Flash INT8 86,8 Sekunden und das 20-Schritte-Version des MiniMax-H3-Base-Modells 268,7 Sekunden. Für Stillbilder benötigt FLUX Klein 1,96 Sekunden pro Bild, Qwen-Image 2.1 7,64 Sekunden und MOSS 12,81 Sekunden.
Welche Lösung wählen?
- Ein Benutzer, Chat und Programmieren: TensorFold mit DFlash2 bei 253,4 Tok/S und einem Kontextumfang von 256 K.
- Agenten, RAG oder mehrere Benutzer: NInfer mit NVFP4 – 10.628 Tok/S beim Vorausfüllen und 711,9 Tok/S bei acht Anfragen insgesamt.
- Beste Antworten bei guter Geschwindigkeit: Qwentin EXL3 mit 5,75 bpw oder ExLlamaV3 mit 4,0 bpw; beide erreichen fast 150 Tok/S bei den höchsten Qualitätsbewertungen.
- Bekannte, OpenAI-kompatible Lösung ohne eigene Konfiguration: vLLM – etwa 67 Tok/S pro Stream.
- Achtung auf VRAM: Vier der fünf Systeme erreichen einen Spitzenwert von über 27 GiB; verwenden Sie daher bei Möglichkeit die integrierte GPU des Desktops.