Тесты производительности локальных LLM на RTX 5090: тот же Qwen3.8-27B, от 67 до 253 токенов в секунду.
Qwen3.8-27B на одной карте RTX 5090 с использованием TensorFold, NInfer, ExLlamaV3, Qwentin и vLLM: декодирование, предзаполнение, параллельная производительность, качество и выбор подходящей среды выполнения.
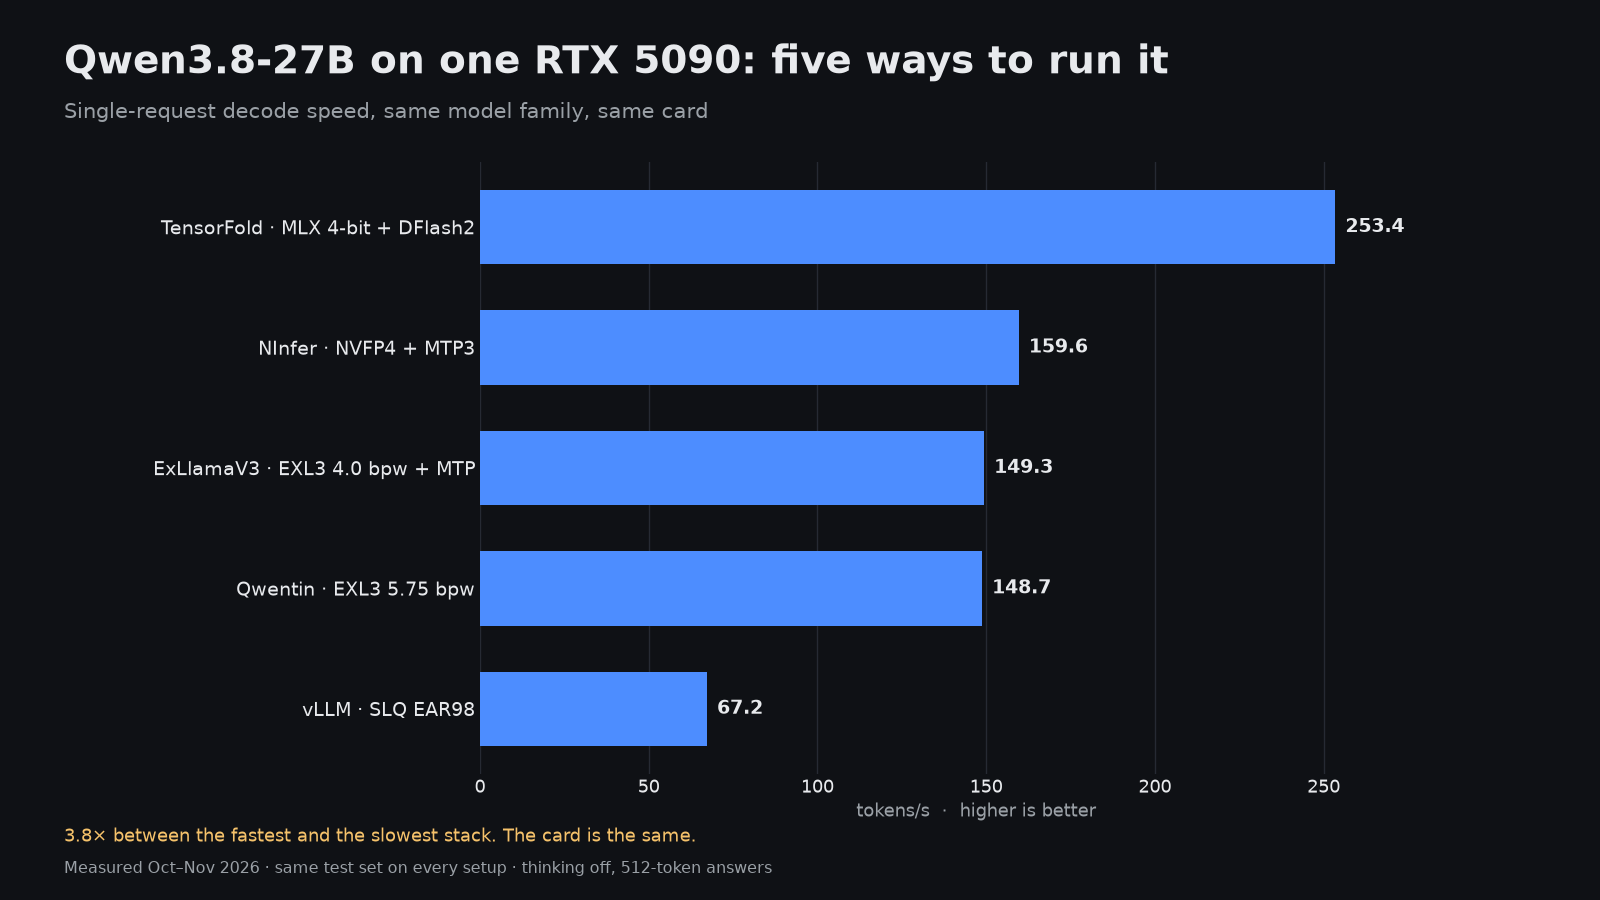
Если использовать тот же Qwen3.8-27B на той же карте RTX 5090, скорость обработки может составлять от 67,2 до 253,4 токенов в секунду. Разница обусловлена движком, методом квантования и способом спекулятивной декодировки. Пять полных конфигураций, приведённых ниже, были протестированы с использованием одинакового оборудования и набора инструментов для оценки качества, поэтому сравнение касается исключительно программного стека, а не аппаратного обеспечения.
Карта представляет собой одну карту RTX 5090 объёмом 32 ГБ. Скорость декодирования — это медианное значение для ответов длиной 512 токенов при использовании как кодовых, так и прозаических запросов; время заполнения предварительных данных и время генерации первого токена измеряется при объёмах данных 2 К, 8 К и 32 К токенов; параллельная пропускная способность — это общее количество токенов в секунду при одновременной обработке 1, 2, 4 и 8 запросов.
Пять вариантов настройки для одной модели
| Инструмент | Квантование | Скорость декодирования, токены/с | Код / проза | Заполнение памяти 8K, токены/с | Первый токен при объеме 32K | Средняя качество | Максимальный контекст | Максимальное использование VRAM |
|---|---|---|---|---|---|---|---|---|
| TensorFold + DFlash2 | MLX 4-бит | 253,4 | 268,2 / 238,7 | 5 033 | 7,7 с | 62,9 % | 256K | 27,3 ГиБ |
| NInfer + MTP3 | NVFP4 | 159,6 | 169.0 / 150.1 | 10,628 | 3.6 с | 65.3 % | 240,000 | 28.9 ГиБ |
| ExLlamaV3 + MTP | EXL3 4.0 bpw | 149.3 | 154.5 / 144.2 | 3,484 | 10.5 с | 67.6 % | 128K | 18.9 ГиБ |
| Qwentin + MTP | EXL3 5.75 bpw | 148.7 | 158.3 / 139.2 | 2,569 | 13.7 с | 67.9 % | 128K | 29.7 ГиБ |
| vLLM, без спекулятивного декодирования | SLQ EAR98 | 67.2 | 67.2 / 67.1 | 3,803 | 9.5 с | 64.3 % | 74,752 | 29.5 ГиБ |
Спекулятивное декодирование объясняет большую часть разницы
vLLM обрабатывает эту модель без спекуляций и достигает скорости 67,2 токена в секунду, причем скорость обработки кода и прозы составляет около 0,1 токена в секунду. Это примерно та скорость, которую показывает карта при обработке каждого токена с использованием полной модели. Остальные четыре решения сначала генерируют предварительные варианты токенов заранее, а затем проверяют их в один проход, и именно поэтому скорость их работы увеличивается в 2–4 раза.
Методы различаются. NInfer использует головы MTP3 с дополнительной головой lm-head для генерации предварительных вариантов, и 52,8% из этих вариантов принимаются. TensorFold применяет отдельный механизм DFlash2 для генерации предварительных вариантов; принимается лишь 20,0% из них, но каждый проход проверки достаточно дешев, поэтому он все равно значительно опережает остальные в режиме однопоточной декодировки. При использовании любого из спекулятивных решений код обрабатывается быстрее прозы (268,2 против 238,7 токена в секунду на TensorFold), поскольку код более предсказуем, и предварительные варианты генерируются чаще.
Prefill рассказывает другую историю
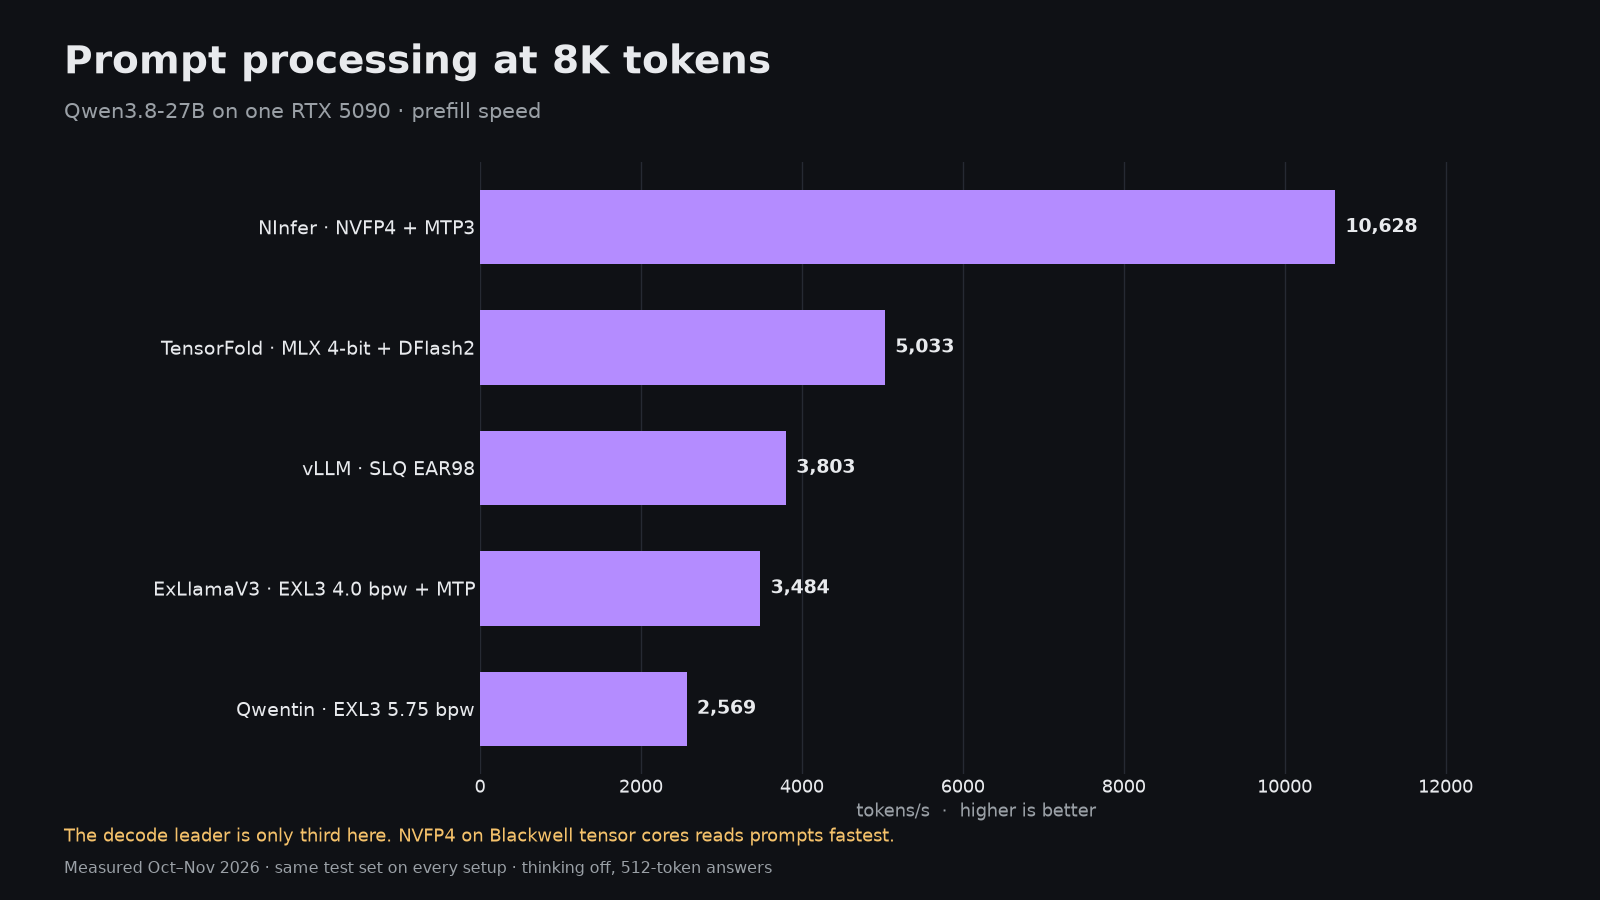
При сортировке по скорости обработки промптов порядок меняется. NInfer с технологией NVFP4 обрабатывает промпт объемом 8K токенов со скоростью 10,628 токенов в секунду и возвращает первый токен промпта объемом 32K токенов за 3,6 секунды. TensorFold занимает второе место со скоростью 5,033 токенов в секунду, за ним следуют vLLM с скоростью 3,803 токена в секунду, ExLlamaV3 — с скоростью 3,484 токена в секунду, и Qwentin — с скоростью 2,569 токенов в секунду. Что касается агентов для программирования, которые пересылают большие объемы контекста, то NInfer экономит несколько секунд на каждый раз взаимодействия по сравнению со всеми остальными решениями.
Обслуживание нескольких пользователей
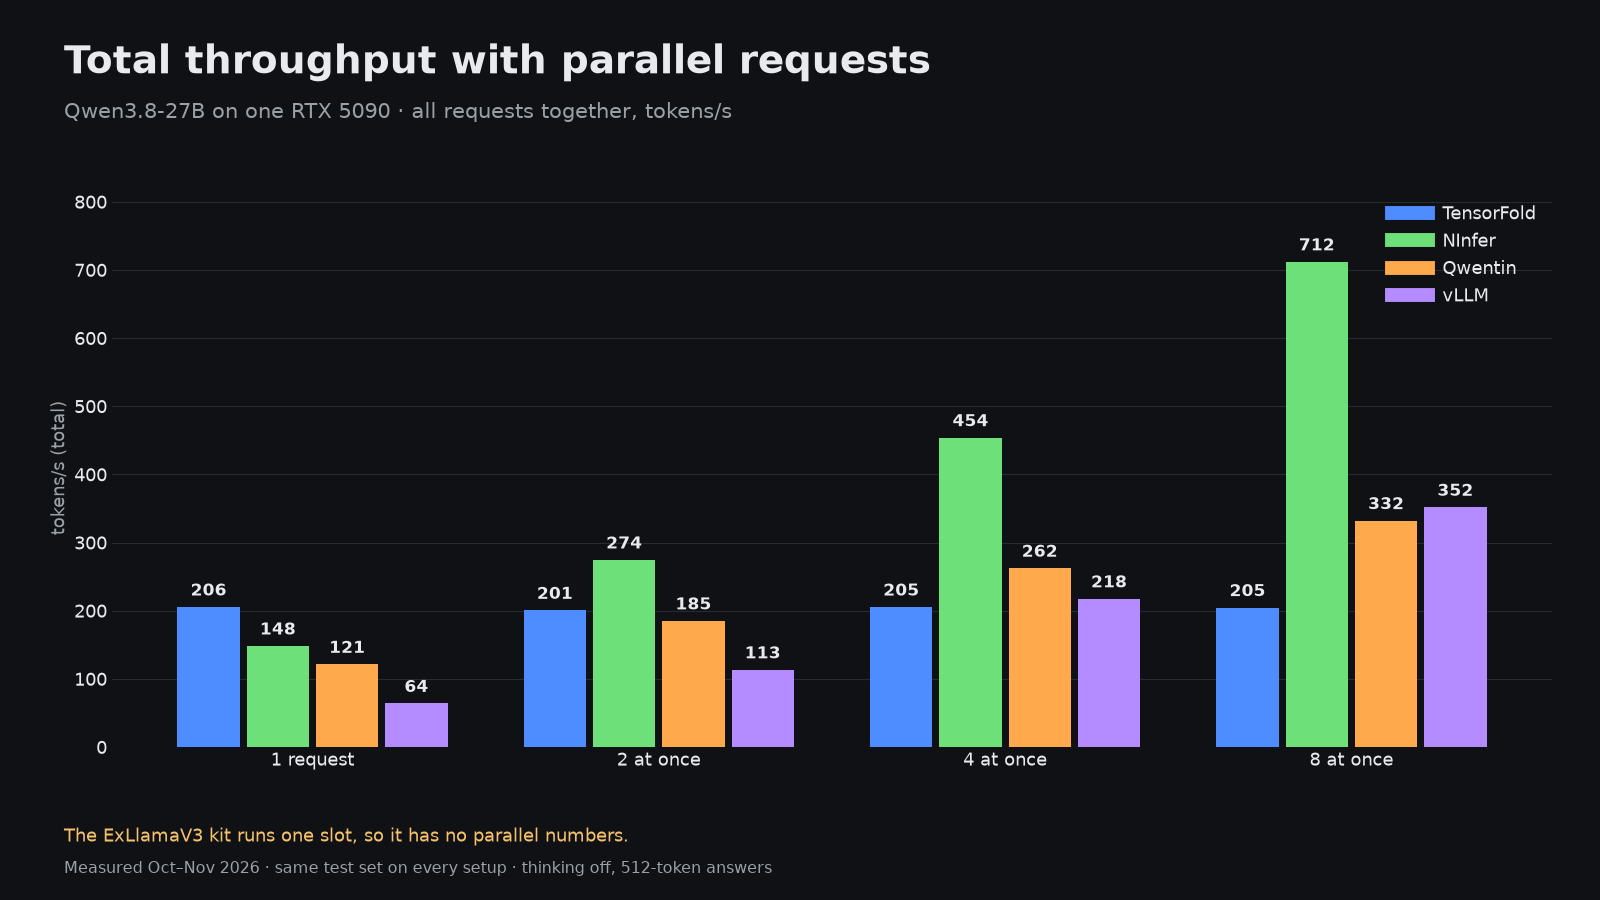
При восьми одновременных запросах NInfer обеспечивает общую пропускную способность 711,9 токов в секунду, vLLM — 351,8, а Qwentin — 332,2. TensorFold сохраняет показатель около 204,6 токов в секунду независимо от количества запросов, а набор ExLlamaV3 обрабатывает лишь один запрос за раз. Если система предназначена для работы команды, нескольких агентов или цикла оценки, NInfer является явным выбором; если же она предназначена для одного пользователя, то лучше подойдет TensorFold.
Снижается ли качество ответов при использовании более быстрой версии?
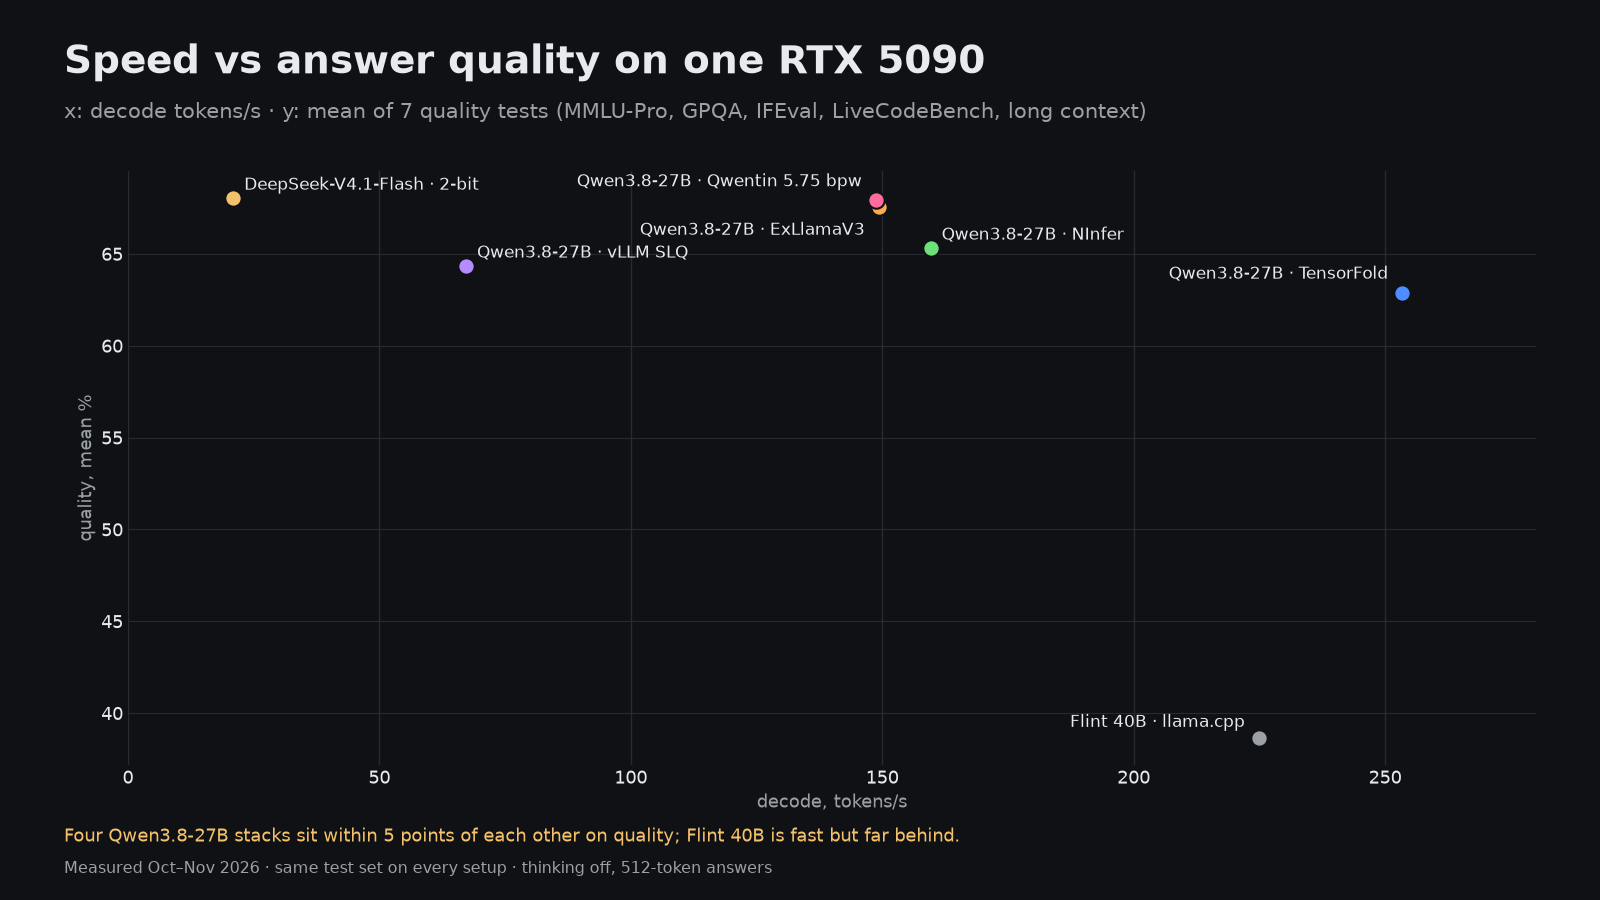
Этот показатель в некоторой степени отражает уровень квантования больше, чем характеристики самого движка. Версия Qwentin с показателем 5,75 битов на операцию декодирования показала наивысший результат — 67,9%, за ней следует ExLlamaV3 с показателем 4,0 битов на операцию декодирования и результатом 67,6%, NInfer NVFP4 — 65,3%, vLLM SLQ — 64,3%, а TensorFold MLX 4-bit — 62,9%. Отдельные тесты имеют разницу в несколько пунктов, поэтому различия между соседними значениями можно считать шумом; разница в 5 пунктов от самого высокого до самого низкого результата действительна, но незначительна по сравнению с разницей в скорости в 3,8 раза.
Другие модели, которые стоит знать для оперативной памяти 32 ГБ
- Nemotron 3.5 Bolt 74B-A9B в TensorFold декодирует текст со скоростью 242,7 токена/сек и обрабатывает 8K-запросов со скоростью 11 014 токенов/сек при использовании 30,2 ГБ памяти. Его скорость измерялась, но рейтинг ещё не присвоен; средний показатель качества по проведённым тестам составляет 56,9 %.
- Flint 40B NVFP4 в llama.cpp работает со скоростью 224,9 токена/сек при контексте объёмом 256 КБ, однако средний показатель качества у него составляет всего 38,6 %.
- DeepSeek-V4.1-Flash — модель объёмом 340 ГБ — работает на этой видеокарте через Project Maya, причём большая часть ресурсов перенаправляется на 96 ГБ ОЗУ и 4 ТБ NVMe-накопителя. Она декодирует текст со скоростью 20,9 токена/сек и показывает результат 68,0 %, что является лучшим показателем качества среди всех устройств с 32 ГБ памяти. Работает медленно, но функционирует.
Видео и изображения на RTX 5090
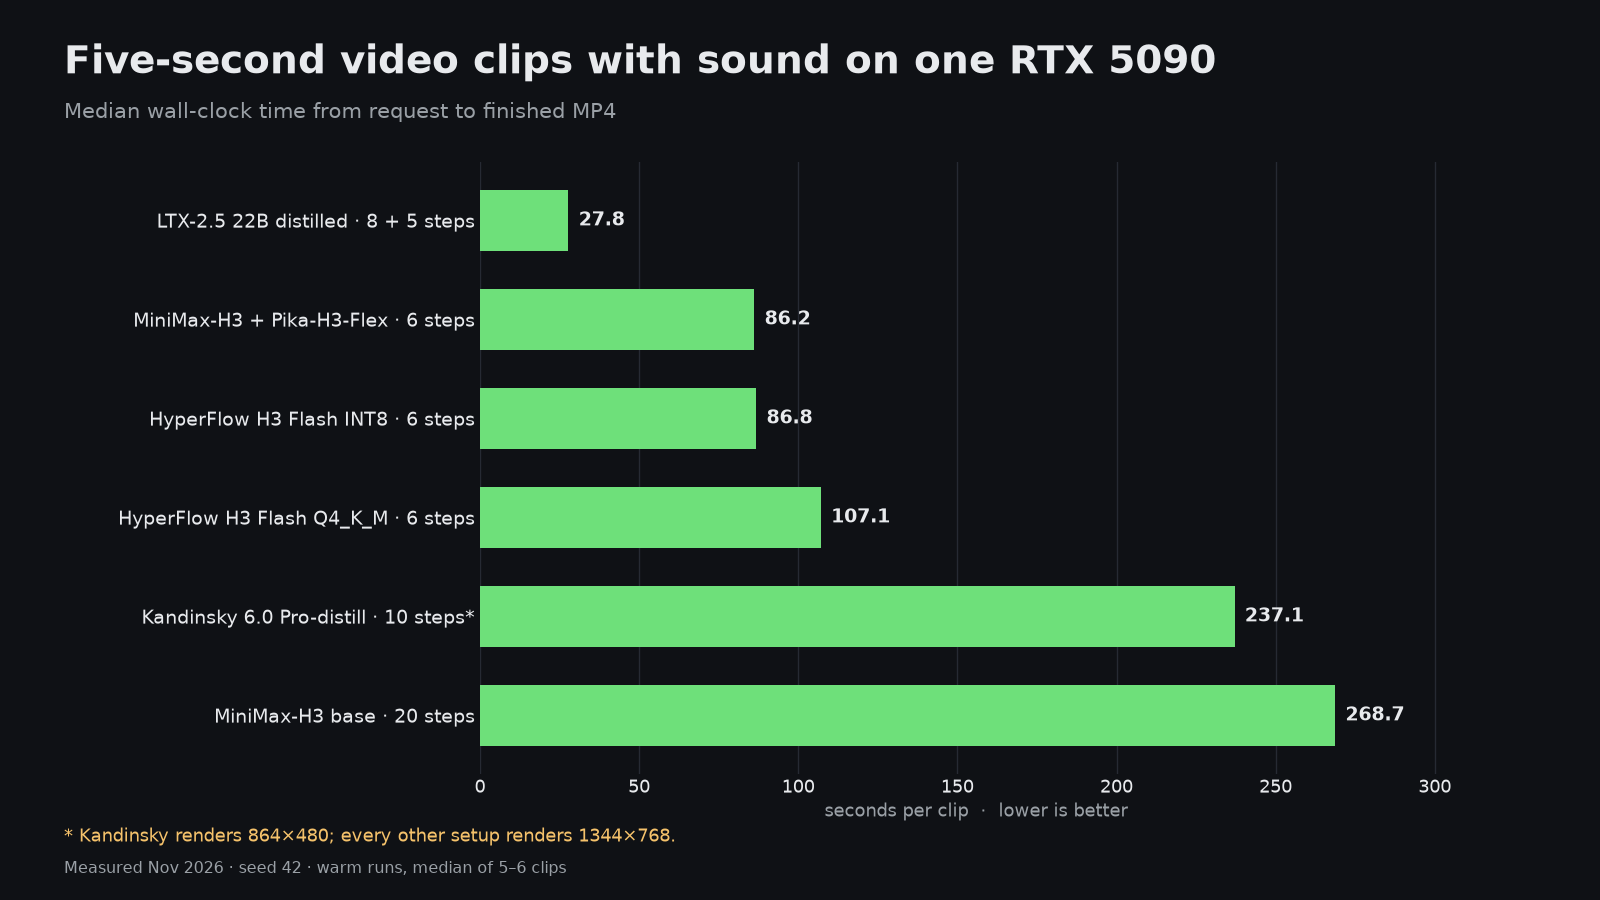
Эта же карта является мощным инструментом для обработки видео. Модель LTX-2.5 22B с методом дистилляции завершает обработку 5-секундного клипа в разрешении 1344×768 с звуком за 27,8 секунды. MiniMax-H3 с методом дистилляции Pika-H3-Flex требует 86,2 секунды, HyperFlow H3 Flash INT8 — 86,8 секунды, а базовая модель MiniMax-H3 с 20 шагами обработки — 268,7 секунды. Для статичных изображений FLUX Klein требует 1,96 секунды на изображение, Qwen-Image 2.1 — 7,64 секунды, а MOSS — 12,81 секунды.
Какой набор выбрать
- Для одного пользователя, чата и программирования: TensorFold с DFlash2 со скоростью обработки 253,4 токена в секунду и контекстом объемом 256 Кб.
- Агенты, RAG или несколько пользователей: NInfer с NVFP4 — 10 628 токов/с при предзаполнении и 711,9 токов/с при восьми запросах.
- Лучшие ответы при хорошей скорости: Qwentin EXL3 5,75 бп/с или ExLlamaV3 4,0 бп/с; оба показывают скорость около 150 токов/с при максимальных оценках качества.
- Знакомый способ работы совместимый с OpenAI без необходимости в кастомной настройке: vLLM, принимающий примерно 67 токов/с на поток.
- Учитывайте объем VRAM: у четырех из пяти конфигураций пиковое значение превышает 27 ГБ, поэтому, если возможно, используйте встроенную графику на ноутбуке.