Сколько памяти нужно для локального ИИ? Скорости работы от 16 ГБ до 512 ГБ.
Измерялась скорость и качество работы локальных LLM на машинах с объемом памяти 16, 32, 128, 256 и 512 ГБ, что может запускаться в каждой категории, а также какие GPU, Mac и мини-ПК подходят для каждого случая.
Первый вопрос при создании любой локальной ИИ-системы — сколько памяти требуется, и честный ответ заключается в том, что память определяет, какие модели будут загружаться, в то время как аппаратное обеспечение определяет скорость их работы. Ниже приведены результаты тестирования шести категорий памяти: от игровой карты на 16 ГБ до кластера GB10 из четырех устройств с общим объемом памяти 512 ГБ; во всех случаях использовалась одна и та же сборка тестов.
Каждая категория тестировалась на одной эталонной машине. Другое аппаратное обеспечение с таким же объемом памяти будет загружать те же модели, но скорость их работы будет отличаться, поэтому приведенные ниже списки подходящего оборудования касаются лишь совместимости, а не скорости работы.
Шесть категорий, шесть эталонных машин
| Категория памяти | Тестировалось на | Конфигурации | Полная оценка | Самая быстрая декодировка | Лучшее качество |
|---|---|---|---|---|---|
| 16 ГБ | RTX 5060 Ti 16 ГБ | 5 | 1 | Flint 40B, 115,9 ток/с | Qwen3.8-27B, 66,1 % |
| 32 ГБ | RTX 5090 32 ГБ | 12 | 9 | Qwen3.8-27B, 253,4 ток/с | DeepSeek-V4.1-Flash-1017, 68,0 % |
| 128 ГБ | 1× DGX Spark (GB10) | 15 | 9 | Nemotron 3.5 Lightning 30B-A3B, 141,9 ток/с | Ornith-1.5-122B, 70,8 % |
| 256 ГБ | 2× DGX Spark (GB10) | 9 | 5 | DeepSeek-V4.1-Flash-1017, 70,6 ток/с | DeepSeek-V4.1-Flash-1017, 69,1 % |
| 256 ГБ Mac | Mac Studio M5 Ultra 256 ГБ | 8 | 4 | Nemotron 3.5 Lightning 30B-A3B, 306,9 ток/с | DeepSeek-V4.1-Flash-1017, 69,7 % |
| 512 ГБ | 4× DGX Spark (GB10) | 5 | 4 | DeepSeek-V4.1-Flash-1017, 81,8 ток/с | DeepSeek-V4.1-Flash-1017, 66,7 % |
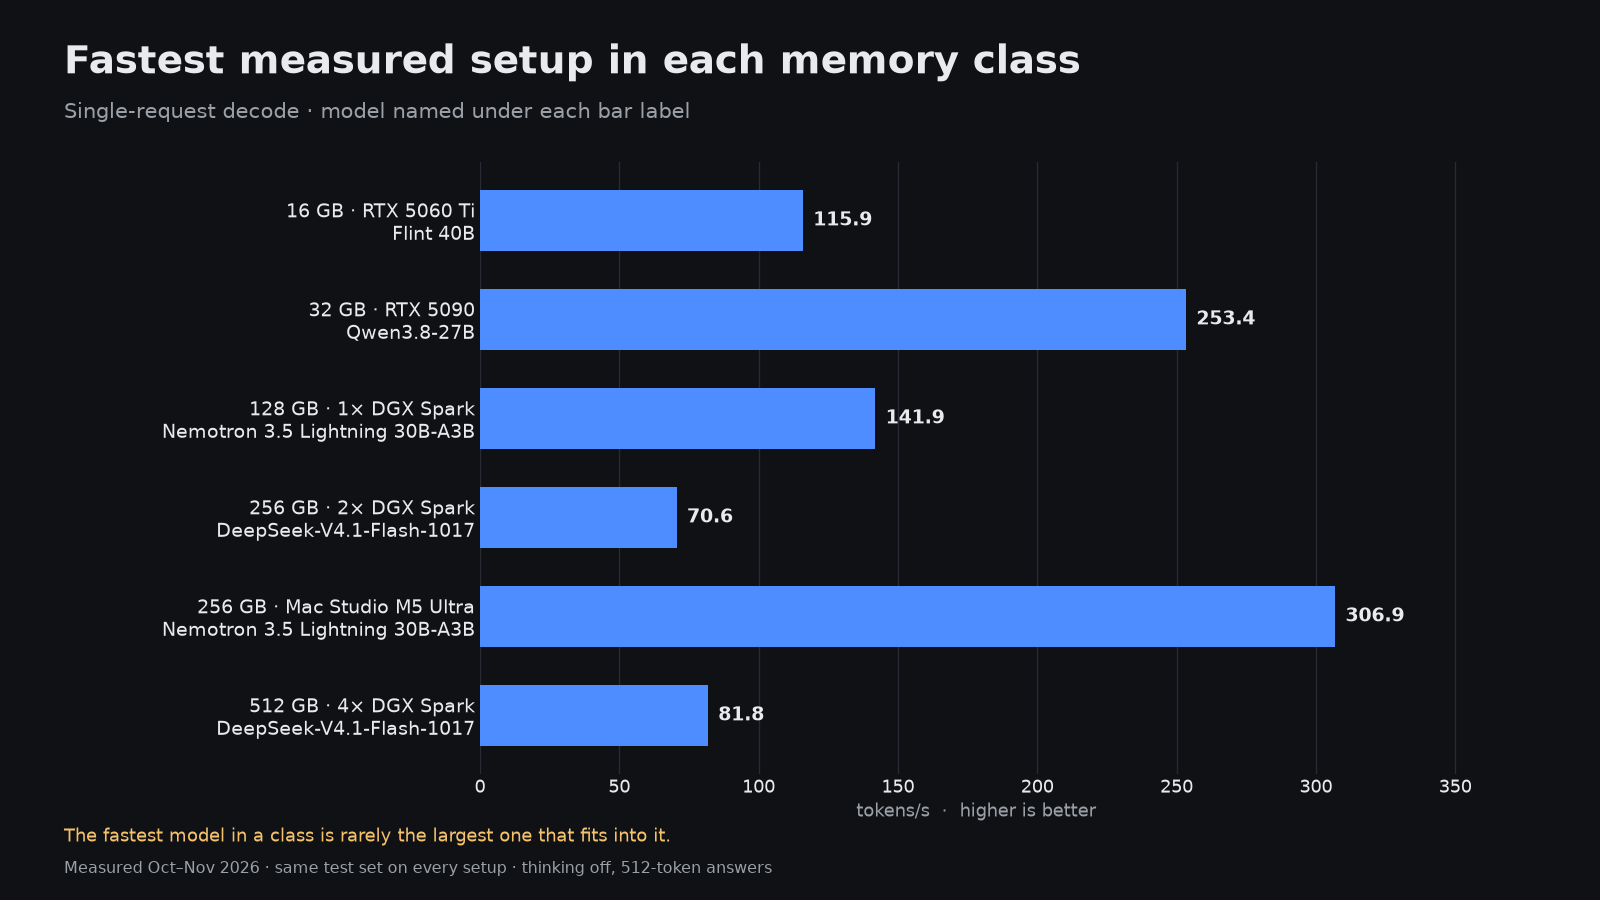
Наилучший результат в каждом классе составляет 115,9 ток/с для 16 ГБ, 253,4 для 32 ГБ, 141,9 для одного узла Spark, 70,6 для двух узлов Spark, 306,9 для Mac и 81,8 для четырех узлов Spark. Классы с большим объемом памяти выглядят медленнее из-за того, что в них обычно используются гораздо более крупные модели, а крупные модели декодируются медленнее.
Качество едва зависит от объема памяти
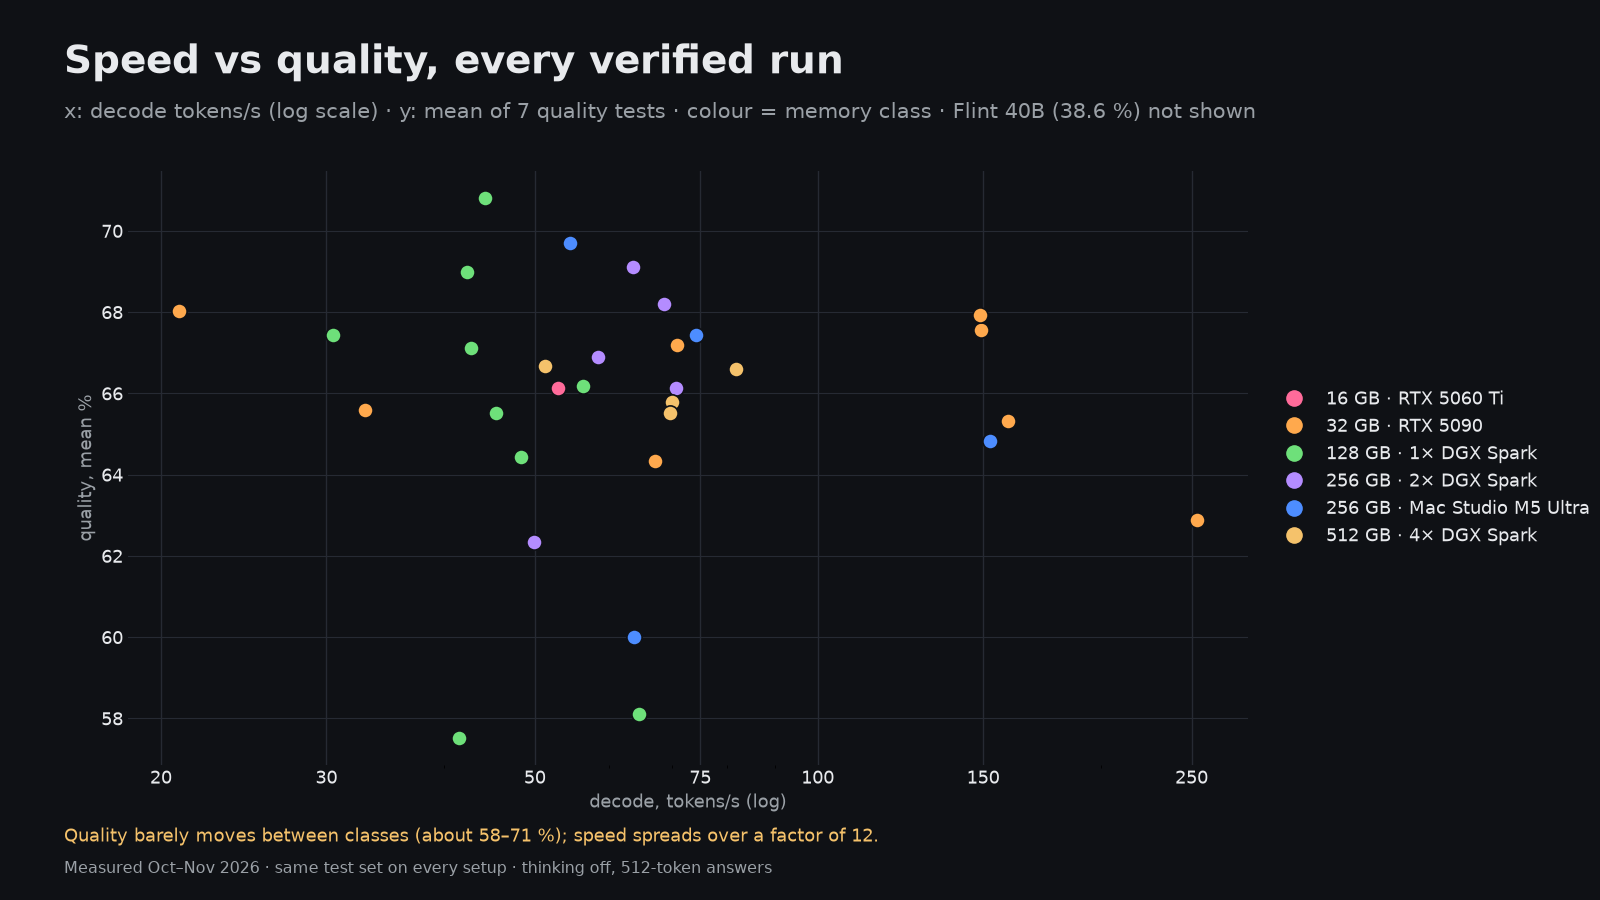
Для всех полностью протестированных вариантов диапазон качества довольно узок: все 31 вариант показывают результаты примерно от 57 до 71%, независимо от того, работают ли они с картой памяти объемом 16 ГБ или кластером объемом 512 ГБ. Модель Qwen3.8-27B на карте 5060 Ti показывает результат 66,1%, а модель DeepSeek-V4.1-Flash на четырех устройствах Sparks — 66,6%. Больший объем памяти в основном позволяет увеличить длину контекста, количество одновременных пользователей и дает возможность запускать очень крупные модели типа MoE.
Одна крупная модель при четырех уровнях бюджета
| Конфигурация | Уровень квантования | Скорость декодирования, токов/сек | Скорость предзаполнения 8K, токов/сек | Среднее качество | Максимальное использование памяти |
|---|---|---|---|---|---|
| RTX 5090 + перенос обработки в RAM/NVMe | Maya-S IQ2_XXS | 20.9 | 828 | 68.0 % | 30.9 GiB |
| Mac Studio M5 Ultra | MLX 2/3-bit (e2e3-p4-h8) | 74.2 | 1,763 | 67.4 % | 206.3 GiB |
| 2× DGX Spark | EXL3 2.5 bpw | 70.6 | 2,157 | 66.1 % | 98.7 GiB |
| 4× DGX Spark | EXL3 4.0 bpw | 81.8 | 2,016 | 66.6 % | 103.2 GiB |
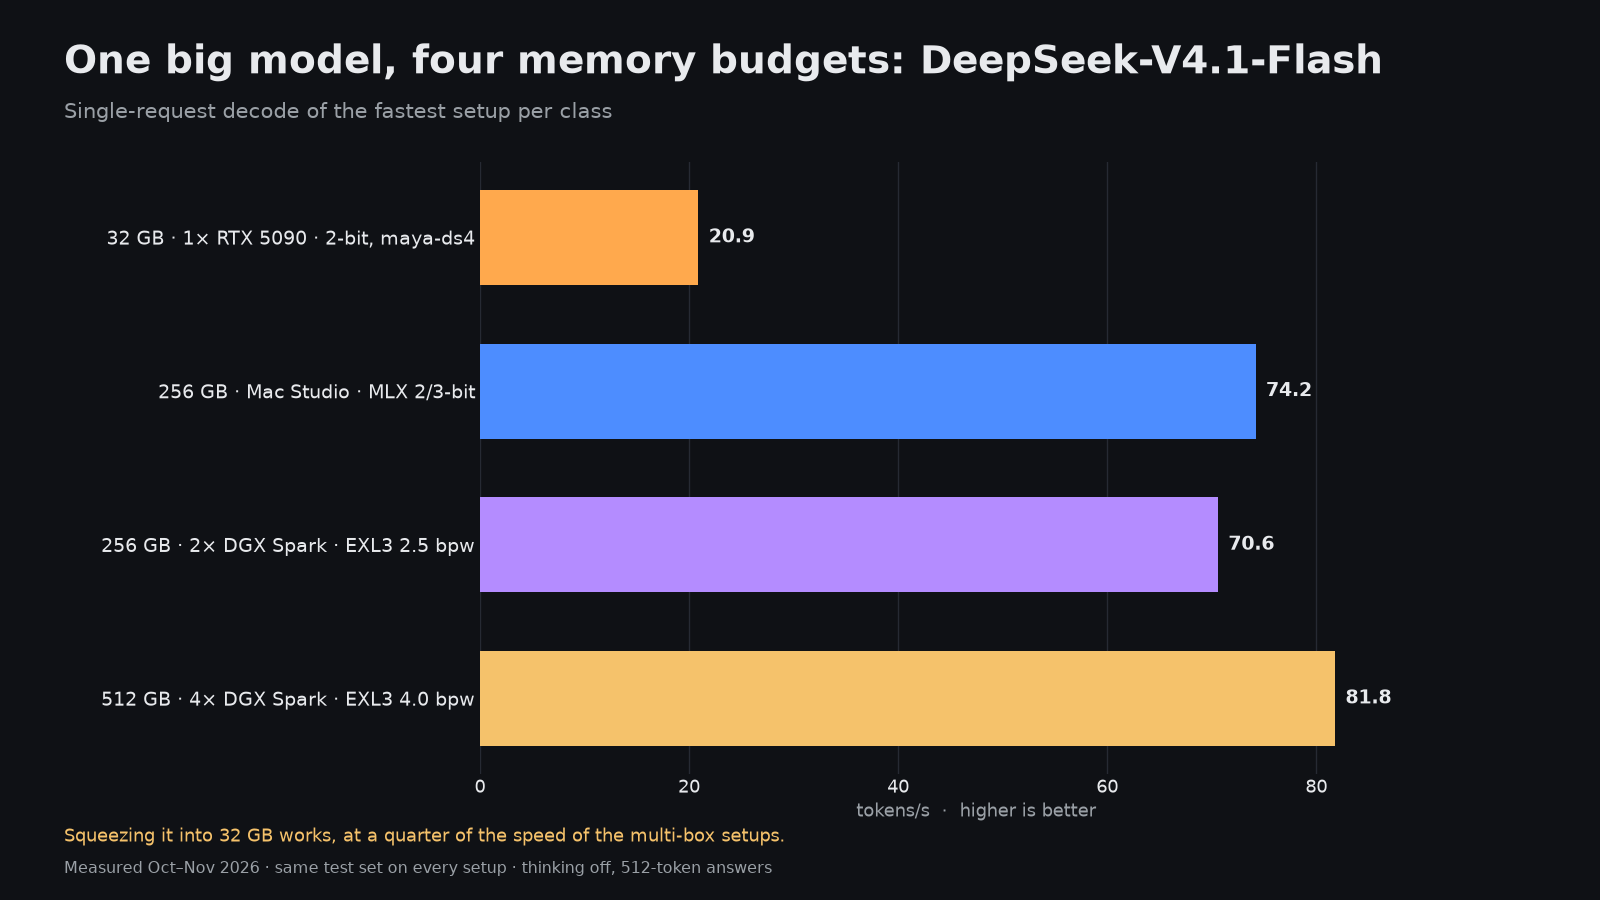
DeepSeek-V4.1-Flash — это модель объемом 340 ГБ, производительность которой измерялась на четырех совершенно разных конфигурациях. На одной карте RTX 5090 с 96 ГБ ОЗУ и NVMe-накопителем, содержащим большинство моделей экспертов, скорость декодирования составляет 20.9 токов/сек. На Mac скорость — 74.2 тока/сек, на двух устройствах Spark — 70.6 тока/сек, а на четырех — 81.8 тока/сек. Все четыре варианта показывают результаты в диапазоне от 66.1 до 68.0 %. Перенос обработки на внешние устройства позволяет запустить модель, которую невозможно запустить напрямую, но со скоростью, в четыре раза меньшей.
Контекст также потребляет память
Веса модели — это лишь часть расходов. Qwen3.8-27B EXL3 4.0 bpw на карте RTX 5090 достигает пика в 18,9 ГиБ при объеме контекста 128 К. Та же модель, разделенная между двумя картами 5060 Ti, позволяет использовать контекст объемом 256 К при объеме памяти 22,4 ГиБ. Qwen3.8-Flash-Next на двух картах Sparks загружает контекст объемом 1 млн токенов при объеме памяти 87,9 ГиБ. На карте с объемом памяти 16 ГБ разница в объеме контекста для одной и той же модели — от 43 008 до 117 760 токенов — обусловлена способом квантования и обработкой кэша движком.
Каков уровень вашего оборудования
16–24 ГБ
RTX 5080, RTX 5070 Ti, RTX 5060 Ti 16 GB, RTX 4090, RTX 4080 Super, RTX 4080, RTX 4070 Ti Super, RTX 4060 Ti 16 GB, RTX 3090 Ti, RTX 3090, RTX PRO 4000 Blackwell, RTX 4500 Ada, RTX 4000 Ada, Radeon RX 9070 XT, Radeon RX 9070, Radeon RX 9060 XT 16 GB, Radeon RX 9060 XT LP, Radeon RX 7900 XTX, Radeon RX 7900 XT, Radeon RX 7900 GRE, Radeon RX 7800 XT, Radeon RX 7600 XT, Radeon RX 6950 XT, Radeon RX 6900 XT, Radeon RX 6800 XT, Radeon RX 6800. Эти видеокарты используют те же параметры квантования класса 27B и режимы MoE с переносом данных, что и эталонная модель RTX 5060 Ti 16 GB. Видеокарты с объемом памяти 24 ГБ, такие как RTX 4090, 3090 и RX 7900 XTX, позволяют использовать более длинный контекст или более высококачественное квантование, но не изменяют уровень модели.
От 32 до 96 ГБ
RTX 5090, RTX PRO 6000 Blackwell, RTX PRO 5000 Blackwell 72 ГБ, RTX PRO 5000 Blackwell 48 ГБ, RTX PRO 4500 Blackwell, RTX 6000 Ada, RTX 5000 Ada, RTX A6000, Radeon AI PRO R9700, Radeon AI PRO R9600D, Radeon PRO W7900, Radeon PRO W7800 32 ГБ, Radeon PRO W7800 48 ГБ. У модели RTX 5090 объём памяти составляет 32 ГБ: модели с 27 миллиардами нейронов, работающие с 4–6 битами и имеющие объём контекста от 128 тыс. до 256 тыс., а также крупные модели с технологией MoE с переносом данных в оперативную память.
128 ГБ объединённой памяти
Framework Desktop, GMKtec EVO-X2, HP Z2 Mini G1a, ASUS ROG Flow Z13, Mac Studio M5 Max, MacBook Pro M5 Max, NVIDIA DGX Spark, ASUS Ascent GX10, MSI EdgeXpert, Gigabyte AI TOP ATOM, Lenovo ThinkStation PGX, Acer Veriton GN100, HP ZGX Nano G1n, а также каждая коробка GB10: NVIDIA DGX Spark, ASUS Ascent GX10, Dell Pro Max с GB10, MSI EdgeXpert, Gigabyte AI TOP ATOM, Lenovo ThinkStation PGX, Acer Veriton GN100 и HP ZGX Nano G1n. Любое устройство из этой группы может запускать модели объемом 120 млрд параметров, тестированные на одном Spark; Mac-компьютеры и устройства AMD Strix Halo будут выполнять их со своей собственной скоростью.
256 ГБ и более
Mac Studio M5 Ultra с объемом памяти 256 или 512 ГБ, или две и четыре коробки GB10, соединенные через ConnectX-7. Это уровень для модели DeepSeek-V4.1-Flash объемом 340 ГБ и аналогичных по размеру моделей без возможности переноса вычислений на внешние устройства.
Выбор класса
- Чат, помощь с программированием и транскрипция для одного пользователя: 16 ГБ достаточно, 32 ГБ — более комфортно и значительно быстрее.
- Агенты для работы с длинными контекстами и несколько пользователей на одном устройстве: 32 ГБ на RTX 5090 с движком обработки пакетов данных.
- Модели объемом свыше 100 миллиардов параметров без возможности переноса вычислений: 128 ГБ объединенной памяти; если важна скорость, лучше использовать Mac, а если вы работаете с CUDA — Spark.
- Крупнейшие открытые модели типа MoE при приемлемой скорости работы: Mac Studio с 256 ГБ памяти или два–четыре устройства GB10.
- Прежде чем покупать дополнительную память, проверьте, не сможет ли улучшенный движок или алгоритм квантования на вашем существующем оборудовании устранить недостатки. На том же RTX 5090 один только измененный программный стек увеличил скорость почти в 4 раза.