Скільки пам’яті потрібно для локального ШІ? Швидкість роботи від 16 ГБ до 512 ГБ.
Вимірювання швидкості та якості локальних LLM на пристроях з об’ємом пам’яті 16, 32, 128, 256 та 512 ГБ, що може виконуватися в кожній категорії, а також які GPU, Mac та міні-ПК підходять для кожного випадку.
Перше питання при створенні локального ШІ — це кількість пам’яті, яка потрібна, і чесна відповідь полягає у тому, що саме пам’ять визначає, які моделі будуть завантажуватися, тоді як апаратне забезпечення впливає на швидкість їхньої роботи. Нижче наведені результати вимірювань для шести класів пам’яті — від ігрової картки на 16 ГБ до кластера GB10 з чотирма пристроями та об’ємом пам’яті 512 ГБ, причому для всіх випробувань використовувався однаковий набір тестів.
Кожен клас пам’яті тестувався на одній базовій машині. Інше апаратне забезпечення з такою ж кількістю пам’яті також буде завантажувати ті самі моделі, але швидкість їхньої роботи буде відрізнятися, тому списки відповідного обладнання, наведені нижче, стосуються лише сумісності, а не швидкості роботи.
Шість класів, шість базових машин
| Клас пам’яті | Тестування на | Конфігурації | Повна оцінка | Найшвидше декодування | Найкраща якість |
|---|---|---|---|---|---|
| 16 ГБ | RTX 5060 Ti 16 ГБ | 5 | 1 | Flint 40B, 115,9 tok/с | Qwen3.8-27B, 66,1 % |
| 32 ГБ | RTX 5090 32 ГБ | 12 | 9 | Qwen3.8-27B, 253,4 tok/с | DeepSeek-V4.1-Flash-1017, 68,0 % |
| 128 ГБ | 1× DGX Spark (GB10) | 15 | 9 | Nemotron 3.5 Lightning 30B-A3B, 141,9 tok/с | Ornith-1.5-122B, 70,8 % |
| 256 ГБ | 2× DGX Spark (GB10) | 9 | 5 | DeepSeek-V4.1-Flash-1017, 70,6 tok/с | DeepSeek-V4.1-Flash-1017, 69,1 % |
| 256 ГБ Mac | Mac Studio M5 Ultra 256 ГБ | 8 | 4 | Nemotron 3.5 Lightning 30B-A3B, 306,9 tok/с | DeepSeek-V4.1-Flash-1017, 69,7 % |
| 512 ГБ | 4× DGX Spark (GB10) | 5 | 4 | DeepSeek-V4.1-Flash-1017, 81,8 tok/с | DeepSeek-V4.1-Flash-1017, 66,7 % |
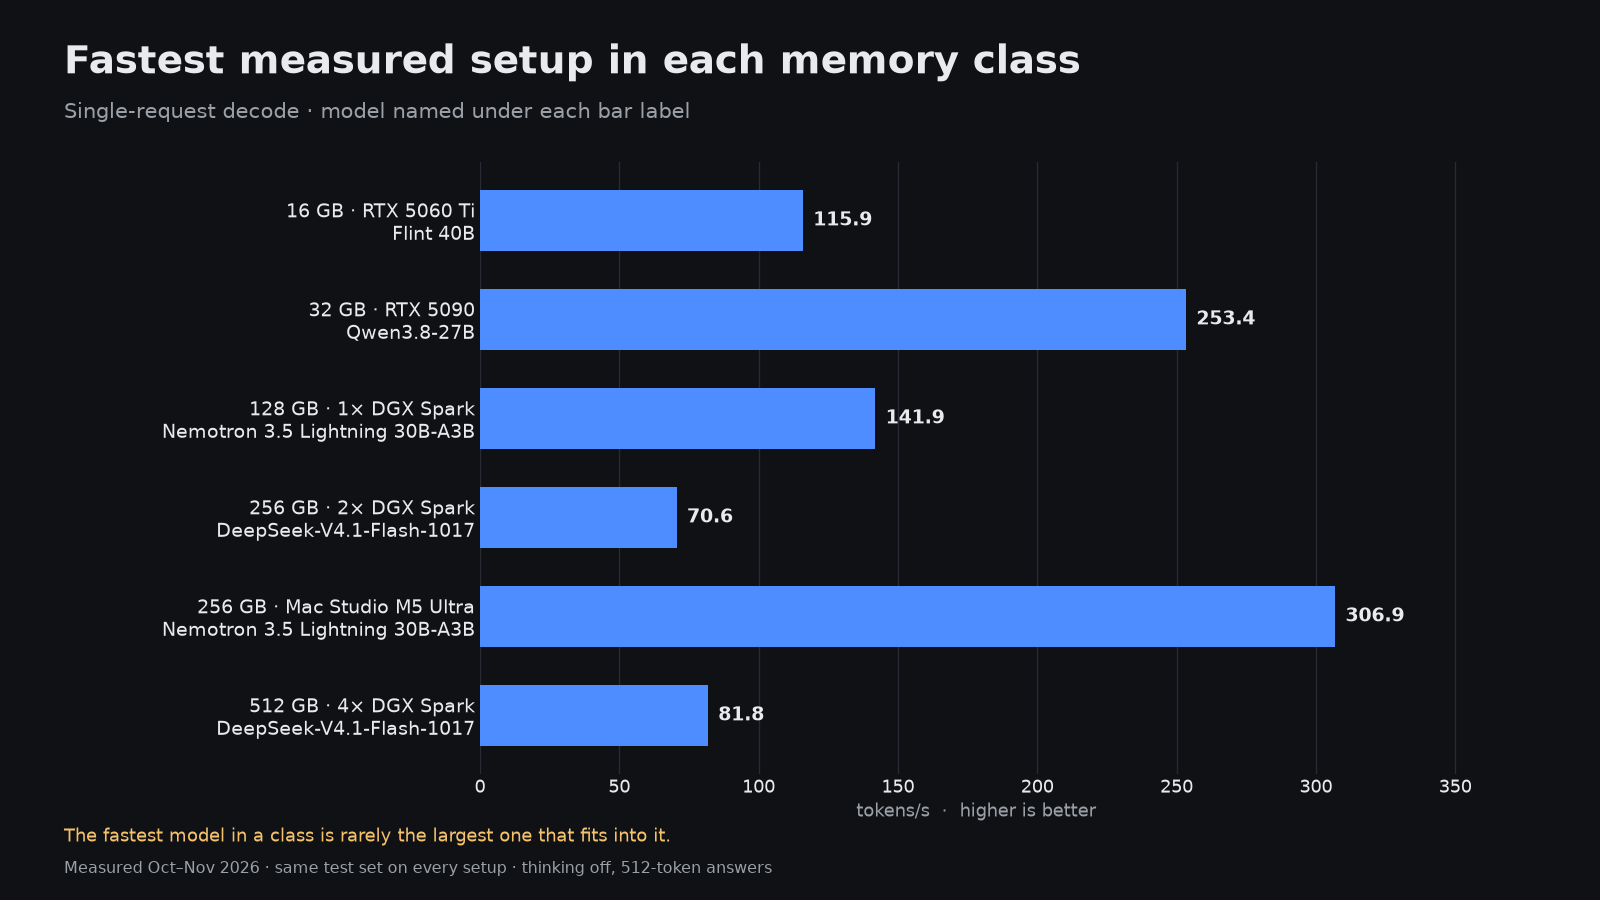
Найкращий результат у кожній класі становить 115,9 ток/с для 16 ГБ, 253,4 для 32 ГБ, 141,9 для одного Spark-кластера, 70,6 для двох Spark-кластерів, 306,9 для Mac та 81,8 для чотирьох Spark-кластерів. Класи з великою кількістю пам’яті виглядають повільнішими, оскільки вони здебільшого використовують значно більші моделі, а більші моделі декодуються повільніше.
Якість ледве залежить від кількості пам’яті
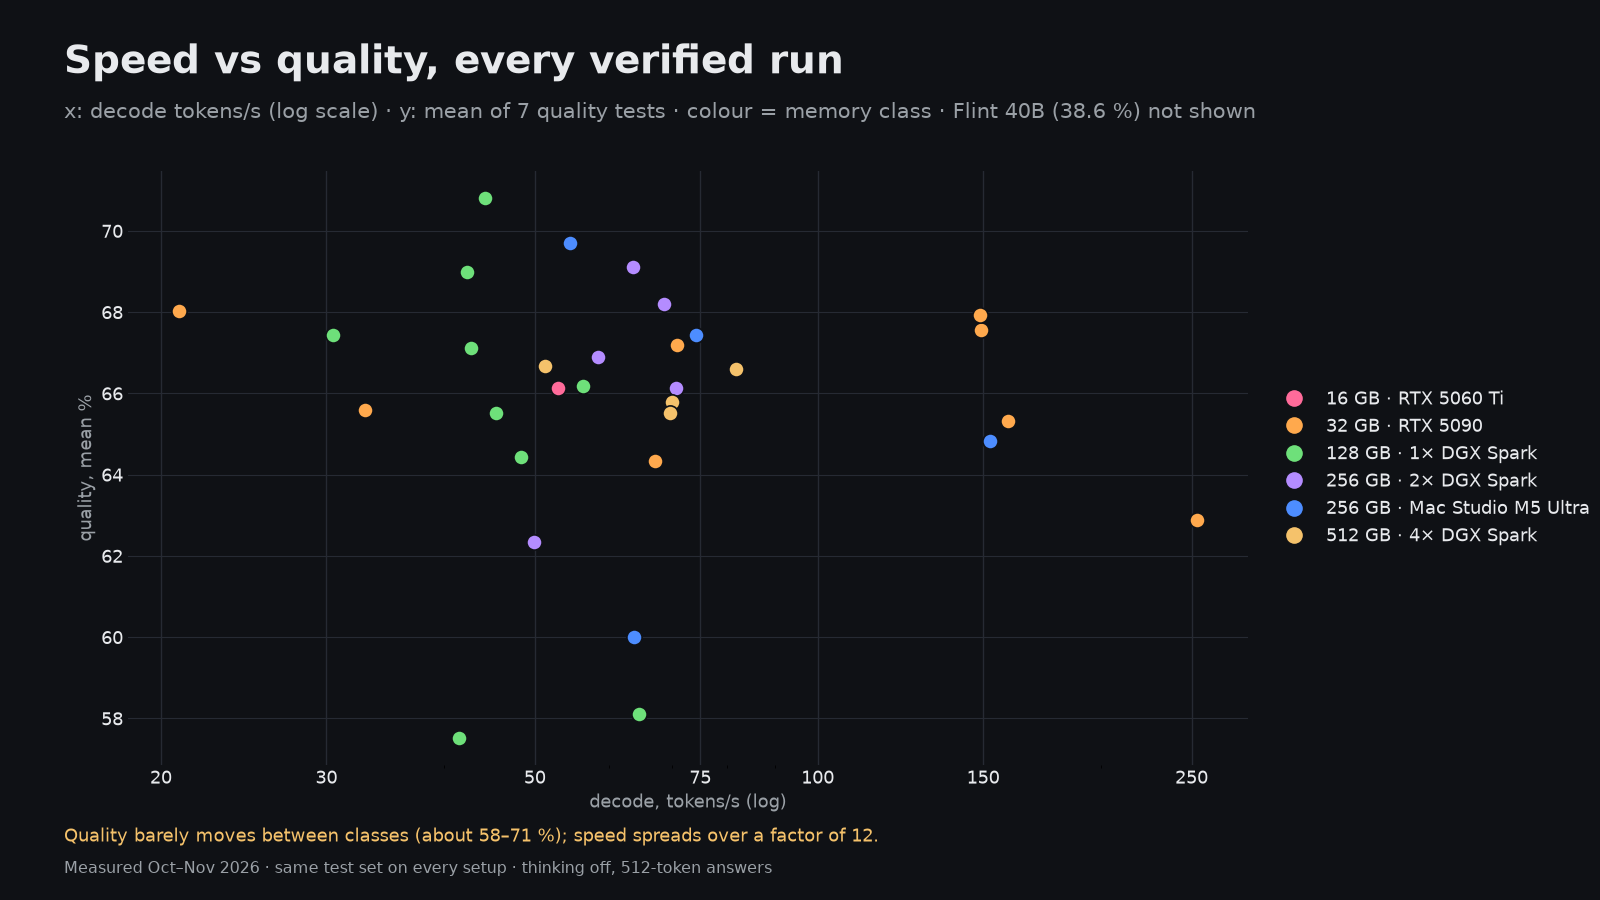
Усі тести, які пройдено повністю, мають вузький діапазон якості: усі 31 тест знаходяться приблизно в межах 57–71%, незалежно від того, чи виконуються вони на карті об’ємом 16 ГБ чи на кластері об’ємом 512 ГБ. Qwen3.8-27B на карті 5060 Ti дає результат 66,1%; DeepSeek-V4.1-Flash на чотирьох пристроях Sparks — 66,6%. Більший об’єм пам’яті здебільшого забезпечує більшу довжину контексту, можливість одночасної роботи з кількома користувачами та можливість запуску дуже великих моделей типу MoE.
Одна велика модель за чотирма бюджетами
| Конфігурація | Квантування | Швидкість декодування, tok/s | Швидкість попереднього заповнення 8K, tok/s | Середня якість | Максимальна кількість пам’яті |
|---|---|---|---|---|---|
| RTX 5090 + офлоад RAM/NVMe | Maya-S IQ2_XXS | 20.9 | 828 | 68.0 % | 30.9 GiB |
| Mac Studio M5 Ultra | MLX 2/3-bit (e2e3-p4-h8) | 74.2 | 1,763 | 67.4 % | 206.3 GiB |
| 2× DGX Spark | EXL3 2.5 bpw | 70.6 | 2,157 | 66.1 % | 98.7 GiB |
| 4× DGX Spark | EXL3 4.0 bpw | 81.8 | 2,016 | 66.6 % | 103.2 GiB |
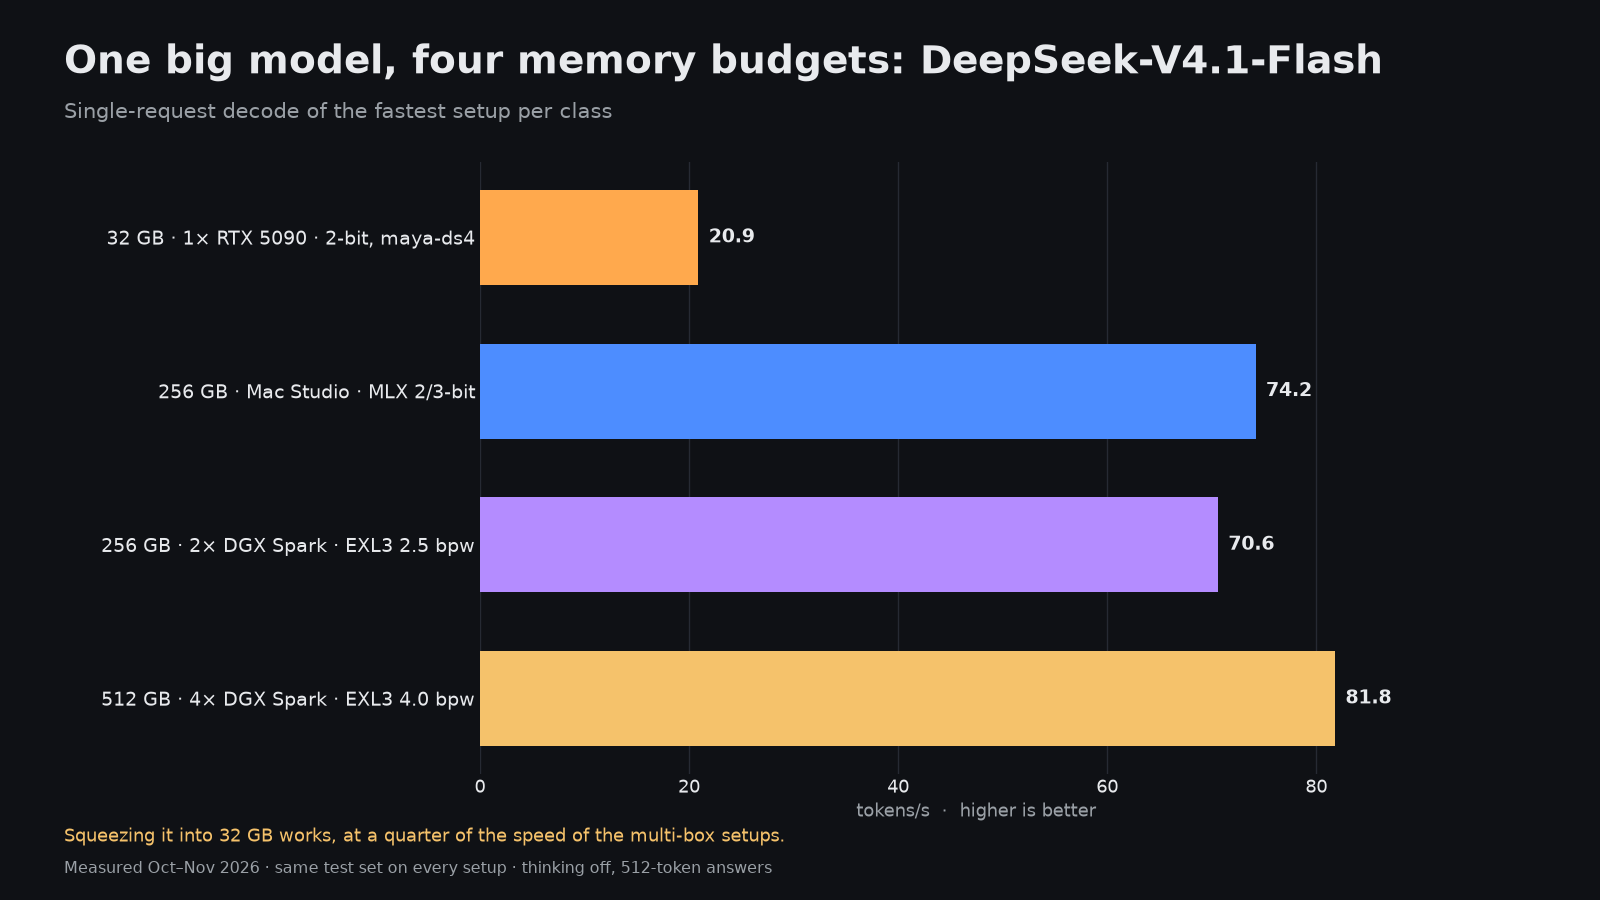
DeepSeek-V4.1-Flash — це модель об’ємом 340 ГБ, яку тестували на чотирьох абсолютно різних конфігураціях. На одній картці RTX 5090 з 96 ГБ оперативної пам’яті та диску NVMe, де зберігається більшість експертів, її швидкість декодування становить 20.9 tok/с. На Mac цей показник — 74.2, на двох пристроях Spark — 70.6, а на чотирьох — 81.8. Усі чотири варіанти показують результати в межах від 66.1 до 68.0 %. Використання зовнішньої пам’яті дозволяє запустити модель, яку неможливо запустити без неї, але зі швидкістю, що становить чверть від початкової.
Контекст також споживає пам’ять
Ваги моделі — це лише частина обмежень щодо ресурсів. Qwen3.8-27B EXL3 4.0 bpw на картці RTX 5090 досягає максимуму 18,9 ГіБ при обсязі контексту 128 К. Та сама модель, розподілена між двома картками 5060 Ti, дозволяє мати обсяг контексту 256 К при 22,4 ГіБ. Qwen3.8-Flash-Next на двох картках Sparks завантажує контекст обсягом 1 мільйон токенів при 87,9 ГіБ. На картці з пам’яттю 16 ГБ різниця у кількості токенів контексту для тієї самої моделі — від 43 008 до 117 760 — залежить від способу квантування та обробки кешу двигуна.
Яке місце займає ваше обладнання
16–24 ГБ
RTX 5080, RTX 5070 Ti, RTX 5060 Ti 16 GB, RTX 4090, RTX 4080 Super, RTX 4080, RTX 4070 Ti Super, RTX 4060 Ti 16 GB, RTX 3090 Ti, RTX 3090, RTX PRO 4000 Blackwell, RTX 4500 Ada, RTX 4000 Ada, Radeon RX 9070 XT, Radeon RX 9070, Radeon RX 9060 XT 16 GB, Radeon RX 9060 XT LP, Radeon RX 7900 XTX, Radeon RX 7900 XT, Radeon RX 7900 GRE, Radeon RX 7800 XT, Radeon RX 7600 XT, Radeon RX 6950 XT, Radeon RX 6900 XT, Radeon RX 6800 XT, Radeon RX 6800. Ці відеокарти використовують ті самі налаштування квантування класу 27B та моделі MoE з офлоадом, що й базова версія RTX 5060 Ti 16 GB. Відеокарти з об’ємом пам’яті 24 GB, такі як RTX 4090, 3090 та RX 7900 XTX, дозволяють використовувати більший контекст або квантування з вищою кількістю бітів, але не іншу категорію моделей.
32 до 96 GB
RTX 5090, RTX PRO 6000 Blackwell, RTX PRO 5000 Blackwell 72 GB, RTX PRO 5000 Blackwell 48 GB, RTX PRO 4500 Blackwell, RTX 6000 Ada, RTX 5000 Ada, RTX A6000, Radeon AI PRO R9700, Radeon AI PRO R9600D, Radeon PRO W7900, Radeon PRO W7800 32 GB, Radeon PRO W7800 48 GB. Рівень 32 GB належить до RTX 5090: моделі з 27 мільярдами нейронів, які працюють з 4 до 6 бітів та мають обсяг контексту від 128K до 256K, а також великі моделі типу MoE з можливістю перенесення даних у RAM.
128 GB об’єднаної пам’яті
Framework Desktop, GMKtec EVO-X2, HP Z2 Mini G1a, ASUS ROG Flow Z13, Mac Studio M5 Max, MacBook Pro M5 Max, NVIDIA DGX Spark, ASUS Ascent GX10, MSI EdgeXpert, Gigabyte AI TOP ATOM, Lenovo ThinkStation PGX, Acer Veriton GN100, HP ZGX Nano G1n, а також кожна коробка GB10: NVIDIA DGX Spark, ASUS Ascent GX10, Dell Pro Max з GB10, MSI EdgeXpert, Gigabyte AI TOP ATOM, Lenovo ThinkStation PGX, Acer Veriton GN100 та HP ZGX Nano G1n. Усе, що належить до цієї групи, може запускати моделі класу 120B, протестовані на одному Spark; Mac та пристрої AMD Strix Halo будуть виконувати їх у власному темпі.
256 ГБ та більше
Mac Studio M5 Ultra з 256 або 512 ГБ, або дві та чотири коробки GB10, під’єднані через ConnectX-7. Це рівень для моделей DeepSeek-V4.1-Flash об’ємом 340 ГБ та подібних за розміром без використання технології офлоаду.
Вибір класу
- Чат, допомога з програмуванням та транскрипція для однієї особи: 16 ГБ підходять, 32 ГБ — це зручно та значно швидше.
- Агенти для роботи з довгими контекстами та кілька користувачів на одному пристрої: 32 ГБ на RTX 5090 із двигуном обробки пакетів даних.
- Моделі об’ємом понад 100 мільярдів параметрів без можливості зовнішньої обробки: 128 ГБ єдиної пам’яті; якщо важлива швидкість, краще обрати Mac, а якщо ви використовуєте CUDA — Spark.
- Найбільші відкриті моделі типу MoE при прийнятній швидкості: Mac Studio з 256 ГБ пам’яті або два–чотири пристрої GB10.
- Перш ніж купувати більше пам’яті, перевірте, чи кращий двигун або алгоритм квантування на вашому обладнанні може подолати цю проблему. На тому самому RTX 5090 лише зміна програмного стеку підвищила швидкість майже у 4 рази.