Combien de mémoire faut-il pour une IA locale ? Vitesses allant de 16 Go à 512 Go.
Vitesse et qualité locales mesurées des LLM sur des machines de 16, 32, 128, 256 et 512 Go, ce que chaque catégorie peut exécuter, ainsi que les GPU, Macs et mini-PC compatibles avec chacune.
La première question à se poser lors de la création d’un système d’IA local concerne la quantité de mémoire nécessaire, et la réponse honnête est que c’est la mémoire qui détermine quels modèles seront chargés, tandis que le matériel sous-jacent influence leur vitesse de fonctionnement. Ci-dessous figurent des résultats mesurés pour six catégories de mémoire, allant d’une carte graphique de 16 GB à un cluster GB10 composé de quatre unités totalisant 512 GB, en utilisant partout le même ensemble de tests.
Chaque catégorie a été testée sur une machine de référence. D’autres matériels disposant de la même quantité de mémoire chargeront les mêmes modèles, mais leur vitesse sera différente ; par conséquent, les listes de matériel compatible présentées ci-après indiquent ce qui est compatible, et non la vitesse de fonctionnement.
Six catégories, six machines de référence
| Catégorie de mémoire | Machine de test | Configurations | Score total | Décodage le plus rapide | Meilleure qualité |
|---|---|---|---|---|---|
| 16 GB | RTX 5060 Ti 16 GB | 5 | 1 | Flint 40B, 115,9 tok/s | Qwen3.8-27B, 66,1 % |
| 32 GB | RTX 5090 32 GB | 12 | 9 | Qwen3.8-27B, 253,4 tok/s | DeepSeek-V4.1-Flash-1017, 68,0 % |
| 128 GB | 1× DGX Spark (GB10) | 15 | 9 | Nemotron 3.5 Lightning 30B-A3B, 141,9 tok/s | Ornith-1.5-122B, 70,8 % |
| 256 GB | 2× DGX Spark (GB10) | 9 | 5 | DeepSeek-V4.1-Flash-1017, 70,6 tok/s | DeepSeek-V4.1-Flash-1017, 69,1 % |
| 256 GB Mac | Mac Studio M5 Ultra 256 GB | 8 | 4 | Nemotron 3.5 Lightning 30B-A3B, 306,9 tok/s | DeepSeek-V4.1-Flash-1017, 69,7 % |
| 512 GB | 4× DGX Spark (GB10) | 5 | 4 | DeepSeek-V4.1-Flash-1017, 81,8 tok/s | DeepSeek-V4.1-Flash-1017, 66,7 % |
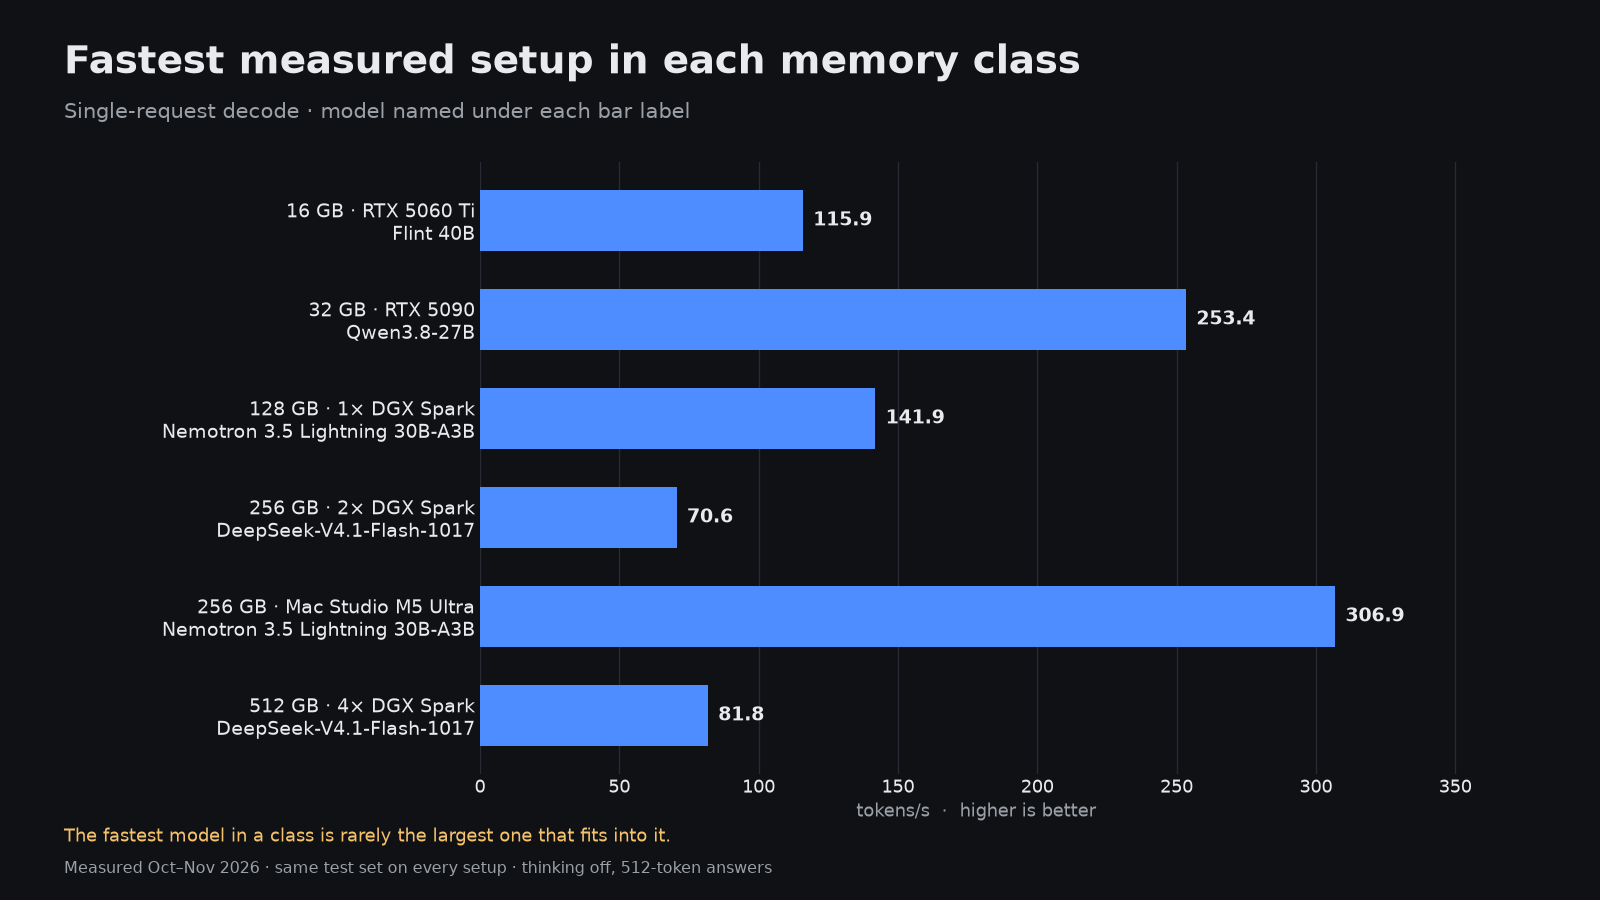
Le meilleur résultat par catégorie est de 115,9 tok/s pour 16 GB, 253,4 pour 32 GB, 141,9 pour un nœud Spark, 70,6 pour deux nœuds Spark, 306,9 pour le Mac et 81,8 pour quatre nœuds Spark. Les grandes catégories semblent lentes en haut du classement car leurs tests concernent principalement des modèles beaucoup plus volumineux, et les modèles plus gros se décodent plus lentement.
La qualité suit à peine la quantité de mémoire
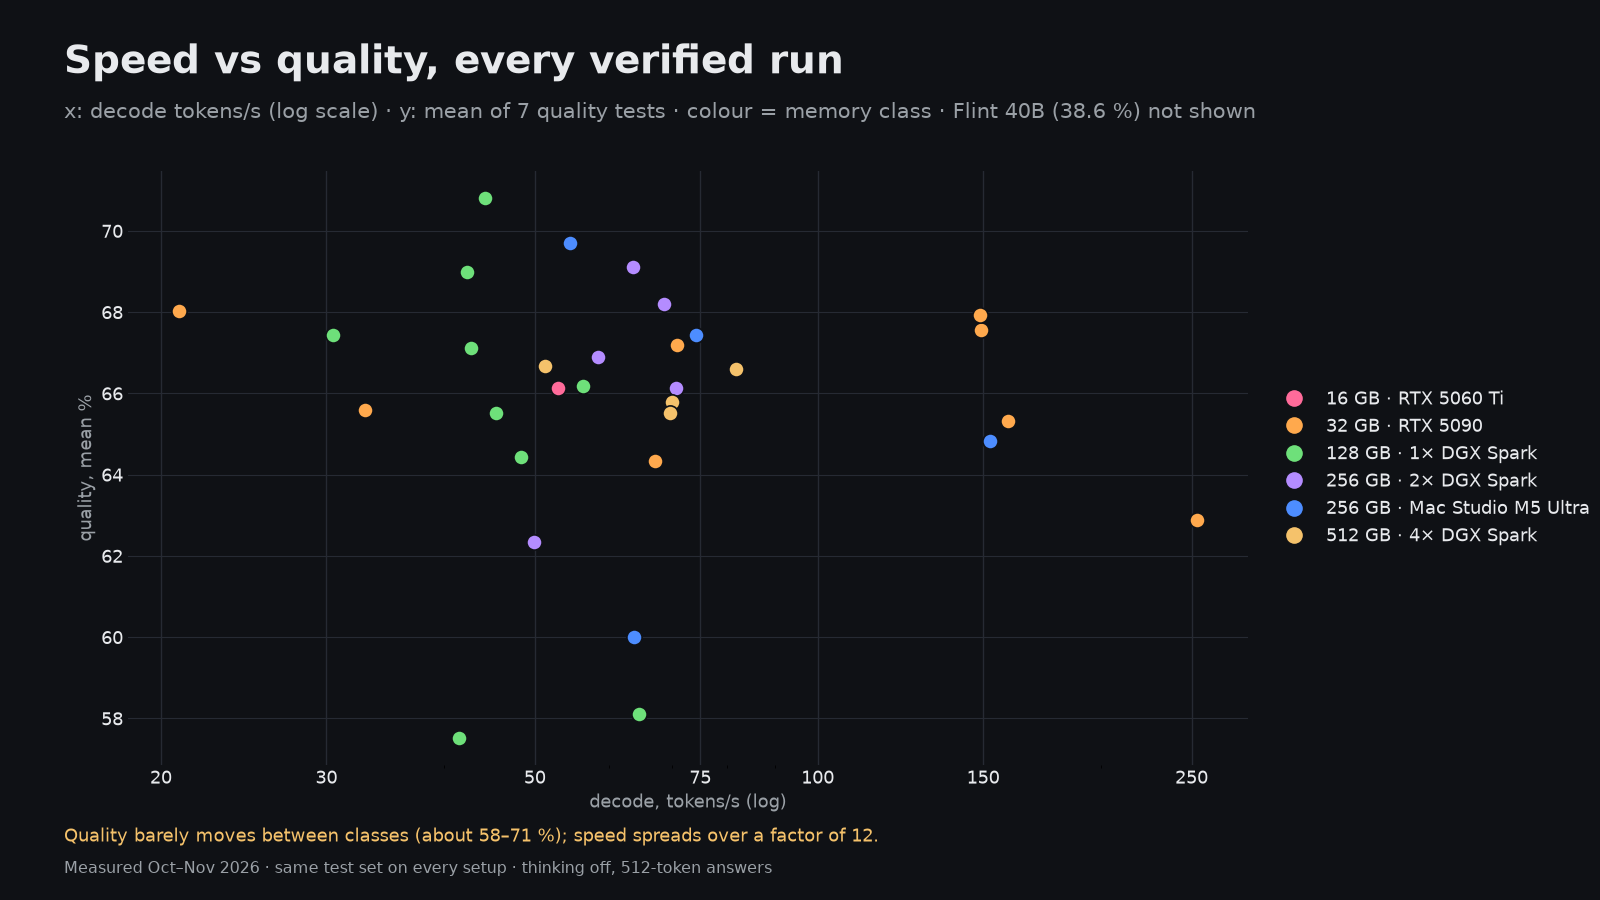
Chaque test complet présente une fourchette de qualité étroite : les 31 tests se situent tous approximativement entre 57 % et 71 %, que ce soit sur une carte de 16 GB ou un cluster de 512 GB. Qwen3.8-27B sur une carte 5060 Ti atteint 66,1 % ; DeepSeek-V4.1-Flash sur quatre cartes Sparks atteint 66,6 %. Ce que l’augmentation de la mémoire vous apporte, c’est principalement une plus grande longueur de contexte, la possibilité d’exploiter plusieurs utilisateurs en parallèle et l’option d’exécuter des modèles MoE très volumineux.
Un grand modèle à quatre budgets différents
| Configuration | Quant | Décodage, tok/s | Préremplissage 8K, tok/s | Qualité moyenne | Mémoire maximale |
|---|---|---|---|---|---|
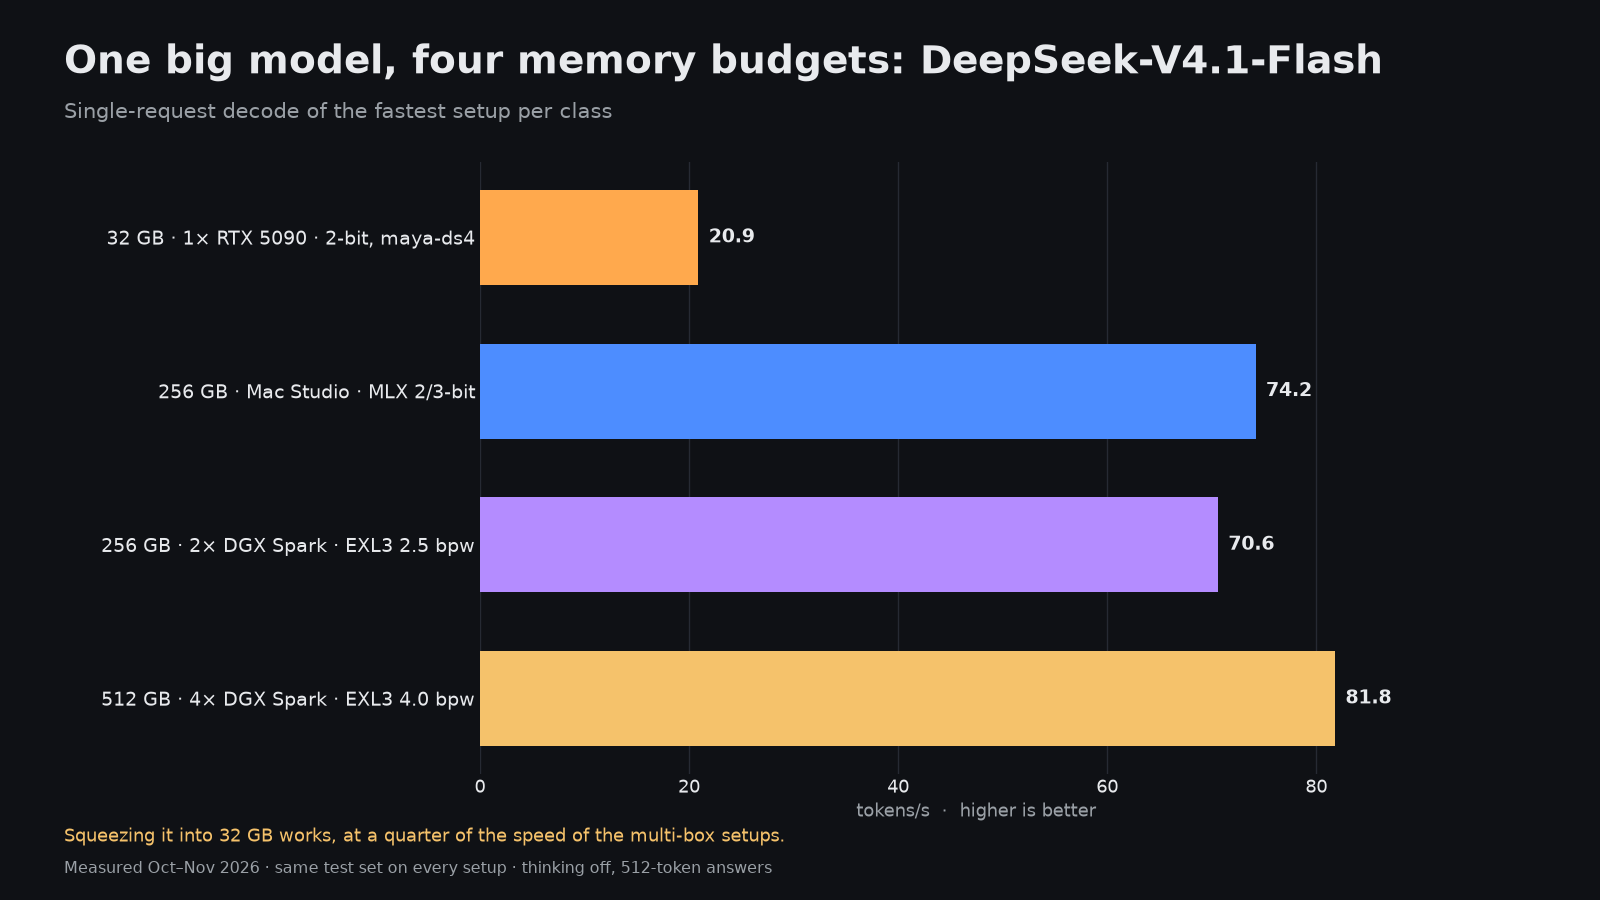
| RTX 5090 + transfert de charge via RAM/NVMe | Maya-S IQ2_XXS | 20,9 | 828 | 68,0 % | 30,9 GiB |
| Mac Studio M5 Ultra | MLX 2/3-bit (e2e3-p4-h8) | 74,2 | 1 763 | 67,4 % | 206,3 GiB |
| 2× DGX Spark | EXL3 2,5 bpw | 70,6 | 2 157 | 66,1 % | 98,7 GiB |
| 4× DGX Spark | EXL3 4,0 bpw | 81,8 | 2 016 | 66,6 % | 103,2 GiB |
DeepSeek-V4.1-Flash est un modèle de 340 GB, et il a été testé avec quatre configurations très différentes. Sur une seule carte RTX 5090 disposant de 96 GB de RAM ainsi que d’un disque NVMe contenant la plupart des experts, sa vitesse de décodage est de 20,9 tok/s. Le Mac atteint 74,2, deux cartes Spark 70,6 et quatre cartes Spark 81,8. Tous les quatre obtiennent des scores compris entre 66,1 et 68,0 %. Le transfert des données vers un autre dispositif permet de faire fonctionner un modèle qui ne pouvait pas l’être, mais à seulement un quart de la vitesse.
Le contexte consomme également de la mémoire
Les poids du modèle ne représentent qu’une partie du budget mémoire. Qwen3.8-27B EXL3 4.0 bpw sur la RTX 5090 atteint un maximum de 18,9 GiB avec un contexte de 128K. Le même modèle distribué sur deux cartes 5060 Ti permet d’obtenir un contexte de 256K pour 22,4 GiB. Qwen3.8-Flash-Next sur deux cartes Sparks charge un contexte de 1M de tokens pour 87,9 GiB. Sur une carte de 16 GB, l’écart entre 43 008 et 117 760 tokens de contexte pour le même modèle dépend de la quantification et du traitement du cache par le moteur.
Classement de votre matériel
16 à 24 GB
RTX 5080, RTX 5070 Ti, RTX 5060 Ti 16 GB, RTX 4090, RTX 4080 Super, RTX 4080, RTX 4070 Ti Super, RTX 4060 Ti 16 GB, RTX 3090 Ti, RTX 3090, RTX PRO 4000 Blackwell, RTX 4500 Ada, RTX 4000 Ada, Radeon RX 9070 XT, Radeon RX 9070, Radeon RX 9060 XT 16 GB, Radeon RX 9060 XT LP, Radeon RX 7900 XTX, Radeon RX 7900 XT, Radeon RX 7900 GRE, Radeon RX 7800 XT, Radeon RX 7600 XT, Radeon RX 6950 XT, Radeon RX 6900 XT, Radeon RX 6800 XT, Radeon RX 6800. Celles-ci utilisent les mêmes quantifications de niveau 27B ainsi que les mêmes configurations MoE avec déchargement que le modèle de référence RTX 5060 Ti 16 GB. Les cartes disposant de 24 GB, comme la RTX 4090, la 3090 et la RX 7900 XTX, permettent un contexte plus long ou des quantifications à plus haut bit, mais pas un niveau de modèle différent.
32 à 96 GB
RTX 5090, RTX PRO 6000 Blackwell, RTX PRO 5000 Blackwell 72 GB, RTX PRO 5000 Blackwell 48 GB, RTX PRO 4500 Blackwell, RTX 6000 Ada, RTX 5000 Ada, RTX A6000, Radeon AI PRO R9700, Radeon AI PRO R9600D, Radeon PRO W7900, Radeon PRO W7800 32 GB, Radeon PRO W7800 48 GB. La version 32 GB correspond à la RTX 5090 : modèles de 27 milliards de paramètres utilisant 4 à 6 bits avec un contexte allant de 128K à 256K, ainsi que de grands modèles MoE bénéficiant d’un transfert de la mémoire vers la RAM.
128 GB de mémoire unifiée
Framework Desktop, GMKtec EVO-X2, HP Z2 Mini G1a, ASUS ROG Flow Z13, Mac Studio M5 Max, MacBook Pro M5 Max, NVIDIA DGX Spark, ASUS Ascent GX10, MSI EdgeXpert, Gigabyte AI TOP ATOM, Lenovo ThinkStation PGX, Acer Veriton GN100, HP ZGX Nano G1n, ainsi que chaque boîte GB10 : NVIDIA DGX Spark, ASUS Ascent GX10, Dell Pro Max avec GB10, MSI EdgeXpert, Gigabyte AI TOP ATOM, Lenovo ThinkStation PGX, Acer Veriton GN100 et HP ZGX Nano G1n. Tout ce qui fait partie de ce groupe peut charger les modèles de la classe 120B testés sur un Spark ; les Macs et les ordinateurs AMD Strix Halo les exécuteront à leur propre vitesse.
256 GB et plus
Un Mac Studio M5 Ultra avec 256 ou 512 GB, ou deux à quatre boîtes GB10 connectées via ConnectX-7. C’est la catégorie adaptée aux modèles 340 GB DeepSeek-V4.1-Flash et aux modèles de cette taille sans transfert externe.
Choix de la classe
- Chat, aide au codage et transcription pour une seule personne : 16 GB suffisent, 32 GB sont plus confortables et beaucoup plus rapides.
- Agents de codage gérant de longs contextes et plusieurs utilisateurs sur une seule machine : 32 GB sur une RTX 5090 équipée d’un moteur de batchage.
- Modèles de plus de 100 milliards de paramètres sans déchargement : 128 GB de mémoire unifiée ; privilégiez un Mac si la vitesse est importante, ou Spark si votre stack utilise CUDA.
- Les plus grands modèles MoE ouverts fonctionnant à une vitesse utilisable : un Mac Studio de 256 GB, ou deux à quatre boîtiers GB10.
- Avant d’acheter plus de mémoire, vérifiez si un meilleur moteur ou une quantification adaptée à votre matériel peut combler l’écart. Sur la même RTX 5090, le simple changement de stack logiciel a multiplié la vitesse par presque 4.