Wie viel Speicher benötigt man für lokale KI? Geschwindigkeiten von 16 GB bis 512 GB.
Gemessene Geschwindigkeit und Qualität lokaler LLMs auf Maschinen mit 16, 32, 128, 256 und 512 GB, was jede Kategorie ausführen kann und welche GPUs, Macs und Mini-PCs für welche Anwendungen geeignet sind.
Die erste Frage bei der Entwicklung einer lokalen KI ist, wie viel Speicher benötigt wird. Die ehrliche Antwort lautet, dass der Speicher bestimmt, welche Modelle geladen werden, während die dahinterliegende Hardware darüber entscheidet, wie schnell sie ausgeführt werden. Unten sind gemessene Ergebnisse für sechs Speicherklassen aufgeführt – von einer 16 GB großen Gaming-Karte bis zu einem vierfachigen GB10-Cluster mit 512 GB – wobei überall derselbe Testrahmen verwendet wurde.
Jede Klasse wurde an einem Referenzgerät gemessen. Andere Hardware mit derselben Speichermenge wird dieselben Modelle laden, doch die Geschwindigkeit wird unterschiedlich sein. Daher beziehen sich die untenstehenden Listen der kompatiblen Hardware auf die Passgenauigkeit und nicht auf die Geschwindigkeit.
Sechs Klassen, sechs Referenzgeräte
| Speicherklasse | Getestet auf | Einstellungen | Vollständige Bewertung | Schnellste Dekodierung | Beste Qualität |
|---|---|---|---|---|---|
| 16 GB | RTX 5060 Ti 16 GB | 5 | 1 | Flint 40B, 115,9 tok/s | Qwen3.8-27B, 66,1 % |
| 32 GB | RTX 5090 32 GB | 12 | 9 | Qwen3.8-27B, 253,4 tok/s | DeepSeek-V4.1-Flash-1017, 68,0 % |
| 128 GB | 1× DGX Spark (GB10) | 15 | 9 | Nemotron 3.5 Lightning 30B-A3B, 141,9 tok/s | Ornith-1.5-122B, 70,8 % |
| 256 GB | 2× DGX Spark (GB10) | 9 | 5 | DeepSeek-V4.1-Flash-1017, 70,6 tok/s | DeepSeek-V4.1-Flash-1017, 69,1 % |
| 256 GB Mac | Mac Studio M5 Ultra 256 GB | 8 | 4 | Nemotron 3.5 Lightning 30B-A3B, 306,9 tok/s | DeepSeek-V4.1-Flash-1017, 69,7 % |
| 512 GB | 4× DGX Spark (GB10) | 5 | 4 | DeepSeek-V4.1-Flash-1017, 81,8 tok/s | DeepSeek-V4.1-Flash-1017, 66,7 % |
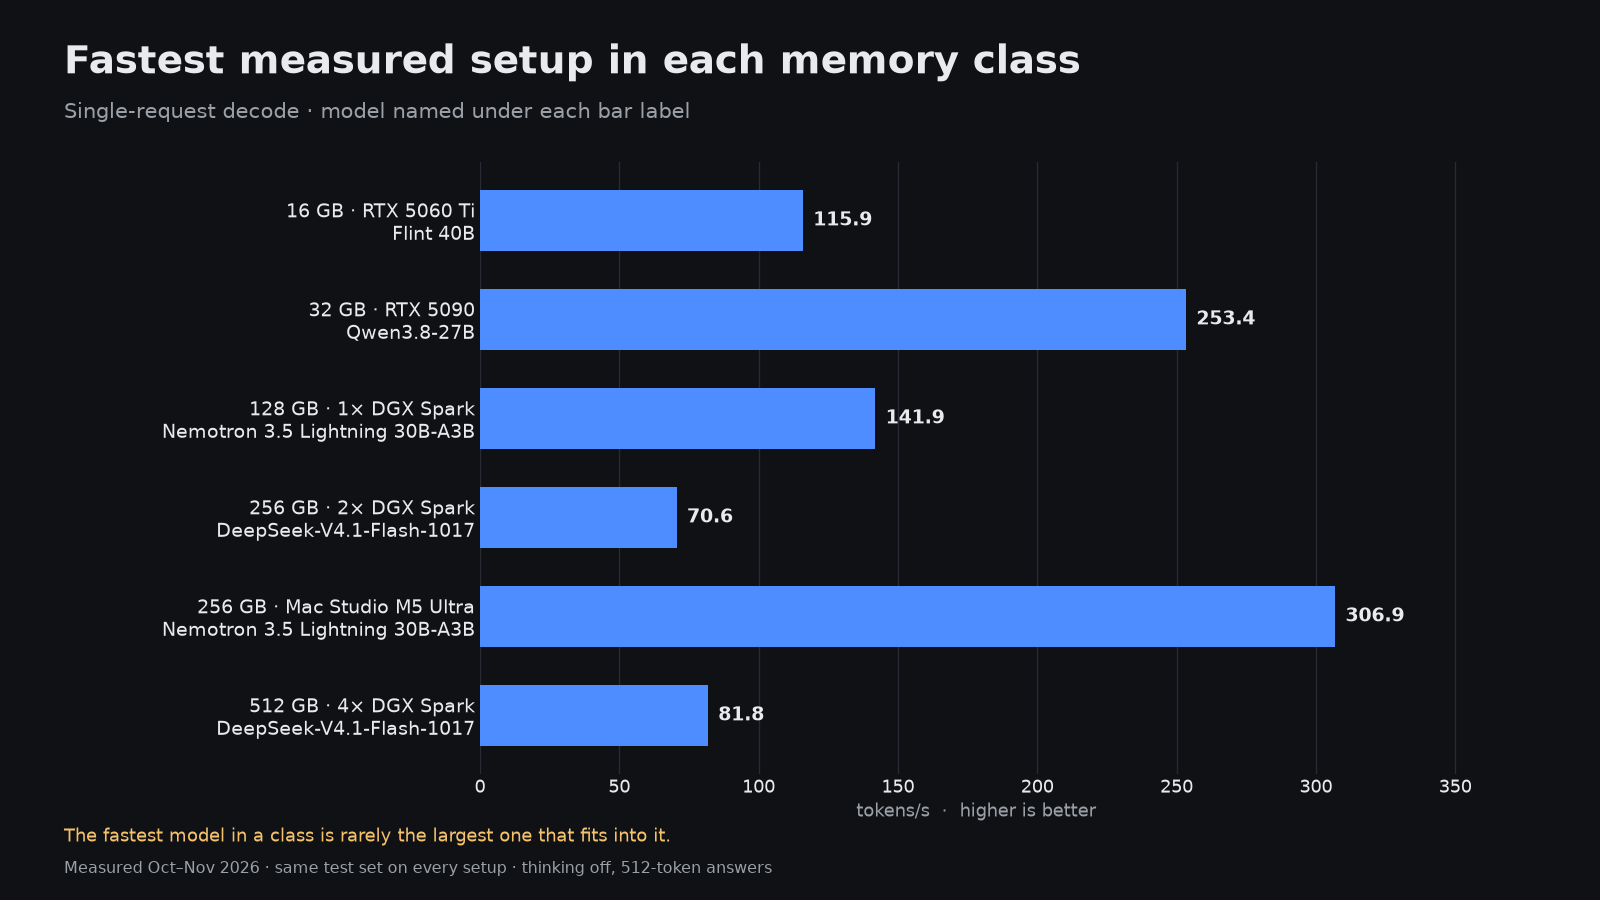
Das schnellste Ergebnis pro Klasse beträgt 115,9 Tok/s bei 16 GB, 253,4 bei 32 GB, 141,9 bei einem Spark-Cluster, 70,6 bei zwei Spark-Clustern, 306,9 am Mac und 81,8 bei vier Spark-Clustern. Die größeren Klassen erscheinen an der Spitze langsam, weil die dort verwendeten Modelle in der Regel viel größer sind, und größere Modelle dekodieren langsamer.
Die Qualität folgt kaum dem Speicherbedarf
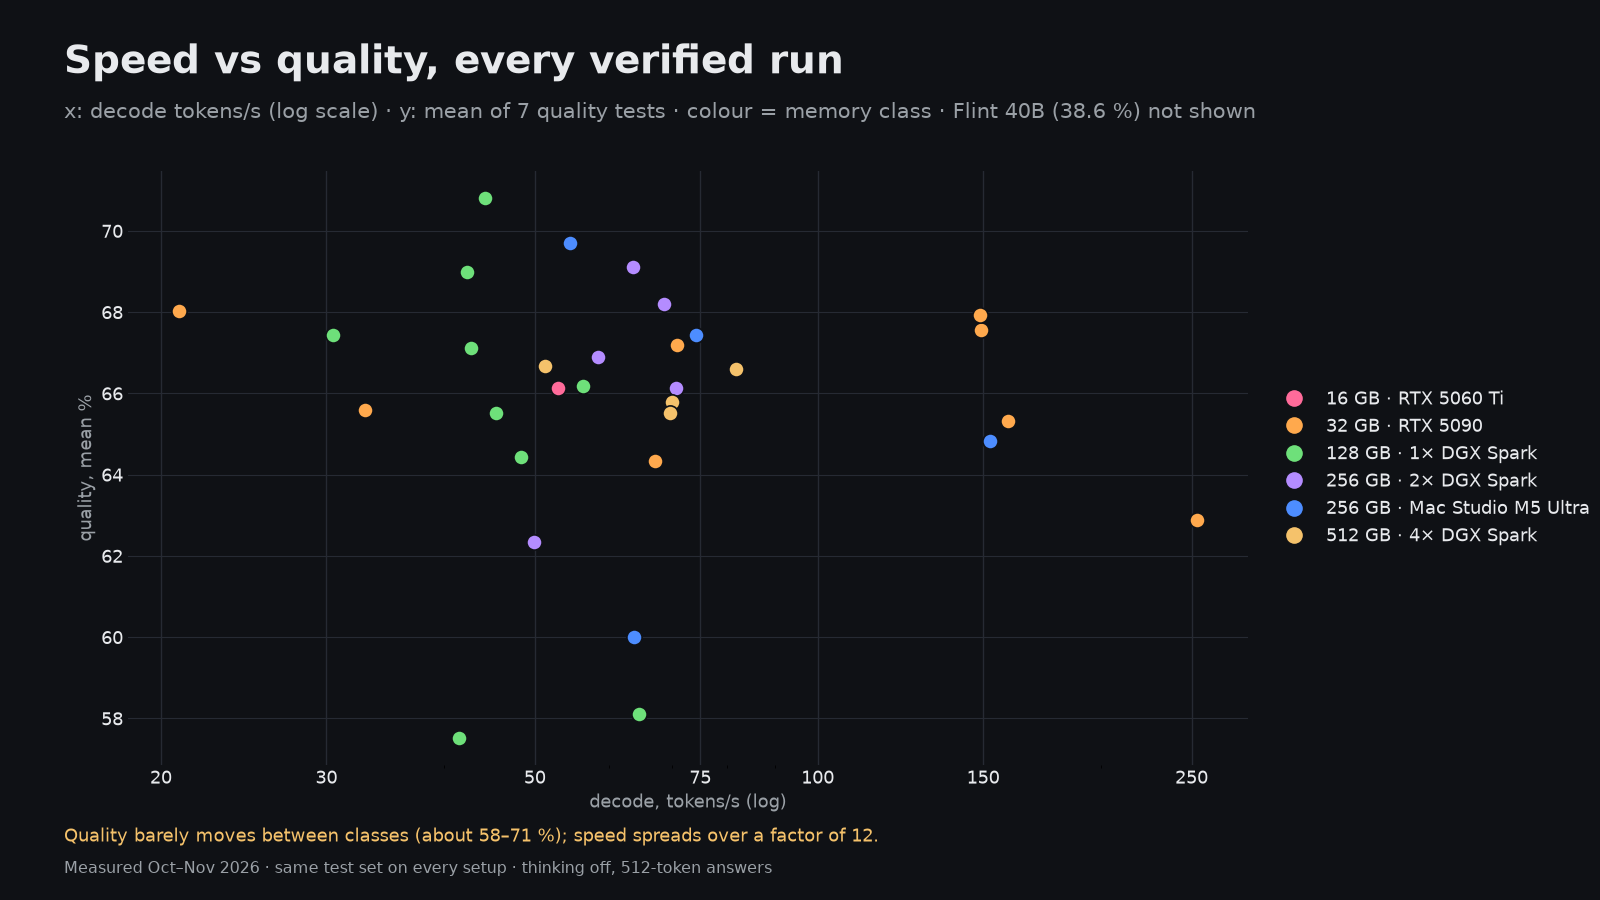
Bei jeder voll bewerteten Ausführung ist der Qualitätsbereich eng: Alle 31 Fälle liegen ungefähr zwischen 57 und 71 %, unabhängig davon, ob sie auf einer 16 GB großen Karte oder einem 512 GB großen Cluster ausgeführt werden. Qwen3.8-27B auf einer 5060 Ti erreicht 66,1 %; DeepSeek-V4.1-Flash auf vier Sparks erreicht 66,6 %. Mehr Speicher bringt hauptsächlich längere Kontextlängen, mehr parallele Benutzer sowie die Möglichkeit mit, sehr große MoE-Modelle überhaupt auszuführen.
Ein großes Modell zu vier verschiedenen Budgets
| Ausstattung | Quantisierung | Decodiergeschwindigkeit, Tok/s | Vorladen 8K, Tok/s | Durchschnittliche Qualität | Höchster Speicherverbrauch |
|---|---|---|---|---|---|
| RTX 5090 + RAM/NVMe Offload | Maya-S IQ2_XXS | 20,9 | 828 | 68,0 % | 30,9 GiB |
| Mac Studio M5 Ultra | MLX 2/3-Bit (e2e3-p4-h8) | 74,2 | 1.763 | 67,4 % | 206,3 GiB |
| 2× DGX Spark | EXL3 2,5 bpw | 70,6 | 2.157 | 66,1 % | 98,7 GiB |
| 4× DGX Spark | EXL3 4,0 bpw | 81,8 | 2.016 | 66,6 % | 103,2 GiB |
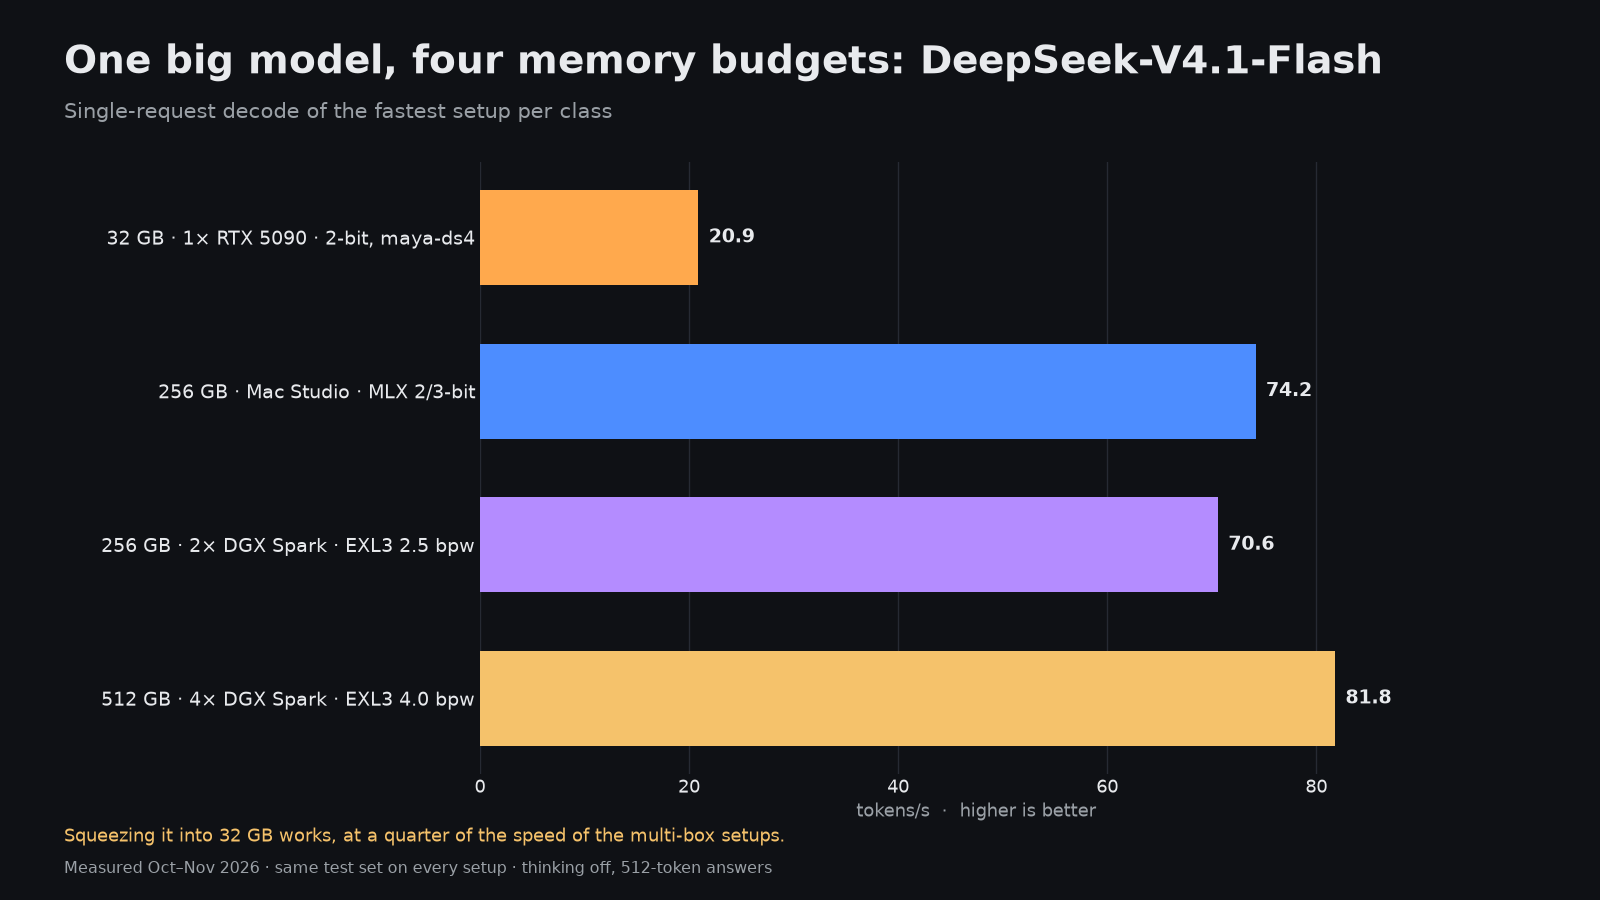
DeepSeek-V4.1-Flash ist ein 340 GB großes Modell, das unter vier völlig unterschiedlichen Bedingungen getestet wurde. Auf einer einzigen RTX 5090 mit 96 GB RAM sowie einer NVMe-Festplatte, die den größten Teil der Expertendaten enthält, erreicht es eine Dekodiergeschwindigkeit von 20,9 tok/s. Der Mac erreicht 74,2 tok/s, zwei DGX Spark-Systeme 70,6 tok/s und vier DGX Spark-Systeme 81,8 tok/s. Alle vier Systeme erzielen Werte zwischen 66,1 und 68,0 %. Durch das Auslagern von Daten kann ein Modell, das nicht direkt ausgeführt werden kann, zu einem umsetzbaren Modell gemacht werden – allerdings nur mit einer Viertelgeschwindigkeit.
Auch der Kontext verbraucht Speicher
Die Modellgewichte sind nur ein Teil des Speicherbedarfs. Qwen3.8-27B EXL3 4.0 bpw auf der RTX 5090 erreicht mit einem Kontext von 128K einen Höchstwert von 18,9 GiB. Derselbe Modelltyp auf zwei 5060 Ti-Karten erreicht mit einem Kontext von 256K 22,4 GiB. Qwen3.8-Flash-Next auf zwei Sparks-Karten lädt einen Kontext mit 1 Mio. Token bei 87,9 GiB. Auf einer Karte mit 16 GB verringert sich der Unterschied zwischen 43.008 und 117.760 Token im Kontext desselben Modells auf die Quantisierung sowie die Cache-Verwaltung des Engines.
Wo Ihre Hardware angesiedelt ist
16 bis 24 GB
RTX 5080, RTX 5070 Ti, RTX 5060 Ti 16 GB, RTX 4090, RTX 4080 Super, RTX 4080, RTX 4070 Ti Super, RTX 4060 Ti 16 GB, RTX 3090 Ti, RTX 3090, RTX PRO 4000 Blackwell, RTX 4500 Ada, RTX 4000 Ada, Radeon RX 9070 XT, Radeon RX 9070, Radeon RX 9060 XT 16 GB, Radeon RX 9060 XT LP, Radeon RX 7900 XTX, Radeon RX 7900 XT, Radeon RX 7900 GRE, Radeon RX 7800 XT, Radeon RX 7600 XT, Radeon RX 6950 XT, Radeon RX 6900 XT, Radeon RX 6800 XT, Radeon RX 6800. Diese verwenden dieselben 27B-Klassen-Quantisierungen sowie MoE-with-Offload-Einstellungen wie die Referenzversion der RTX 5060 Ti 16 GB. Karten mit 24 GB, wie die RTX 4090, 3090 und RX 7900 XTX, bieten Platz für längere Kontexte oder eine höherbitige Quantisierung, aber nicht für eine andere Modellklasse.
32 bis 96 GB
RTX 5090, RTX PRO 6000 Blackwell, RTX PRO 5000 Blackwell 72 GB, RTX PRO 5000 Blackwell 48 GB, RTX PRO 4500 Blackwell, RTX 6000 Ada, RTX 5000 Ada, RTX A6000, Radeon AI PRO R9700, Radeon AI PRO R9600D, Radeon PRO W7900, Radeon PRO W7800 32 GB, Radeon PRO W7800 48 GB. Die 32 GB-Klasse umfasst die RTX 5090: Modelle mit 27 Milliarden Parametern bei 4 bis 6 Bit sowie 128K bis 256K Kontextspeicher, zusätzlich große MoE-Modelle mit RAM-Offloading.
128 GB einheitlicher Speicher
Framework Desktop, GMKtec EVO-X2, HP Z2 Mini G1a, ASUS ROG Flow Z13, Mac Studio M5 Max, MacBook Pro M5 Max, NVIDIA DGX Spark, ASUS Ascent GX10, MSI EdgeXpert, Gigabyte AI TOP ATOM, Lenovo ThinkStation PGX, Acer Veriton GN100, HP ZGX Nano G1n sowie jede GB10-Einheit: NVIDIA DGX Spark, ASUS Ascent GX10, Dell Pro Max mit GB10, MSI EdgeXpert, Gigabyte AI TOP ATOM, Lenovo ThinkStation PGX, Acer Veriton GN100 und HP ZGX Nano G1n. Alle Geräte in dieser Gruppe können Modelle der 120B-Klasse ausführen, die auf einem Spark getestet wurden; Macs sowie AMD Strix Halo-Systeme werden sie in ihrer eigenen Geschwindigkeit laufen lassen.
256 GB und mehr
Ein Mac Studio M5 Ultra mit 256 oder 512 GB oder zwei bis vier GB10-Einheiten, die über ConnectX-7 miteinander verbunden sind. Dies ist die Kategorie für das 340 GB große DeepSeek-V4.1-Flash-Modell sowie ähnlich große Modelle ohne Offload-Funktion.
Wahl der Klasse
- Chatten, Code-Hilfe und Transkription für eine Person: 16 GB reichen aus, 32 GB sind angenehmer und viel schneller.
- Code-Agenten mit langen Kontexten und mehrere Benutzer auf einem Gerät: 32 GB auf einer RTX 5090 mit einem Batching-Engine.
- Modelle mit mehr als 100 Milliarden Parametern ohne Offload: 128 GB an einheitlicher Speicher; wählen Sie einen Mac, wenn Geschwindigkeit wichtig ist, oder Spark, wenn Ihre Infrastruktur auf CUDA basiert.
- Die größten offenen MoE-Modelle bei nutzbarem Tempo: ein 256 GB großer Mac Studio oder zwei bis vier GB10-Geräte.
- Bevor Sie mehr Speicher kaufen, prüfen Sie, ob ein besseres Engine-Design oder eine effektivere Quantisierung auf Ihrer vorhandenen Hardware den Unterschied ausgleichen kann. Allein die Software-Stack-Änderung auf derselben RTX 5090 führte zu einer Geschwindigkeitssteigerung um fast das Vierfache.