Ile pamięci potrzeba do lokalnej sztucznej inteligencji? Prędkości od 16 GB do 512 GB.
Pomiar prędkości i jakości lokalnych modeli LLM na maszynach o pojemności 16, 32, 128, 256 i 512 GB, co każda klasa może uruchomić oraz jakie karty GPU, komputery Mac i minikomputery pasują do poszczególnych zastosowań.
Pierwszym pytaniem przy tworzeniu lokalnego systemu AI jest to, ile pamięci potrzebujesz, a szczera odpowiedź brzmi, że to pamięć decyduje o tym, które modele zostaną załadowane, podczas gdy sprzęt stanowiący ich podstawę określa szybkość ich działania. Poniżej przedstawiono wyniki pomiarów dla sześciu klas pamięci – od karty graficznej o pojemności 16 GB do klastra GB10 składającego się z czterech jednostek o łącznej pojemności 512 GB – przy użyciu tego samego zestawu testowego we wszystkich przypadkach.
Każda klasa została przetestowana na jednym komputerze referencyjnym. Inny sprzęt o tej samej ilości pamięci będzie ładował te same modele, ale jego szybkość będzie się różnić, dlatego listy sprzętu pasującego znajdujące się poniżej dotyczą dopasowania, a nie szybkości działania.
Sześć klas, sześć komputerów referencyjnych
| Klasa pamięci | Przetestowano na | Ustawienia | Pełna ocena | Najszybsze dekodowanie | Najlepsza jakość |
|---|---|---|---|---|---|
| 16 GB | RTX 5060 Ti 16 GB | 5 | 1 | Flint 40B, 115,9 tok/s | Qwen3.8-27B, 66,1 % |
| 32 GB | RTX 5090 32 GB | 12 | 9 | Qwen3.8-27B, 253,4 tok/s | DeepSeek-V4.1-Flash-1017, 68,0 % |
| 128 GB | 1× DGX Spark (GB10) | 15 | 9 | Nemotron 3.5 Lightning 30B-A3B, 141,9 tok/s | Ornith-1.5-122B, 70,8 % |
| 256 GB | 2× DGX Spark (GB10) | 9 | 5 | DeepSeek-V4.1-Flash-1017, 70,6 tok/s | DeepSeek-V4.1-Flash-1017, 69,1 % |
| 256 GB Mac | Mac Studio M5 Ultra 256 GB | 8 | 4 | Nemotron 3.5 Lightning 30B-A3B, 306,9 tok/s | DeepSeek-V4.1-Flash-1017, 69,7 % |
| 512 GB | 4× DGX Spark (GB10) | 5 | 4 | DeepSeek-V4.1-Flash-1017, 81,8 tok/s | DeepSeek-V4.1-Flash-1017, 66,7 % |
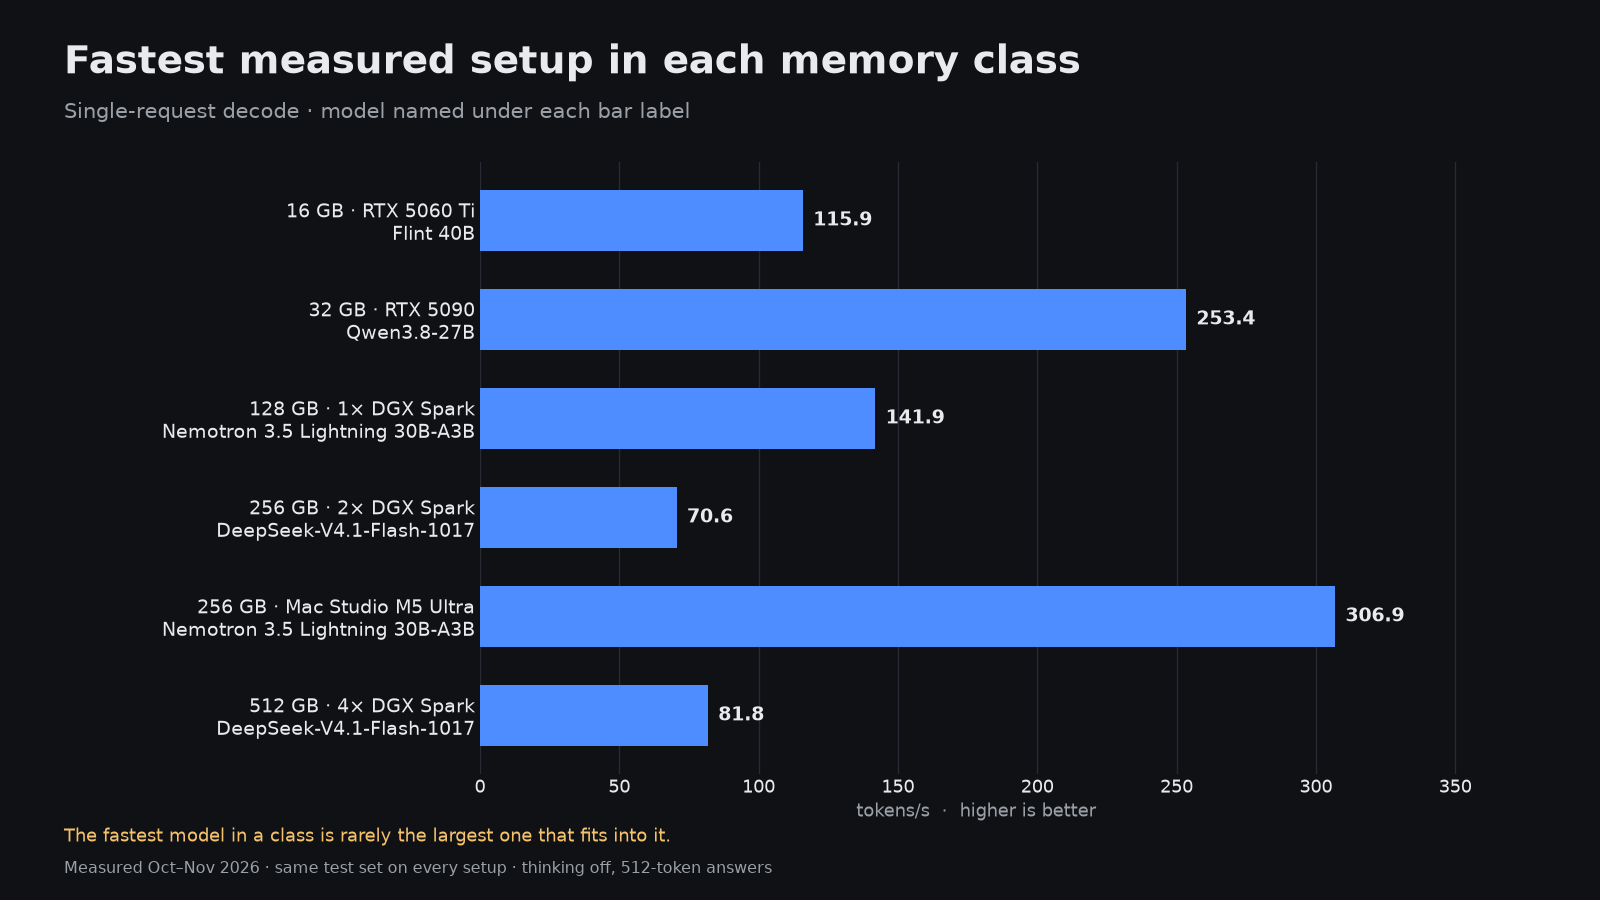
Najszybszy wynik w każdej klasie wynosi 115,9 tok/s przy 16 GB, 253,4 przy 32 GB, 141,9 przy jednym węźle Spark, 70,6 przy dwóch węzłach Spark, 306,9 na Macu oraz 81,8 przy czterech węzłach Spark. Klasy o większej pojemności wydają się wolne, ponieważ są to głównie znacznie większe modele, a większe modele dekodują się wolniej.
Jakość ledwo idzie w parze z ilością pamięci
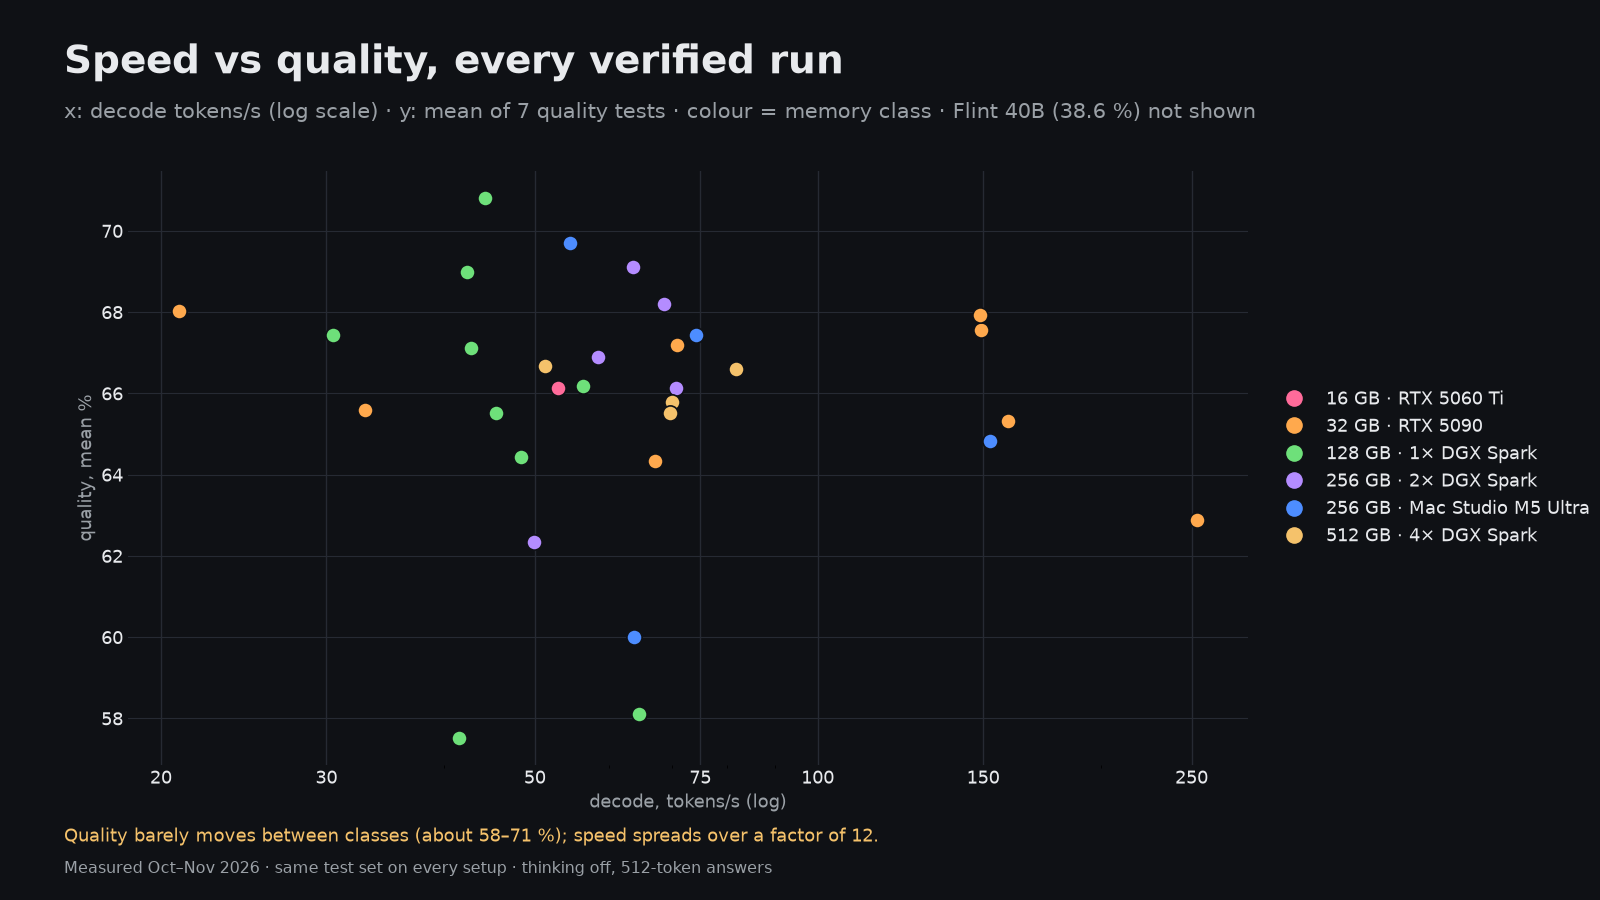
Dla wszystkich przetestowanych przypadków zakres jakości jest wąski: wszystkie 31 przypadków mieści się mniej więcej w przedziale 57–71%, niezależnie od tego, czy działają na karcie pamięci o pojemności 16 GB, czy na klastrze o pojemności 512 GB. Qwen3.8-27B na karcie 5060 Ti osiąga wynik 66,1%, natomiast DeepSeek-V4.1-Flash na czterech kartach Sparks osiąga wynik 66,6%. Większa pojemność pamięci przynosi głównie dłuższy kontekst, możliwość obsługi większej liczby użytkowników równolegle oraz możliwość uruchamiania bardzo dużych modeli typu MoE.
Jeden duży model w czterech budżetach
| Ustawienie | Quant | Dekodowanie, tok/s | Wypełnianie początkowe 8K, tok/s | Średnia jakość | Maksymalna ilość pamięci |
|---|---|---|---|---|---|
| RTX 5090 + RAM/NVMe offload | Maya-S IQ2_XXS | 20.9 | 828 | 68.0 % | 30.9 GiB |
| Mac Studio M5 Ultra | MLX 2/3-bit (e2e3-p4-h8) | 74.2 | 1,763 | 67.4 % | 206.3 GiB |
| 2× DGX Spark | EXL3 2.5 bpw | 70,6 | 2 157 | 66,1 % | 98,7 GiB |
| 4× DGX Spark | EXL3 4,0 bpw | 81,8 | 2 016 | 66,6 % | 103,2 GiB |
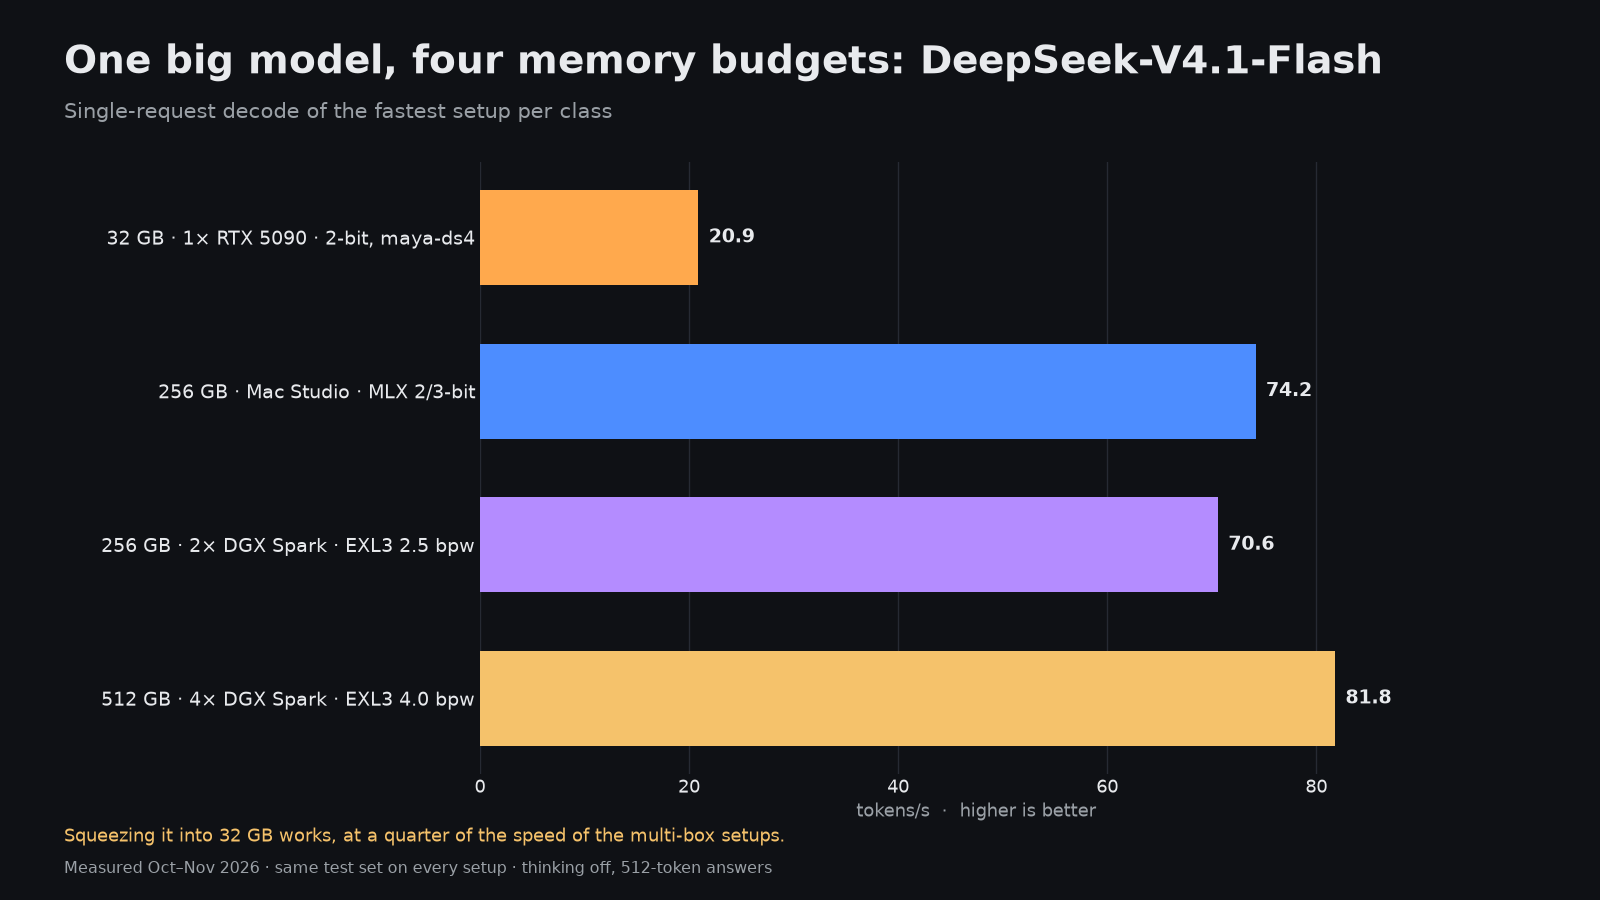
DeepSeek-V4.1-Flash to model o pojemności 340 GB, który został przetestowany przy czterech zupełnie różnych warunkach finansowych. Na pojedynczym układzie RTX 5090 z 96 GB pamięci RAM oraz dysku NVMe zawierającym większość modeli ekspertów dekoduje on dane z szybkością 20,9 tok/s. Mac osiąga szybkość 74,2 tok/s, dwa układy Spark – 70,6 tok/s, a cztery układy Spark – 81,8 tok/s. Wszystkie cztery rozwiązania osiągają wyniki w przedziale od 66,1 do 68,0 %. Przeniesienie obliczeń na inne urządzenia pozwala uruchomić model, który wcześniej nie był możliwy do uruchomienia, przy prędkości stanowiącej jedną czwartą oryginalnej.
Kontekst również zużywa pamięć
Masy modelu to tylko część budżetu. Qwen3.8-27B EXL3 4.0 bpw na karcie RTX 5090 osiąga maksymalnie 18,9 GiB przy kontekście 128K. Ten sam model rozdzielony na dwie karty 5060 Ti pozwala na kontekst 256K przy 22,4 GiB. Qwen3.8-Flash-Next na dwóch kartach Sparks ładowa kontekst 1M tokenów przy 87,9 GiB. Na karcie o pojemności 16 GB różnica pomiędzy kontekstem 43 008 a 117 760 tokenów dla tego samego modelu zależy od metody kwantyzacji oraz sposobu zarządzania pamięcią cache silnika.
Gdzie znajduje się twój sprzęt
16 do 24 GB
RTX 5080, RTX 5070 Ti, RTX 5060 Ti 16 GB, RTX 4090, RTX 4080 Super, RTX 4080, RTX 4070 Ti Super, RTX 4060 Ti 16 GB, RTX 3090 Ti, RTX 3090, RTX PRO 4000 Blackwell, RTX 4500 Ada, RTX 4000 Ada, Radeon RX 9070 XT, Radeon RX 9070, Radeon RX 9060 XT 16 GB, Radeon RX 9060 XT LP, Radeon RX 7900 XTX, Radeon RX 7900 XT, Radeon RX 7900 GRE, Radeon RX 7800 XT, Radeon RX 7600 XT, Radeon RX 6950 XT, Radeon RX 6900 XT, Radeon RX 6800 XT, Radeon RX 6800. Urządzenia te wykorzystują te same kwantyfikacje klasy 27B oraz konfiguracje MoE z przenoszeniem danych co model RTX 5060 Ti 16 GB. Karty o pojemności 24 GB, takie jak RTX 4090, 3090 i RX 7900 XTX, pozwalają na obsługę dłuższego kontekstu lub kwantyfikacji o wyższej liczbie bitów, ale nie umożliwiają przejścia na inny poziom modelu.
32 do 96 GB
RTX 5090, RTX PRO 6000 Blackwell, RTX PRO 5000 Blackwell 72 GB, RTX PRO 5000 Blackwell 48 GB, RTX PRO 4500 Blackwell, RTX 6000 Ada, RTX 5000 Ada, RTX A6000, Radeon AI PRO R9700, Radeon AI PRO R9600D, Radeon PRO W7900, Radeon PRO W7800 32 GB, Radeon PRO W7800 48 GB. Poziom RTX 5090 to 32 GB: modele 27B z przechowywaniem danych w 4 do 6 bitach przy kontekście od 128K do 256K, plus duże modele typu MoE z przenoszeniem danych do pamięci RAM.
128 GB pamięci zintegrowanej
Framework Desktop, GMKtec EVO-X2, HP Z2 Mini G1a, ASUS ROG Flow Z13, Mac Studio M5 Max, MacBook Pro M5 Max, NVIDIA DGX Spark, ASUS Ascent GX10, MSI EdgeXpert, Gigabyte AI TOP ATOM, Lenovo ThinkStation PGX, Acer Veriton GN100, HP ZGX Nano G1n, a także każda skrzynka GB10: NVIDIA DGX Spark, ASUS Ascent GX10, Dell Pro Max z GB10, MSI EdgeXpert, Gigabyte AI TOP ATOM, Lenovo ThinkStation PGX, Acer Veriton GN100 oraz HP ZGX Nano G1n. Wszystko z tej grupy może uruchamiać modele klasy 120B przetestowane na jednym Sparku; komputery Mac oraz urządzenia AMD Strix Halo będą je wykonywać we własnym tempie.
256 GB i więcej
Mac Studio M5 Ultra z 256 lub 512 GB, albo dwie i cztery skrzynki GB10 połączone za pomocą ConnectX-7. To poziom odpowiedni dla modelu 340 GB DeepSeek-V4.1-Flash oraz modeli o podobnej wielkości bez możliwości przenoszenia obciążeń na inne urządzenia.
Wybór klasy
- Chat, pomoc w programowaniu i transkrypcja dla jednej osoby: 16 GB wystarcza, 32 GB zapewnia wygodę i znacznie większą szybkość.
- Agenty do programowania pracujące z długimi kontekstami oraz kilku użytkowników na jednym urządzeniu: 32 GB na kartce RTX 5090 z silnikiem batchowania.
- Modele powyżej 100 miliardów parametrów bez możliwości przeniesienia obliczeń na inne urządzenia: 128 GB pamięci zintegrowanej; jeśli liczy się szybkość, wybierz Maca, a jeśli używasz stacku CUDA – Sparka.
- Największe otwarte modele typu MoE działające z przyjętą szybkością: Mac Studio o pojemności 256 GB lub dwa do czterech urządzeń GB10.
- Zanim kupisz więcej pamięci, sprawdź, czy lepszy silnik lub metoda kwantyzacji na obecnym sprzęcie może zniwelować tę różnicę. Już na tej samej karcie 5090 sam stack oprogramowania zmienił szybkość o prawie 4 razy.