运行本地AI需要多少内存?从16GB到512GB不同配置下的速度表现。
测量了16GB、32GB、128GB、256GB和512GB配置的机器上的本地大语言模型运行速度与质量,以及各类配置能运行哪些模型,还有哪些GPU、Mac和迷你电脑适合对应配置。
在构建任何本地人工智能系统时,第一个需要考虑的问题就是需要多少内存。坦白的答案是,内存决定了哪些模型可以被加载,而背后的硬件则决定了这些模型的运行速度。以下是使用相同测试工具,在从16 GB游戏显卡到拥有512 GB内存的四个GB10节点组成的集群这六种不同内存配置下所获得的测试结果。
每种内存配置都在一台参考机上进行了测试。其他具有相同内存容量的硬件虽然也能加载相同的模型,但其运行速度会有所不同,因此后面列出的适用硬件清单只是说明哪些硬件可以满足需求,并不代表它们的运行速度如何。
六种配置,六台参考机
| 内存配置 | 测试设备 | 配置方案 | 满分得分 | 最快解码速度 | 最佳质量 |
|---|---|---|---|---|---|
| 16 GB | RTX 5060 Ti 16 GB | 5 | 1 | Flint 40B,115.9 tok/s | Qwen3.8-27B,66.1 % |
| 32 GB | RTX 5090 32 GB | 12 | 9 | Qwen3.8-27B,253.4 tok/s | DeepSeek-V4.1-Flash-1017,68.0 % |
| 128 GB | 1× DGX Spark (GB10) | 15 | 9 | Nemotron 3.5 Lightning 30B-A3B,141.9 tok/s | Ornith-1.5-122B,70.8 % |
| 256 GB | 2× DGX Spark (GB10) | 9 | 5 | DeepSeek-V4.1-Flash-1017,70.6 tok/s | DeepSeek-V4.1-Flash-1017,69.1 % |
| 256 GB Mac | Mac Studio M5 Ultra 256 GB | 8 | 4 | Nemotron 3.5 Lightning 30B-A3B,306.9 tok/s | DeepSeek-V4.1-Flash-1017,69.7 % |
| 512 GB | 4× DGX Spark (GB10) | 5 | 4 | DeepSeek-V4.1-Flash-1017,81.8 tok/s | DeepSeek-V4.1-Flash-1017,66.7 % |
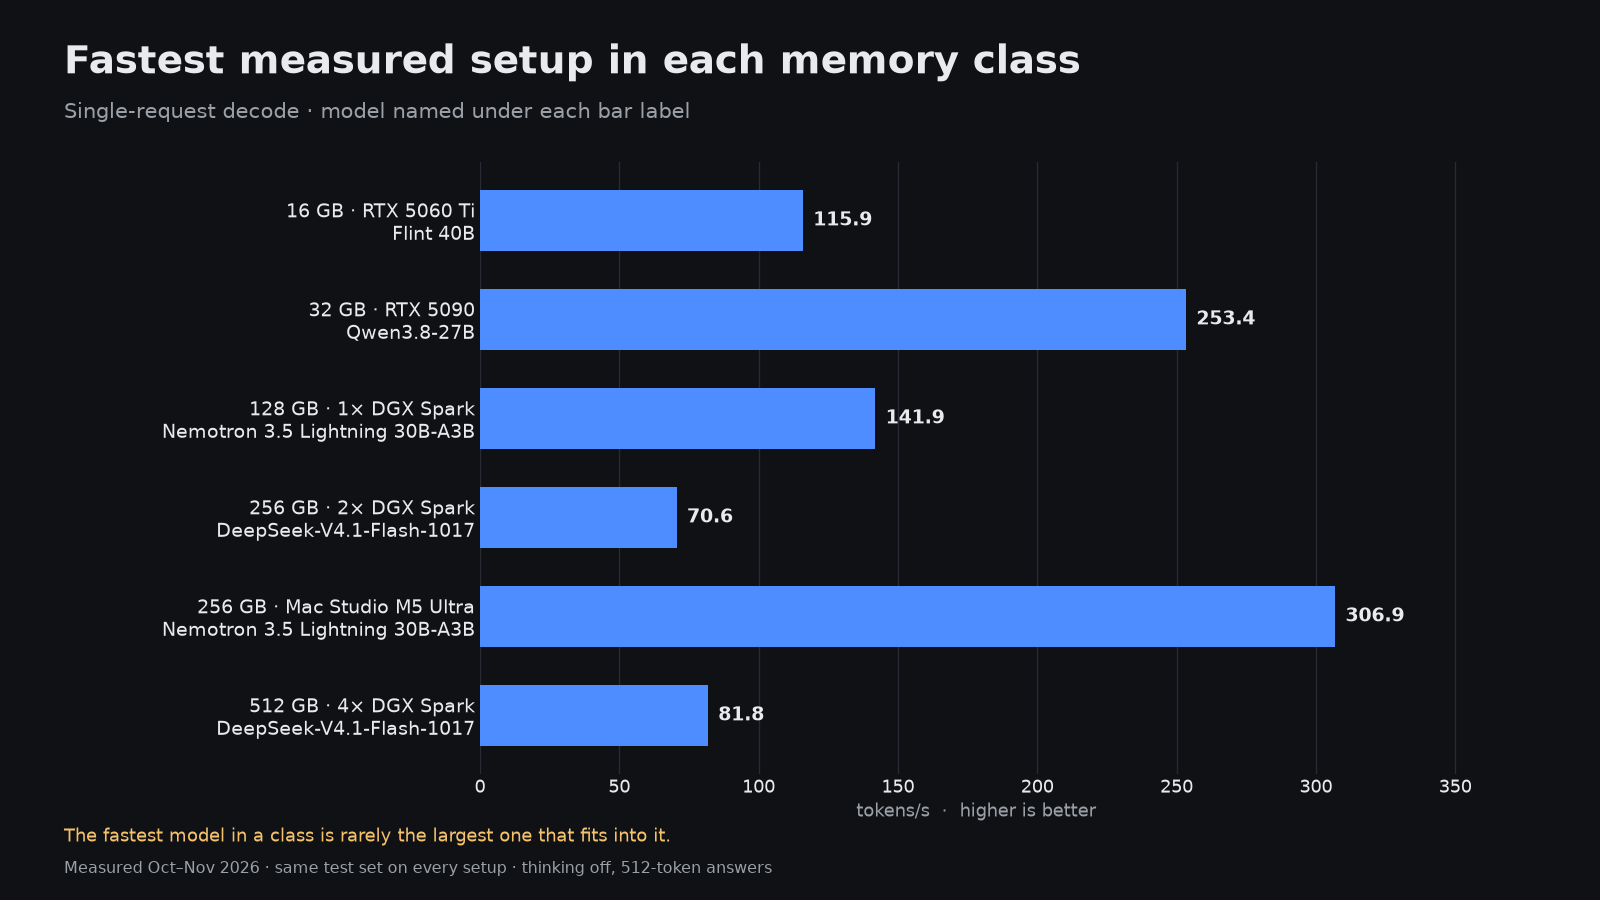
各容量等级下的最高解码速度分别为:16 GB为115.9 tok/s,32 GB为253.4 tok/s,单个Spark节点为141.9 tok/s,两个Spark节点为70.6 tok/s,Mac设备为306.9 tok/s,四个Spark节点为81.8 tok/s。由于这些高容量等级的测试大多使用的是体积更大的模型,而更大模型的解码速度更慢,因此其数值在顶部显得较低。
质量提升几乎跟不上内存容量的增加
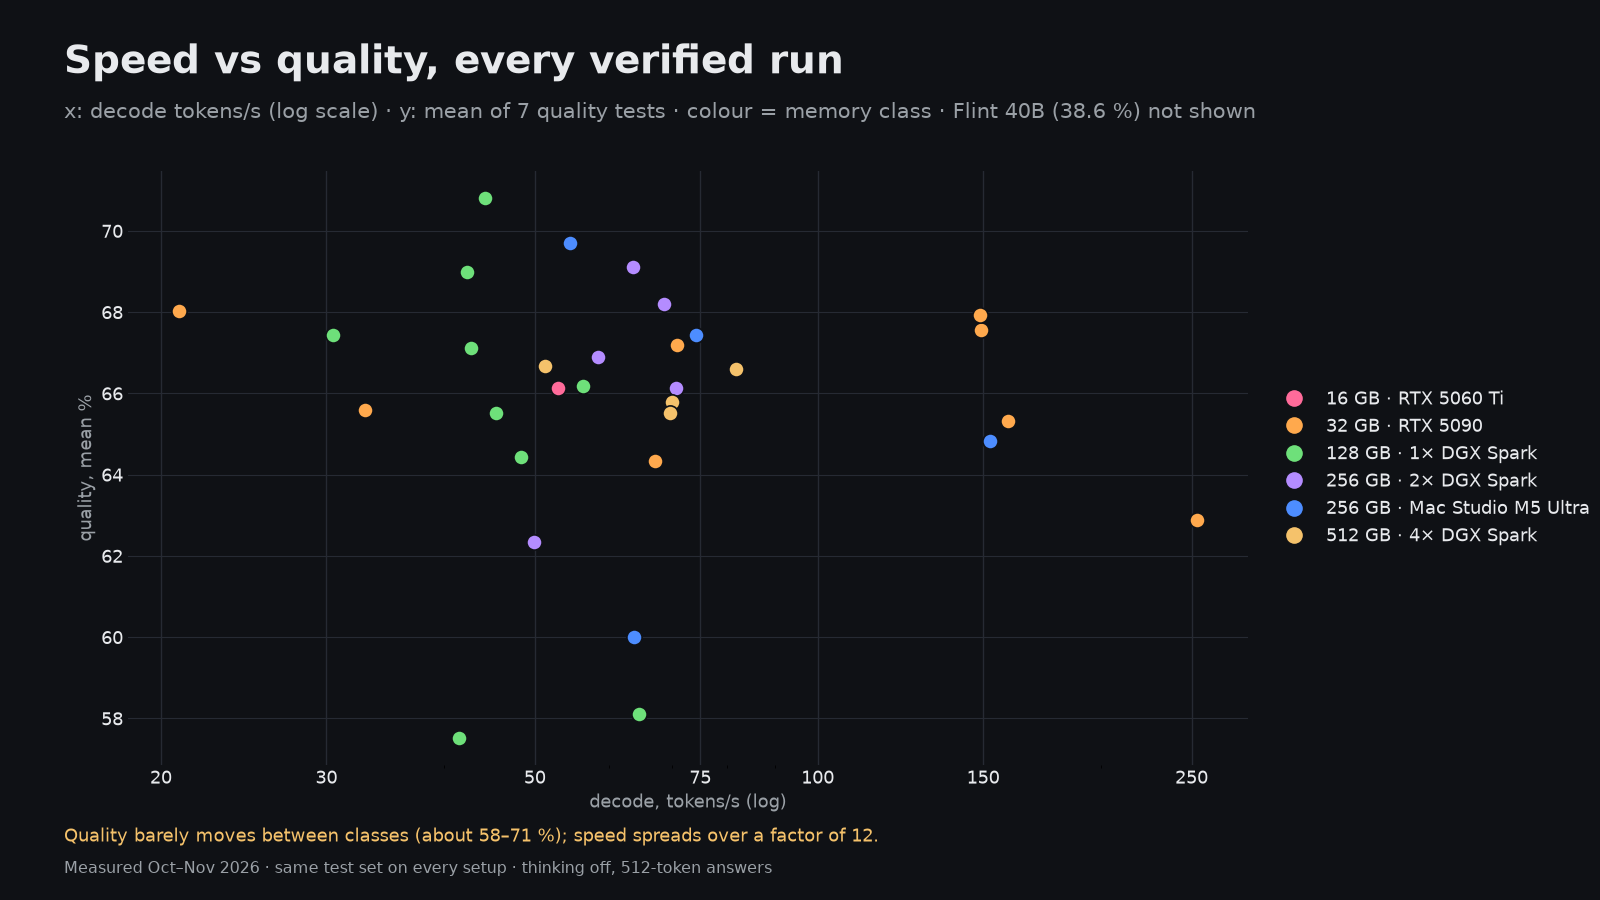
所有完整测试的结果都集中在较窄的质量范围内:无论是在16 GB的显卡上还是512 GB的集群上运行,31项测试的结果都大致在57%至71%之间。在1块5060 Ti显卡上运行的Qwen3.8-27B模型得分率为66.1%,而在4块Sparks显卡上运行的DeepSeek-V4.1-Flash模型得分率为66.6%。更大内存带来的主要好处是更高的上下文长度、支持更多并行用户,以及能够运行规模极大的MoE模型。
四种预算下的同一大型模型
| 配置 | 量化等级 | 解码速度,token/秒 | 8K预填充速度,token/秒 | 平均质量 | 峰值内存使用量 |
|---|---|---|---|---|---|
| RTX 5090 + RAM/NVMe卸载功能 | Maya-S IQ2_XXS | 20.9 | 828 | 68.0 % | 30.9 GiB |
| Mac Studio M5 Ultra | MLX 2/3-bit (e2e3-p4-h8) | 74.2 | 1,763 | 67.4 % | 206.3 GiB |
| 2× DGX Spark | EXL3 2.5 bpw | 70.6 | 2,157 | 66.1 % | 98.7 GiB |
| 4× DGX Spark | EXL3 4.0 bpw | 81.8 | 2,016 | 66.6 % | 103.2 GiB |
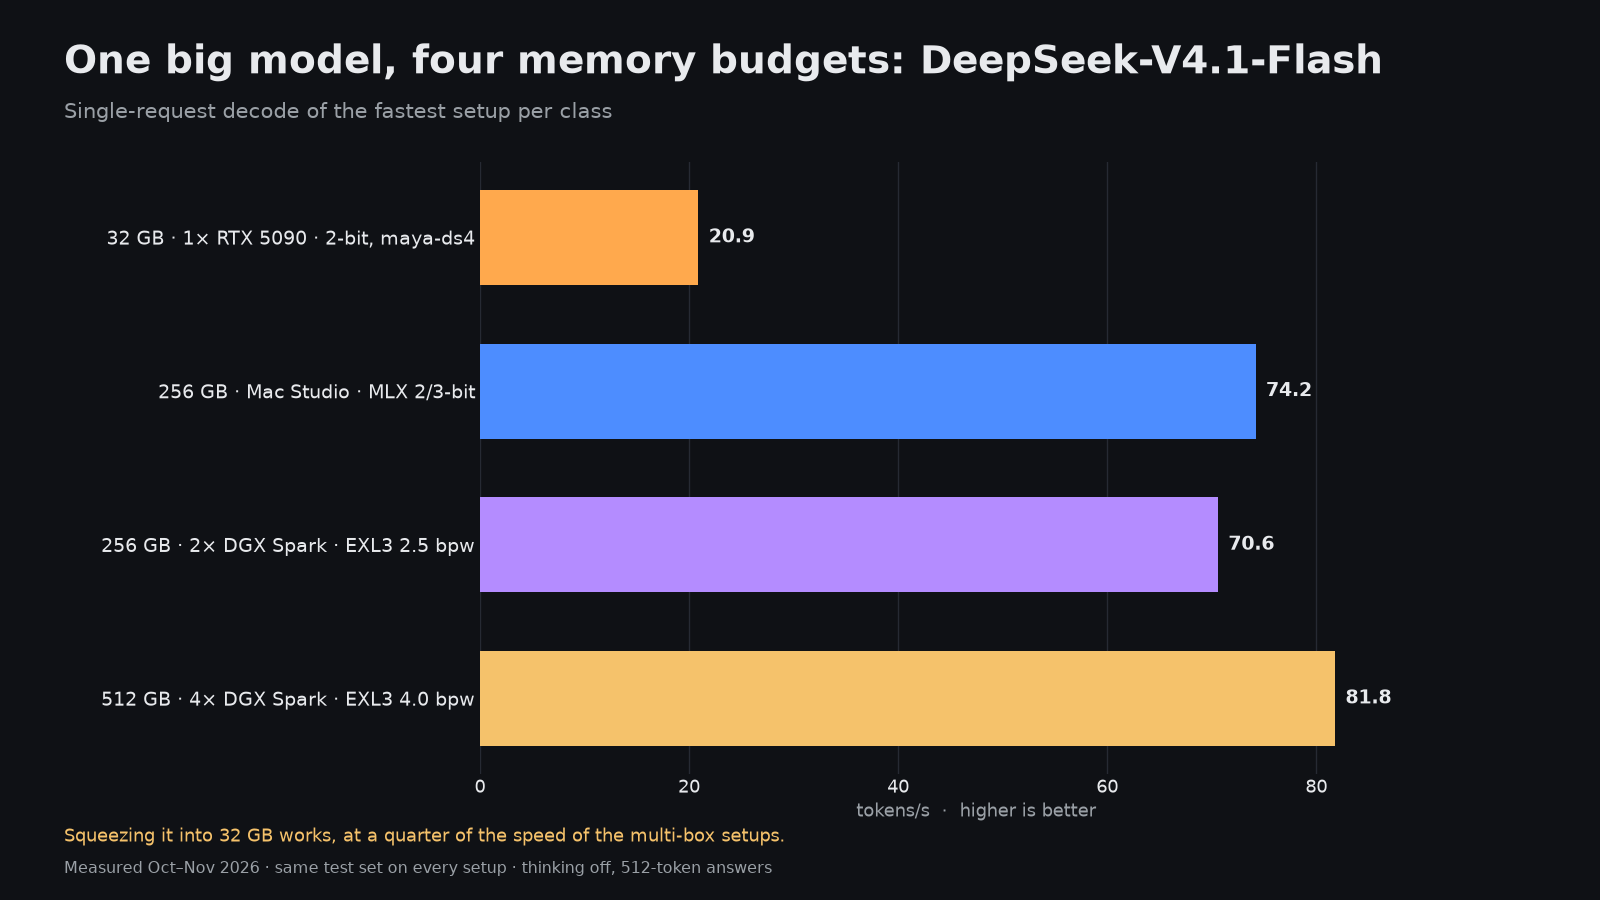
DeepSeek-V4.1-Flash是一个340 GB的模型,我们在四种截然不同的配置下对其进行了测试。在配备96 GB内存及NVMe硬盘、且硬盘上存储了大部分模型的单台RTX 5090上,其解码速度为20.9 tok/s;Mac设备的解码速度为74.2 tok/s,两台Spark设备的解码速度为70.6 tok/s,而四台Spark设备的解码速度则为81.8 tok/s。这四种配置的解码准确率均在66.1%到68.0%之间。通过卸载处理,原本无法运行的模型也能运行起来,但速度仅为原来的四分之一。
上下文也会占用内存
模型权重仅是预算考量的一部分。在RTX 5090上运行的Qwen3.8-27B EXL3 4.0 bpw,在128K上下文长度下的峰值内存占用为18.9 GiB。若将同一模型分配到两块5060 Ti显卡上,则上下文长度可达到256K,内存占用为22.4 GiB。在两块Sparks显卡上运行的Qwen3.8-Flash-Next,则在1M令牌的上下文长度下需要87.9 GiB的内存。在16 GB容量的显卡上,同一模型在不同上下文长度(43,008令牌与117,760令牌)下的内存差异主要取决于量化级别以及引擎的缓存处理方式。
您的硬件对应等级
16至24 GB
RTX 5080、RTX 5070 Ti、RTX 5060 Ti 16 GB、RTX 4090、RTX 4080 Super、RTX 4080、RTX 4070 Ti Super、RTX 4060 Ti 16 GB、RTX 3090 Ti、RTX 3090、RTX PRO 4000 Blackwell、RTX 4500 Ada、RTX 4000 Ada、Radeon RX 9070 XT、Radeon RX 9070、Radeon RX 9060 XT 16 GB、Radeon RX 9060 XT LP、Radeon RX 7900 XTX、Radeon RX 7900 XT、Radeon RX 7900 GRE、Radeon RX 7800 XT、Radeon RX 7600 XT、Radeon RX 6950 XT、Radeon RX 6900 XT、Radeon RX 6800 XT、Radeon RX 6800。这些显卡均采用与RTX 5060 Ti 16 GB参考型号相同的27B级量化格式及带卸载功能的MoE架构。像RTX 4090、3090和RX 7900 XTX这类拥有24 GB显存的显卡,虽然可以支持更长的上下文长度或更高位数的量化,但无法升级到不同的型号层级。
32至96 GB
RTX 5090、RTX PRO 6000 Blackwell、RTX PRO 5000 Blackwell 72 GB、RTX PRO 5000 Blackwell 48 GB、RTX PRO 4500 Blackwell、RTX 6000 Ada、RTX 5000 Ada、RTX A6000、Radeon AI PRO R9700、Radeon AI PRO R9600D、Radeon PRO W7900、Radeon PRO W7800 32 GB、Radeon PRO W7800 48 GB。其中32 GB版本属于RTX 5090系列:采用4到6位精度、上下文容量为128K到256K的270亿参数模型,以及通过RAM卸载技术支持的大规模MoE模型。
128 GB统一内存
Framework Desktop、GMKtec EVO-X2、HP Z2 Mini G1a、ASUS ROG Flow Z13、Mac Studio M5 Max、MacBook Pro M5 Max、NVIDIA DGX Spark、ASUS Ascent GX10、MSI EdgeXpert、Gigabyte AI TOP ATOM、Lenovo ThinkStation PGX、Acer Veriton GN100、HP ZGX Nano G1n,以及所有配备GB10的型号:NVIDIA DGX Spark、ASUS Ascent GX10、配备GB10的Dell Pro Max、MSI EdgeXpert、Gigabyte AI TOP ATOM、Lenovo ThinkStation PGX、Acer Veriton GN100以及HP ZGX Nano G1n。该组中的任何设备都能加载在单个Spark上运行的大约120B级别的模型;Mac电脑和AMD Strix Halo系列设备则能以自身速度运行这些模型。
256 GB及以上
配备256或512 GB存储的Mac Studio M5 Ultra,或通过ConnectX-7连接的两个或四个GB10模块。这一配置可运行340 GB大小的DeepSeek-V4.1-Flash模型以及无需卸载处理的同等容量模型。
选择型号等级
- 单人使用,用于聊天、编程辅助及文本转录:16 GB即可满足需求,32 GB则更为舒适且速度更快。
- 需要处理长上下文编程任务及多用户同时使用:配备批处理引擎的RTX 5090搭配32 GB内存。
- 需运行参数超过1000亿的模型且无法进行卸载处理:需128 GB的统一内存;若追求速度,建议选择Mac;若使用CUDA技术栈,则可选择Spark。
- 能在可接受速度下运行最大的开源MoE模型:需256 GB内存的Mac Studio,或两到四台GB10型号设备。
- 在购买更多内存之前,先检查现有硬件上是否可通过更优的引擎或量化技术来弥补性能差距。在同样的RTX 5090上,仅软件栈的改进就使速度提升了近4倍。