RTX 5060 Ti 16 GB для локального ИИ: измеренные скорости работы нейросетей типа LLM, изображений и аудио.
RTX 5060 Ti 16 GB в тестах для локального ИИ: пять нейросетей типа LLM с скоростью обработки от 42 до 116 токенов в секунду, время обработки первого токена на уровне 32 тыс., скорости обработки изображений, видео, 3D-моделей и аудио, а также что можно запускать на этой карте.
Карта 16 ГБ RTX 5060 Ti — это основа многих домашних систем искусственного интеллекта: у неё достаточно видеопамяти для языковой модели объёмом 27 миллиардов параметров, а цена соответствует бюджету обычного настольного ПК. Это поднимает очевидный вопрос: насколько быстро она работает при загрузке реально полезных данных? Ниже приведены измеренные показатели для пяти языковых моделей, двух моделей обработки изображений, одной видеомодели, одной 3D-модели и одной модели обработки речи на одной карте, а также изменения, которые происходят при добавлении второй карты 5060 Ti или переходе на RTX 5090.
При работе с каждой языковой моделью используется один и тот же набор параметров: ответы длиной 512 токенов на кодовые и прозаические запросы, предварительная настройка, медианное значение результатов нескольких запусков. Обработка запросов измеряется при объёмах 2K, 8K и 32K токенов, а тест на контекст позволяет оценить работу каждой конфигурации до тех пор, пока она больше не может обрабатывать данные.
Пять моделей, которые помещаются в 16 ГБ
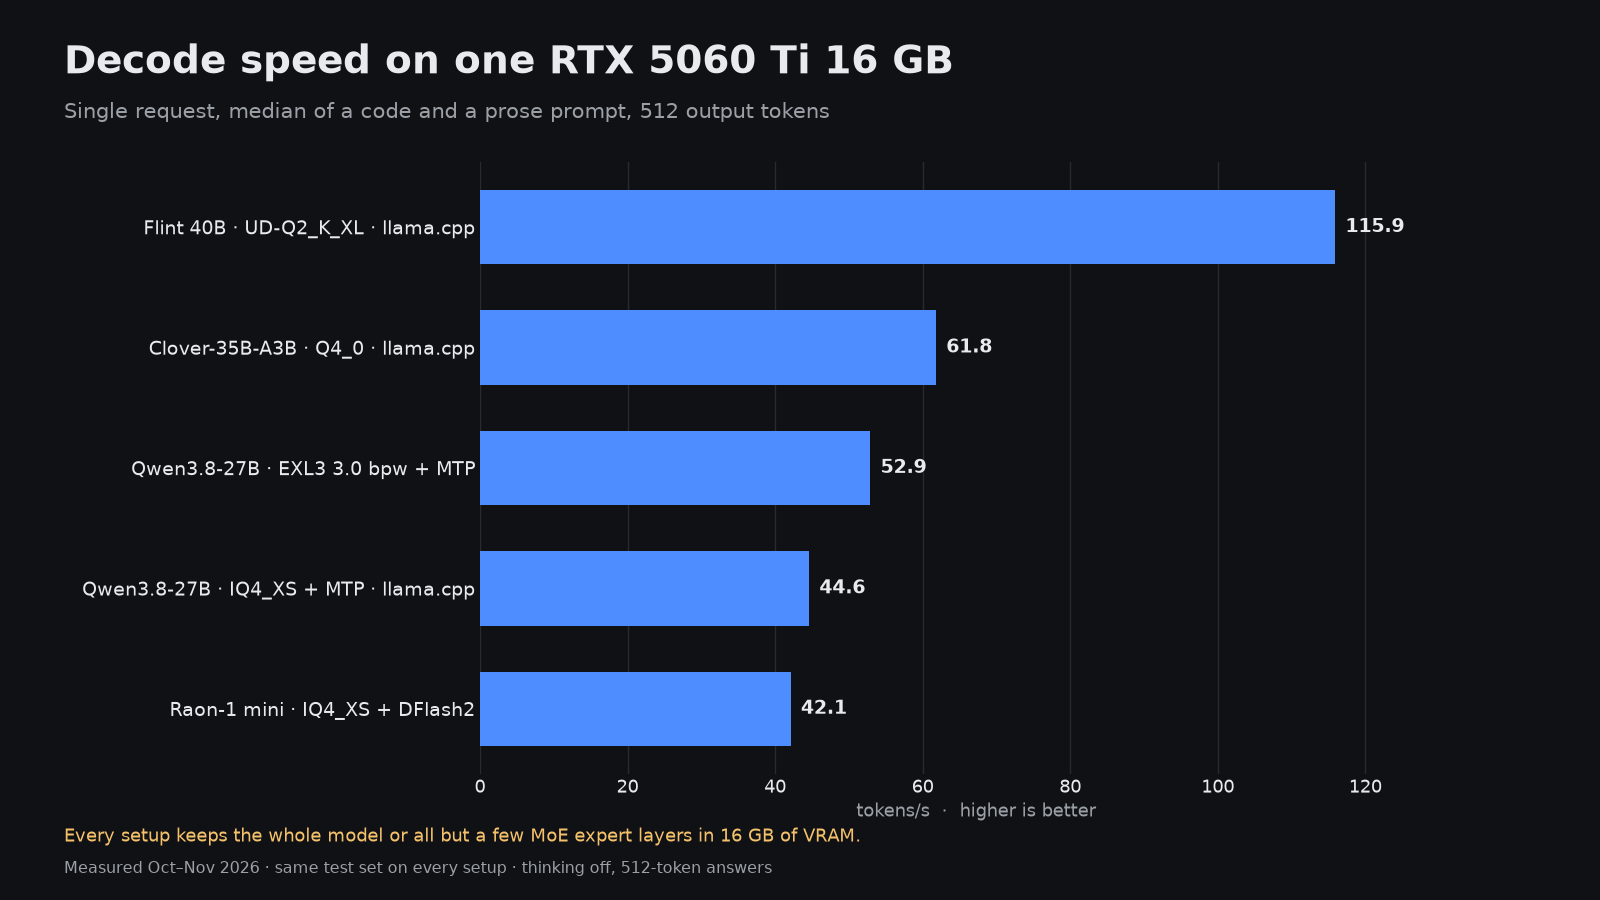
| Модель и способ квантования | Движок | Скорость декодирования, токенов/сек | Скорость предзаполнения 8K, токенов/сек | Время получения первого токена при объеме данных 32K | Максимальный объем контекста | Максимальное использование VRAM |
|---|---|---|---|---|---|---|
| Flint 40B UD-Q2_K_XL | llama.cpp | 115,9 | 2 364 | 15,6 с | 64K | 14,7 ГиБ |
| Clover-35B-A3B Preview Q4_0 | llama.cpp, 20 слоев экспертов в ОЗУ | 61,8 | 992 | 37,4 с | 128K | 14,8 ГиБ |
| Qwen3.8-27B EXL3 3.0 bpw | ExLlamaV3 с MTP | 52.9 | 1,027 | 35.7 с | 117,760 | 15.2 ГиБ |
| Qwen3.8-27B ByteShape IQ4_XS | llama.cpp с MTP | 44.6 | 998 | 36.8 с | 43,008 | 15.4 ГиБ |
| Raon-1 mini preview IQ4_XS | llama.cpp, 9 слоев экспертов в ОЗУ | 42.1 | 586 | 61.6 с | 16K | 12.9 ГиБ |
Разница между значениями сверху и снизу составляет почти 3 раза, и рейтинг по чистой скорости не является оптимальным для ежедневного использования. Только версия Qwen3.8-27B EXL3 имеет полную оценку качества на этой карте (66.1 % в среднем по семи тестам). Остальные были оценены по скорости и объему контекста, но пока не ранжированы.
Flint 40B быстр, потому что его эффективно оптимизировали
Flint 40B достигает скорости 115,9 токенов в секунду, причем скорость обработки кода и прозы отличается всего на 0,2 токена в секунду. Это достигается за счёт использования 2-битной квантовки Unsloth (UD-Q2_K_XL), которая позволяет сохранить весь модель в VRAM объёмом 14,7 ГБ, оставляя место лишь для контекста объёмом 64 КБ. На карте 5090 версия модели с поддержкой NVFP4 показала 38,6% в тестах качества, что является самым низким показателем среди всех тестов на этой карте. Рассматривайте Flint как быстрый модель для первичной разработки и чата, а не как инструмент для проверки кода.
Qwen3.8-27B — оптимальный выбор
Версия Qwen3.8-27B EXL3 3.0 bpw из набора ExLlamaV3 с одним кликом обрабатывает текст со скоростью 52,9 токенов в секунду (53,6 при обработке кода и 52,1 при обработке прозы), при этом она может хранить контекст объёмом 117 760 токенов в VRAM объёмом 15,2 ГБ. Это лучшее сочетание скорости, объёма контекста и качества среди всех моделей в этом наборе, работающих на картах с объёмом памяти 16 ГБ.
Модель ByteShape IQ4_XS GGUF того же формата служит полезным контрастом. Она сохраняет больше бит на вес (3,84 bpw), поэтому при квантизации теряет меньше данных, однако её скорость декодирования составляет 44,6 токена в секунду, варианты MTP, которые она генерирует, принимаются в 49,3 % случаев, а предел длины контекста снижается до 43 008 токенов при объеме памяти 15,4 ГБ. Если вы в основном работаете с большими файлами или сессиями агентов, дополнительный объем контекста в версии EXL3 важнее, чем дополнительные биты.
Время генерации первого токена
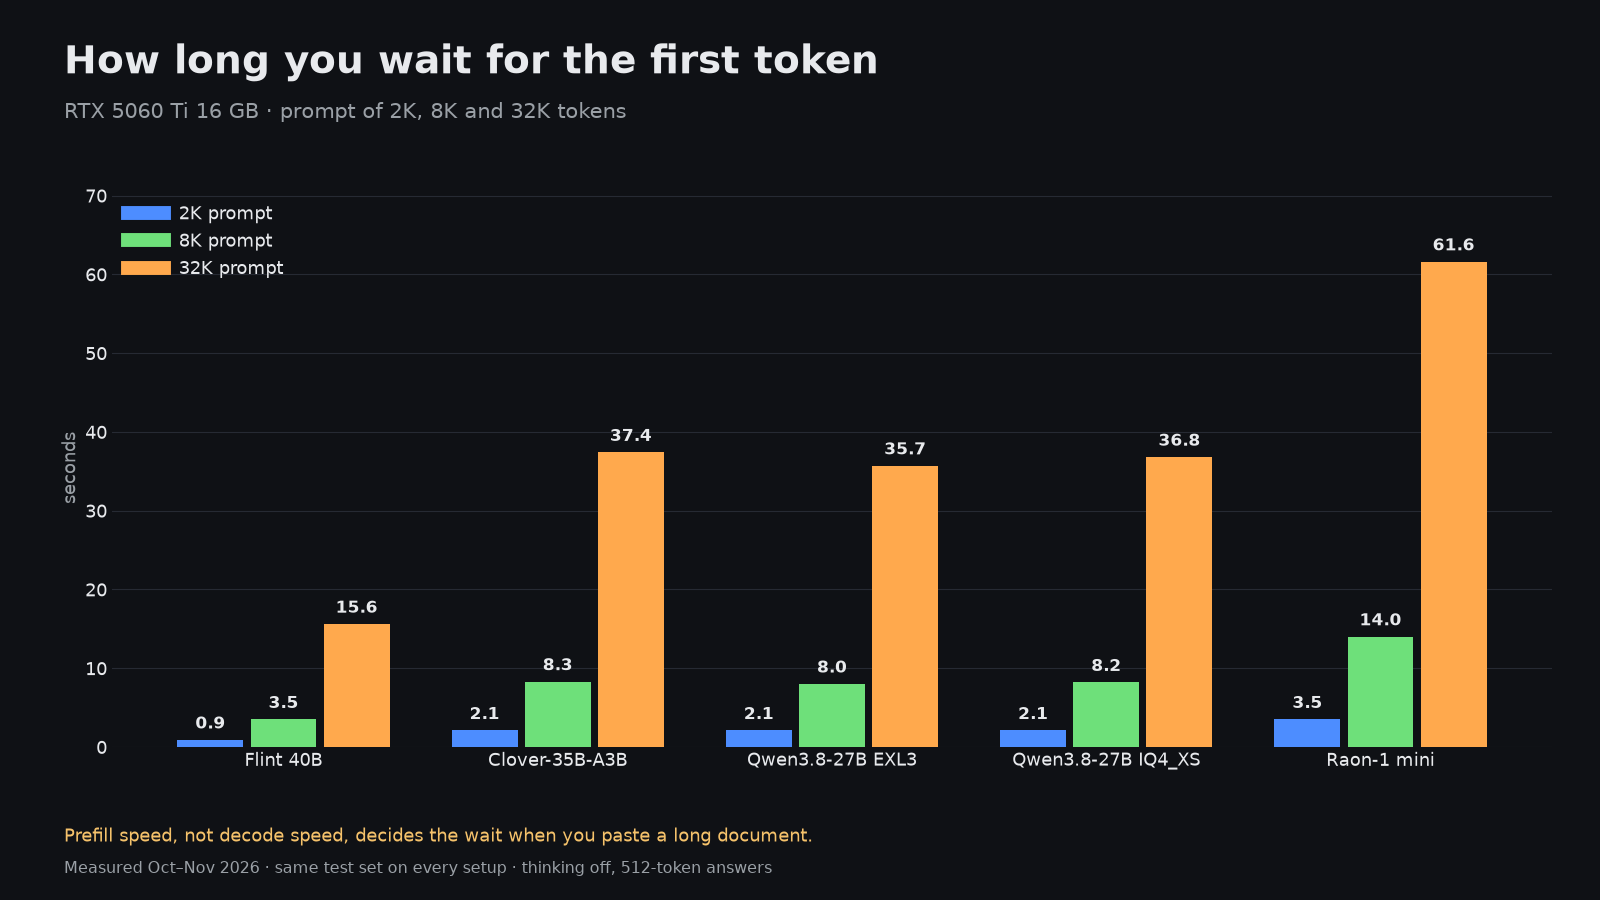
Скорость декодирования — это то, на что обычно обращают внимание в тестах производительности, но при использовании карты на 16 ГБ более серьезной проблемой часто является время ожидания до получения результата. Запрос длиной 32 К токенов, что соответствует примерно среднему размеру файла с кодом, занимает 15,6 секунды на Flint, 35,7 секунды на Qwen3.8-27B и 61,6 секунды на Raon-1 mini. Скорость заполнения контекста на этой карте для густой модели размером 27 миллиардов параметров составляет примерно 1 027 токенов в секунду, так что каждые дополнительные 10 К токенов контекста увеличивают время ожидания первого слова примерно на десять секунд.
Если ваша работа связана с чатом с короткими запросами, важна скорость декодирования. Если же речь идет о технологиях RAG, кодирующих агентах или длинных документах, сначала следует сравнить время заполнения контекста и время получения первого токена.
Модели MoE с экспертами в оперативной памяти системы
Модели на основе смеси экспертов — это основной способ обработки данных объемом, превышающим тот, который обычно позволяют 16 ГБ памяти. С помощью параметра --n-cpu-moe llama.cpp может сохранять веса экспертов первых слоев в оперативной памяти системы, а остальную работу выполняет GPU. Превью версии Clover-35B-A3B Preview at Q4_0 с 20 слоями экспертов в оперативной памяти работает со скоростью 61,8 токов в секунду, поддерживает контекст длиной 128 Кб и достигает максимального использования VRAM в 14,8 Гб на устройстве с 32 ГБ оперативной памяти. Скорость также увеличивается при параллельных запросах: общая пропускная способность растет с 46,1 токов в секунду при одном запросе до 72,3 токов в секунду при четырех запросах.
Превью версии Raon-1 mini демонстрирует негативные последствия чрезмерного использования этого подхода. При наличии 9 слоев экспертов в оперативной памяти скорость декодирования составляет 42,1 тока в секунду, модель принимает лишь 17,7% своих черновиков в формате DFlash2, поддерживает контекст длиной 16 Кб, а результаты тестов качества составляют в среднем 45,1%. Перенос работы на другие устройства действительно помогает, но это компромисс, а не бесплатное увеличение объема памяти.
Одна карта, две карты или RTX 5090
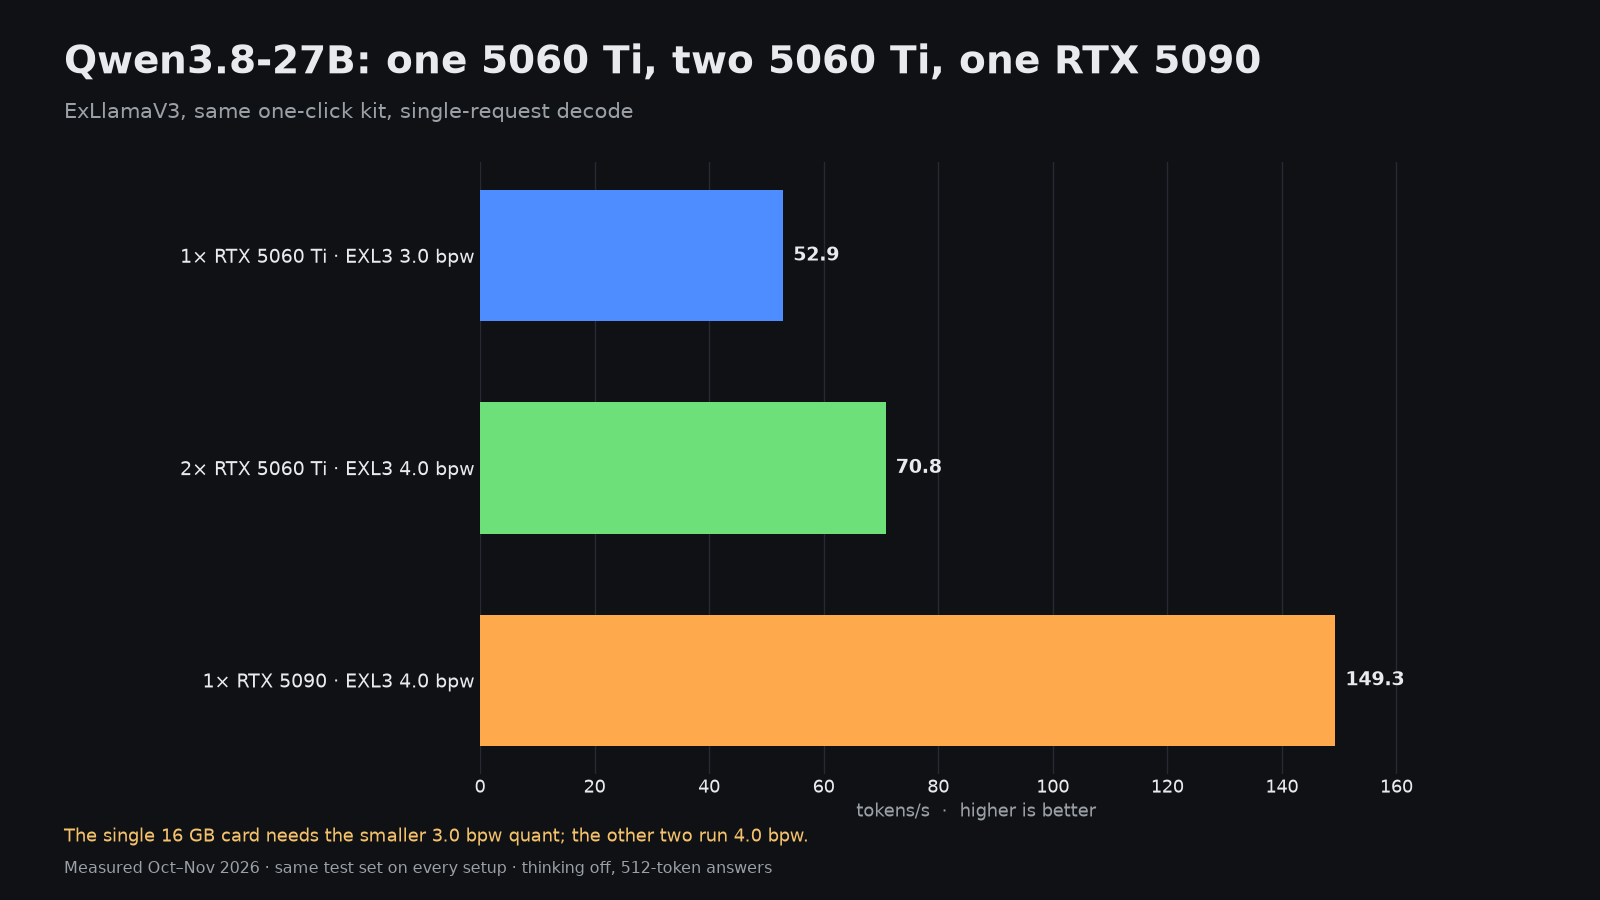
Вторая карта 5060 Ti с поддержкой тензорного параллелизма повышает скорость декодирования Qwen3.8-27B до 70,8 токов/сек; что ещё важнее, она позволяет использовать формат квантования EXL3 с разрешением 4,0 бит на слово и контекстом объемом 256 Кб, что обеспечивает скорость обработки 22,4 ГиБ на обе карты. Средний уровень качества выходного контента возрастает до 67,2%. Это действительно значительное улучшение, но скорость увеличивается примерно на 34%, а не вдвое.
RTX 5090 работает с той же конфигурацией 4.0 bpw со скоростью 149,3 tok/s, что примерно в 2,8 раза выше, чем у одной карты 5060 Ti, и в 2,1 раза — чем у двух таких карт. Скорость обработки изображений в разрешении 8K увеличивается с 1 027 до 3 484 tok/s. Если главная цель — скорость, то одна более мощная карта лучше, чем две менее мощные; если у вас уже есть карта 5060 Ti, вторая карта позволит улучшить качество обработки контекста и использовать более эффективные методы квантования.
Изображения, видео, 3D-графика и обработка речи на одной карте
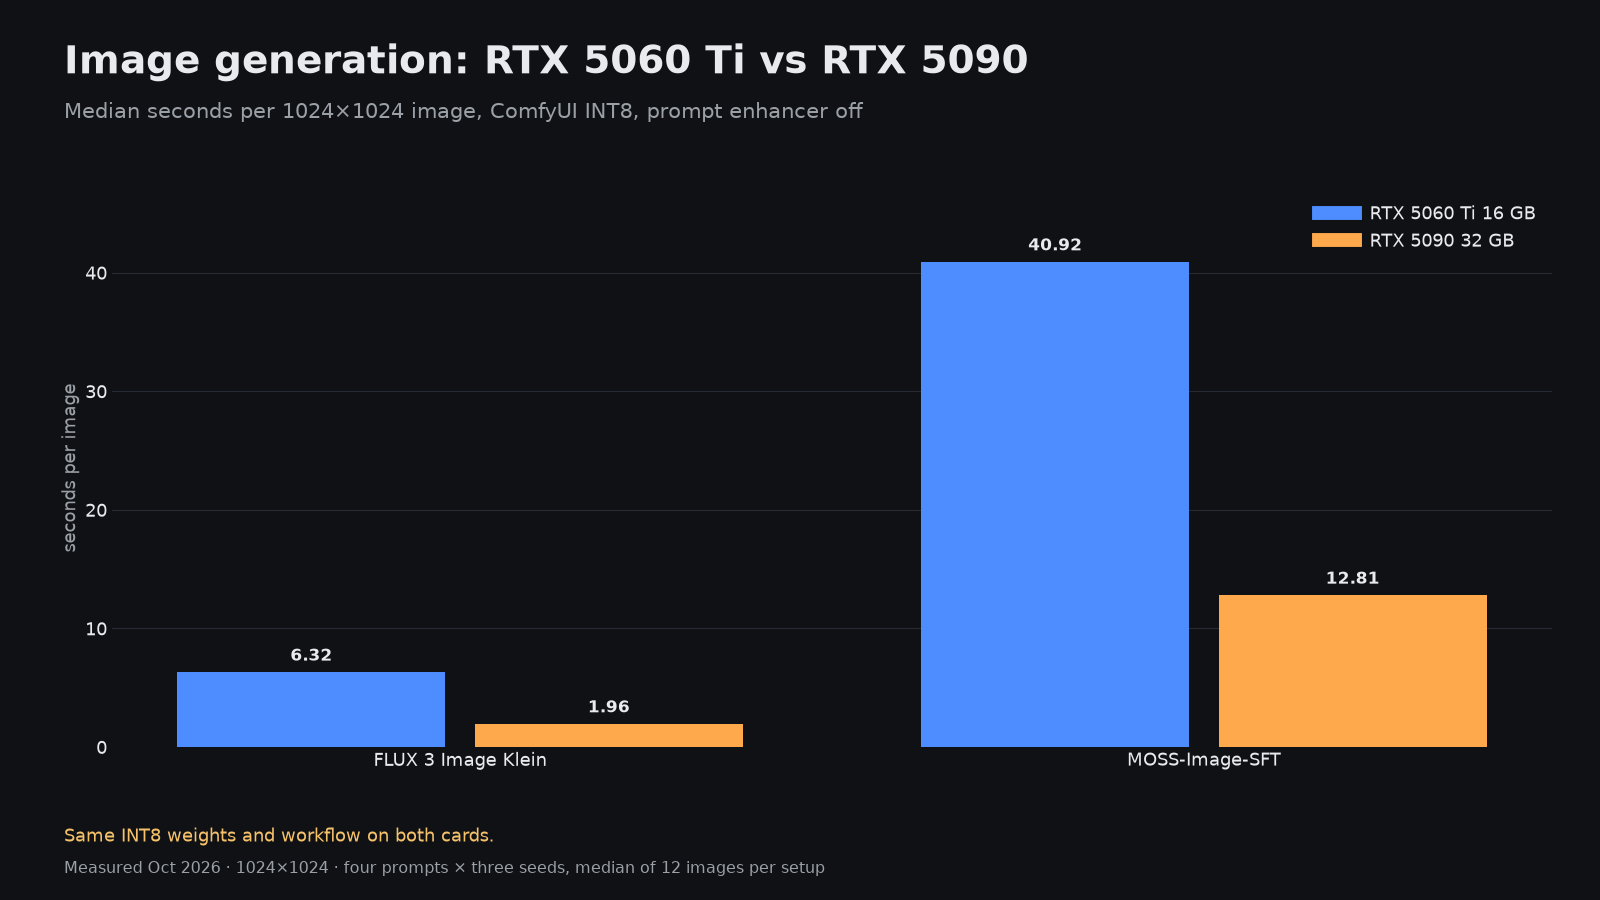
| Задача | RTX 5060 Ti 16 ГБ | RTX 5090 32 ГБ |
|---|---|---|
| Обработка изображения с помощью FLUX Klein | 6,32 с | 1,96 с |
| Изображение MOSS | 40,92 с | 12,81 с |
| 3D-модель Idol, одна картинка для сгенерации меша | 57,4 с | 14,5 с |
| HyperFlow H3 Flash, 5-секундный клип с звуком, формат GGUF Q4_K_M | 562,2 с | 107,1 с |
Изображения и 3D-модели полностью работоспособны на карте с 16 ГБ: сгенерация изображения FLUX Klein за примерно шесть секунд подходит для итераций. Проблемы возникают с видео — карта не справляется с нагрузкой. Один 5-секундный клип HyperFlow H3 Flash в разрешении 1344×768 требует 562,2 с, то есть чуть более девяти минут, тогда как на карте 5090 с тем же файлом формата Q4_K_M время обработки составляет 107,1 с, а у версии в формате INT8, требующей более мощной карты, — 86,8 с.
Распознавание речи поражает своими результатами. Nemotron 3.5 Transcribe обрабатывает 59 минут 39 секунд чистого аудио из тестов LibriSpeech за 120 секунд на видеокарте 5060 Ti, что соответствует 29,8× скорости реального времени, при уровне ошибок в словах 1,54%. Для транскрипции 16 ГБ — более чем достаточно.
Что покупать и что использовать
- Для одной карты объемом 16 ГБ начните с модели Qwen3.8-27B EXL3 3.0 bpw в ExLlamaV3: скорость обработки — 52,9 токена/сек, объем контекста — около 115 тыс., качество оценивается высоко.
- Используйте модель Flint 40B для быстрой переписки и составления текстов со скоростью 115,9 токена/сек, а более мощную модель оставьте для задач, где важна точность.
- Попробуйте модель Clover-35B-A3B с расположением экспертных модулей в ОЗУ, если вам нужен объем контекста 128 тыс. и у вас есть не менее 32 ГБ оперативной памяти.
- Ожидайте медленной обработки первых токенов при длинных запросах. На такой карте следует ограничивать размер фрагментов данных RAG и контекста агента.
- Обработка изображений, 3D-моделей и транскрипции происходит без проблем. Генерация видео работает, но из-за времени в среднем девять минут на каждый 5-секундный фрагмент это задача, требующая обработки пакетом.
- Если вы сегодня выбираете оборудование и скорость имеет большое значение, то RTX 5090 — это значительный шаг вперед по сравнению с ещё одной картой 5060 Ti.
Как были получены эти показатели
Во всех тестах объёмом 16 ГБ используется одна карта RTX 5060 Ti 16 ГБ под управлением Linux; в качестве основного компьютера использовался процессор Core i7-12700K с 32 ГБ ОЗУ. Скорость работы языковой модели определяется как медиана результатов повторных ответов длиной 512 токенов после разогрева; скорость заполнения информацией измеряется для фиксированных промптов размером 2K, 8K и 32K, а предел контекста — это самый длинный промпт, который удаётся загрузить и обработать. Качество оценивается как среднее значение по семи одинаково проведённым тестам на каждой тестовой конфигурации. Время обработки изображений и видео — это медианное время от момента запроса до готовности файла.