¿Cuánta memoria se necesita para la IA local? Velocidades desde 16 GB hasta 512 GB.
Se midió la velocidad y calidad local de los LLM en máquinas de 16, 32, 128, 256 y 512 GB, qué puede ejecutar cada categoría, y qué GPUs, Macs y mini PCs son adecuados para cada caso.
La primera pregunta al crear una IA local es cuánta memoria se necesita, y la respuesta honesta es que la memoria determina qué modelos se cargan, mientras que el hardware subyacente decide cuán rápido se ejecutan. A continuación se presentan los resultados medidos en seis categorías de memoria, desde una tarjeta gráfica de 16 GB hasta un clúster GB10 de cuatro unidades con 512 GB, utilizando siempre el mismo conjunto de pruebas.
Cada categoría se midió en una máquina de referencia. Otro hardware con la misma cantidad de memoria cargará los mismos modelos, pero su velocidad será diferente; por lo tanto, las listas de hardware compatible que se presentan a continuación se refieren a lo que es compatible, no a la velocidad de ejecución.
Seis categorías, seis máquinas de referencia
| Categoría de memoria | En qué se midió | Configuraciones | Puntuación total | Decodificación más rápida | Mejor calidad |
|---|---|---|---|---|---|
| 16 GB | RTX 5060 Ti 16 GB | 5 | 1 | Flint 40B, 115.9 tok/s | Qwen3.8-27B, 66.1 % |
| 32 GB | RTX 5090 32 GB | 12 | 9 | Qwen3.8-27B, 253.4 tok/s | DeepSeek-V4.1-Flash-1017, 68.0 % |
| 128 GB | 1× DGX Spark (GB10) | 15 | 9 | Nemotron 3.5 Lightning 30B-A3B, 141.9 tok/s | Ornith-1.5-122B, 70.8 % |
| 256 GB | 2× DGX Spark (GB10) | 9 | 5 | DeepSeek-V4.1-Flash-1017, 70.6 tok/s | DeepSeek-V4.1-Flash-1017, 69.1 % |
| 256 GB Mac | Mac Studio M5 Ultra 256 GB | 8 | 4 | Nemotron 3.5 Lightning 30B-A3B, 306.9 tok/s | DeepSeek-V4.1-Flash-1017, 69.7 % |
| 512 GB | 4× DGX Spark (GB10) | 5 | 4 | DeepSeek-V4.1-Flash-1017, 81.8 tok/s | DeepSeek-V4.1-Flash-1017, 66.7 % |
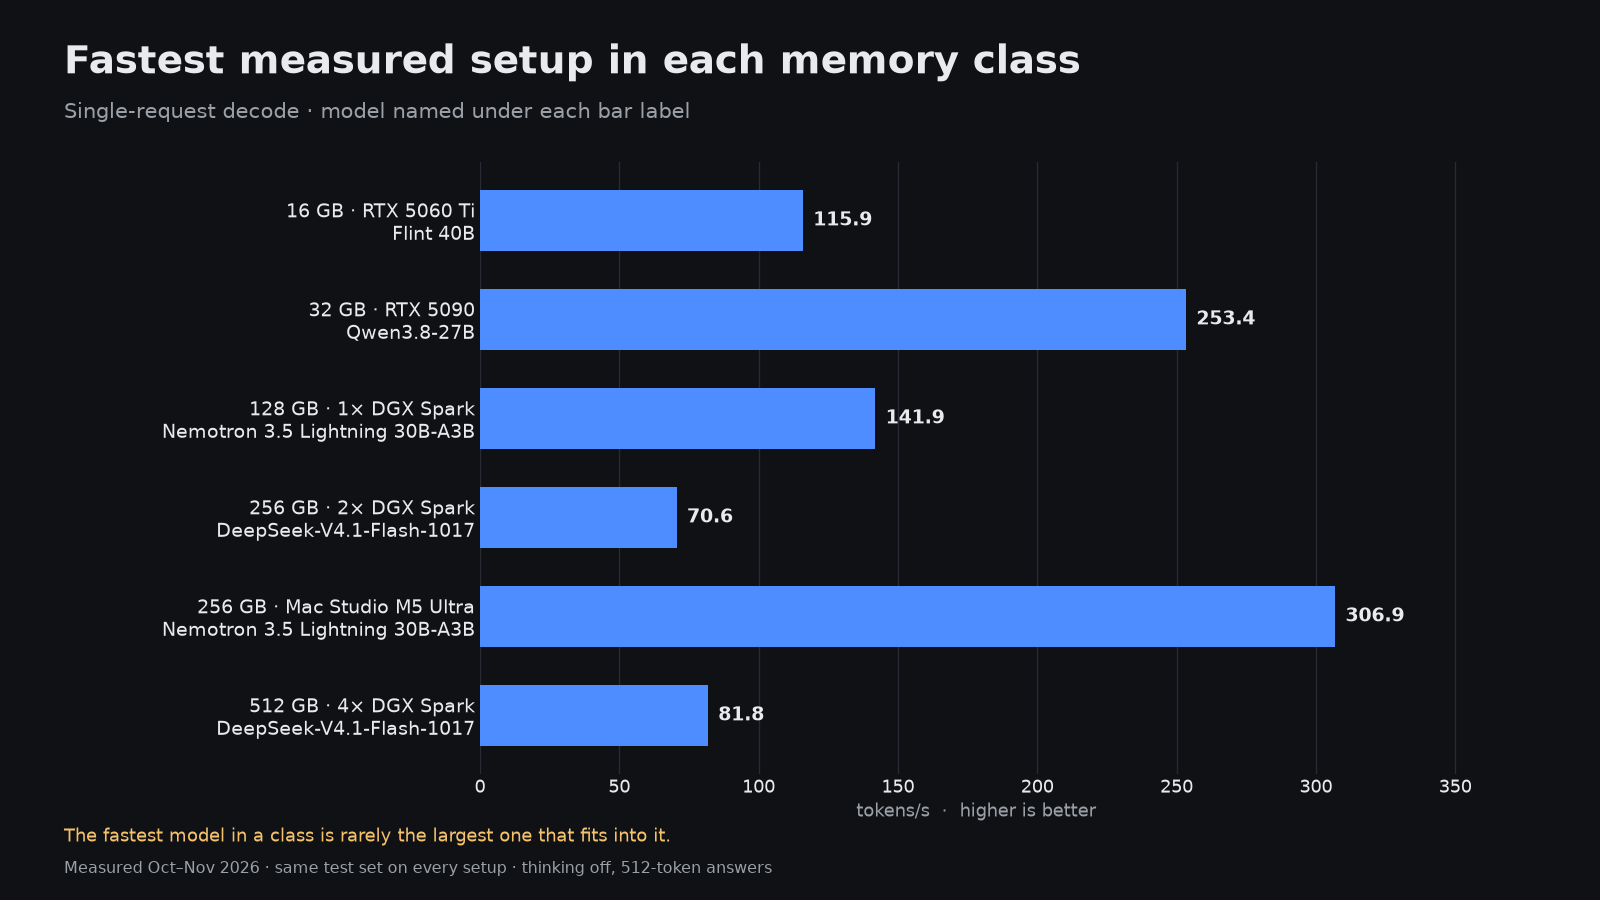
El mejor resultado por categoría es de 115.9 tok/s en 16 GB, 253.4 en 32 GB, 141.9 en un nodo Spark, 70.6 en dos nodos Spark, 306.9 en la Mac y 81.8 en cuatro nodos Spark. Las categorías de mayor capacidad parecen más lentas porque sus pruebas suelen involucrar modelos mucho más grandes, y los modelos más grandes se decodifican más lentamente.
La calidad apenas sigue al tamaño de la memoria
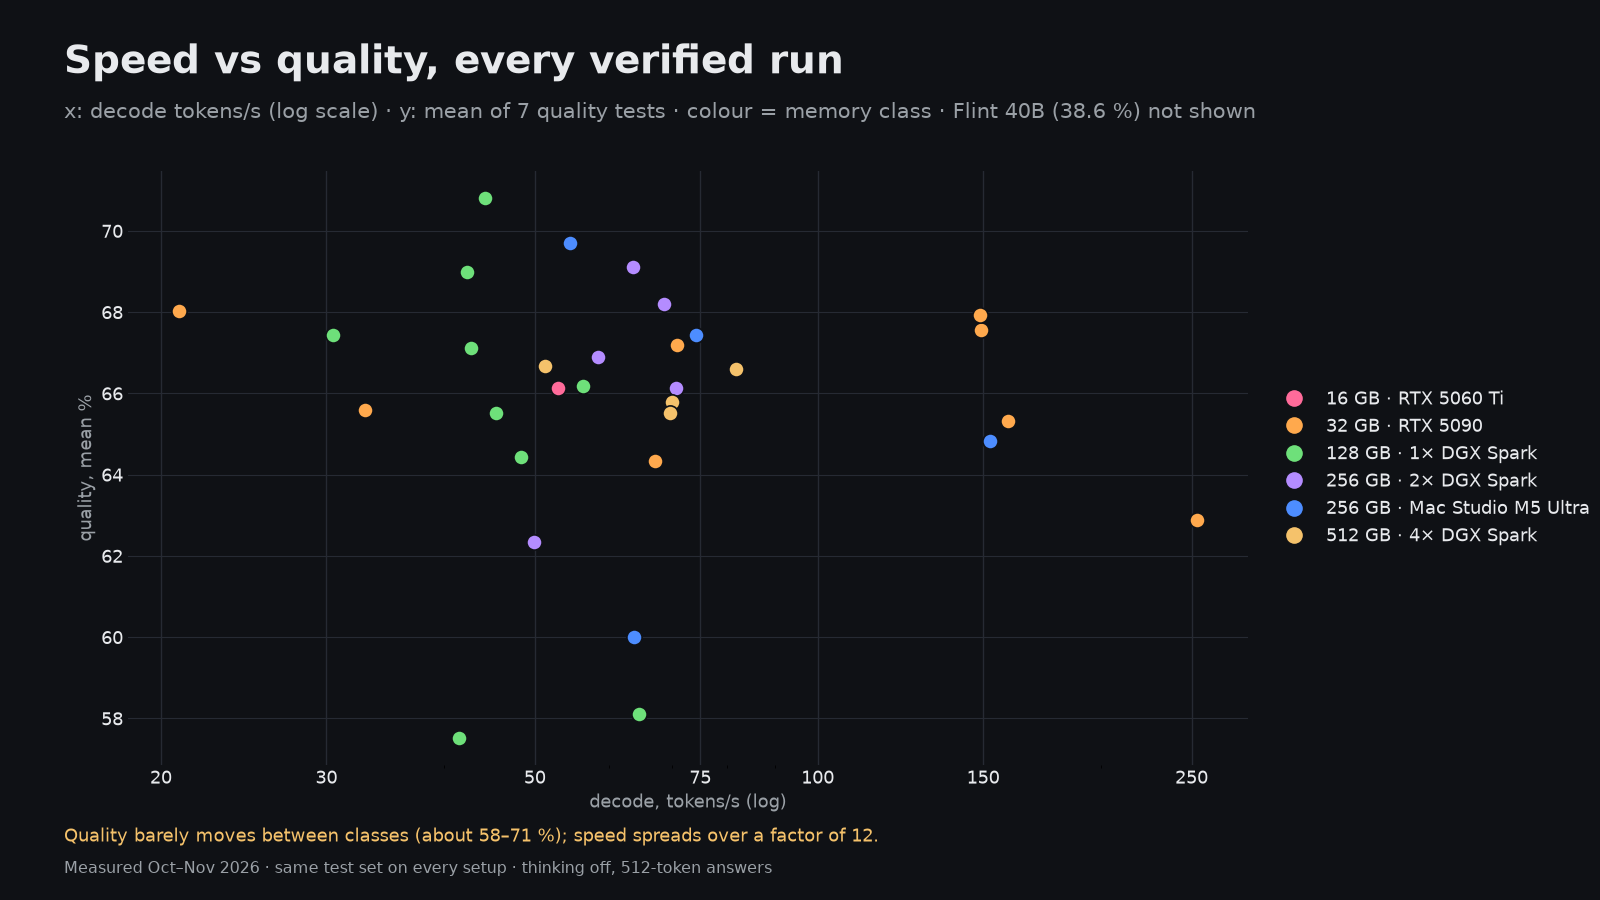
Cada prueba completa tiene un rango de calidad bastante estrecho: las 31 pruebas realizadas se encuentran entre aproximadamente el 57 % y el 71 %, independientemente de que se ejecuten en una tarjeta de 16 GB o en un clúster de 512 GB. Qwen3.8-27B en una tarjeta 5060 Ti obtiene un 66,1 %; DeepSeek-V4.1-Flash en cuatro tarjetas Sparks alcanza un 66,6 %. Lo que ofrece una mayor cantidad de memoria es principalmente la longitud del contexto, la posibilidad de tener más usuarios en paralelo y la opción de ejecutar modelos MoE de gran tamaño.
Un modelo grande a cuatro presupuestos diferentes
| Configuración | Quantización | Decodificación, tok/s | Relleno previo 8K, tok/s | Calidad promedio | Memoria máxima |
|---|---|---|---|---|---|
| RTX 5090 + transferencia de carga a RAM/NVMe | Maya-S IQ2_XXS | 20.9 | 828 | 68.0 % | 30.9 GiB |
| Mac Studio M5 Ultra | MLX 2/3-bit (e2e3-p4-h8) | 74.2 | 1,763 | 67.4 % | 206.3 GiB |
| 2× DGX Spark | EXL3 2.5 bpw | 70.6 | 2,157 | 66.1 % | 98.7 GiB |
| 4× DGX Spark | EXL3 4.0 bpw | 81.8 | 2,016 | 66.6 % | 103.2 GiB |
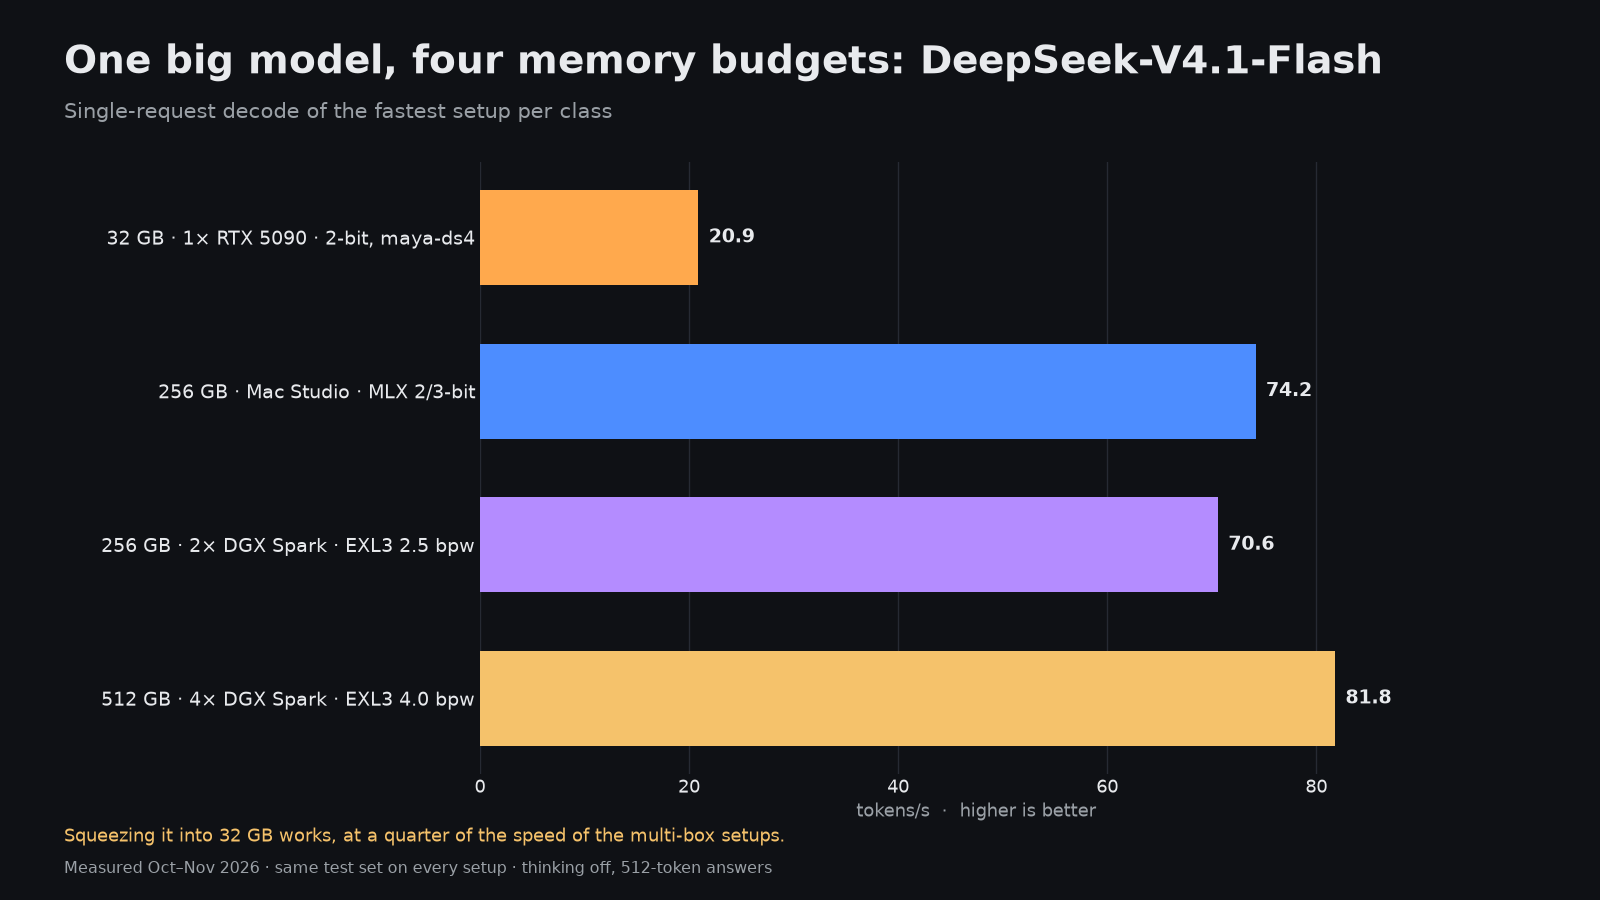
DeepSeek-V4.1-Flash es un modelo de 340 GB, y se midió con cuatro presupuestos muy diferentes. En una sola RTX 5090 con 96 GB de RAM y una unidad NVMe que alberga la mayoría de los expertos, su tasa de decodificación es de 20.9 tok/s. La Mac alcanza 74.2, dos unidades Spark 70.6 y cuatro unidades Spark 81.8. Todos los casos obtienen resultados entre el 66.1 y el 68.0 %. La descarga externa convierte un modelo que no se puede ejecutar en uno que sí se puede, pero a una cuarta parte de la velocidad.
El contexto también consume memoria
Los pesos del modelo son solo una parte del presupuesto. Qwen3.8-27B EXL3 4.0 bpw en la RTX 5090 alcanza un máximo de 18.9 GiB con un contexto de 128K. El mismo modelo distribuido en dos tarjetas 5060 Ti logra un contexto de 256K con 22.4 GiB. Qwen3.8-Flash-Next en dos Sparks carga un contexto de 1M de tokens con 87.9 GiB. En una tarjeta de 16 GB, la diferencia entre 43,008 y 117,760 tokens de contexto en el mismo modelo depende de la cuantización y del manejo de la caché del motor.
Dónde se sitúa su hardware
16 a 24 GB
RTX 5080, RTX 5070 Ti, RTX 5060 Ti 16 GB, RTX 4090, RTX 4080 Super, RTX 4080, RTX 4070 Ti Super, RTX 4060 Ti 16 GB, RTX 3090 Ti, RTX 3090, RTX PRO 4000 Blackwell, RTX 4500 Ada, RTX 4000 Ada, Radeon RX 9070 XT, Radeon RX 9070, Radeon RX 9060 XT 16 GB, Radeon RX 9060 XT LP, Radeon RX 7900 XTX, Radeon RX 7900 XT, Radeon RX 7900 GRE, Radeon RX 7800 XT, Radeon RX 7600 XT, Radeon RX 6950 XT, Radeon RX 6900 XT, Radeon RX 6800 XT, Radeon RX 6800. Estas tarjetas utilizan los mismos cuantizadores de clase 27B y configuraciones MoE con descarga que la referencia RTX 5060 Ti 16 GB. Las tarjetas con 24 GB, como la RTX 4090, 3090 y RX 7900 XTX, tienen capacidad para un contexto más largo o un cuantizador de mayor bitaje, pero no para un nivel de modelo diferente.
32 a 96 GB
RTX 5090, RTX PRO 6000 Blackwell, RTX PRO 5000 Blackwell 72 GB, RTX PRO 5000 Blackwell 48 GB, RTX PRO 4500 Blackwell, RTX 6000 Ada, RTX 5000 Ada, RTX A6000, Radeon AI PRO R9700, Radeon AI PRO R9600D, Radeon PRO W7900, Radeon PRO W7800 32 GB, Radeon PRO W7800 48 GB. La categoría de 32 GB corresponde a la RTX 5090: modelos de 27 mil millones de parámetros con 4 a 6 bits y contexto de 128K a 256K, además de modelos grandes de tipo MoE con descarga de memoria RAM.
128 GB de memoria unificada
Framework Desktop, GMKtec EVO-X2, HP Z2 Mini G1a, ASUS ROG Flow Z13, Mac Studio M5 Max, MacBook Pro M5 Max, NVIDIA DGX Spark, ASUS Ascent GX10, MSI EdgeXpert, Gigabyte AI TOP ATOM, Lenovo ThinkStation PGX, Acer Veriton GN100, HP ZGX Nano G1n, además de cada caja GB10: NVIDIA DGX Spark, ASUS Ascent GX10, Dell Pro Max con GB10, MSI EdgeXpert, Gigabyte AI TOP ATOM, Lenovo ThinkStation PGX, Acer Veriton GN100 y HP ZGX Nano G1n. Todo lo que esté en este grupo puede cargar modelos de la categoría 120B procesados en un Spark; las computadoras Mac y las máquinas AMD Strix Halo los ejecutarán a su propia velocidad.
256 GB o más
Un Mac Studio M5 Ultra con 256 o 512 GB, o dos y cuatro cajas GB10 conectadas mediante ConnectX-7. Esta es la categoría para el modelo DeepSeek-V4.1-Flash de 340 GB y modelos de ese tamaño sin descarga externa.
Elegir una categoría
- Chat, ayuda con programación y transcripción para una sola persona: 16 GB son suficientes, 32 GB son más cómodos y mucho más rápidos.
- Agentes de programación con contexto largo y varios usuarios en una misma máquina: 32 GB en una RTX 5090 con un motor de procesamiento por lotes.
- Modelos de más de 100 mil millones de parámetros sin descarga externa: 128 GB de memoria unificada; prefiera una Mac si la velocidad es importante, o Spark si su entorno utiliza CUDA.
- Los modelos MoE abiertos más grandes a una velocidad utilizable: una Mac Studio de 256 GB, o de dos a cuatro unidades GB10.
- Antes de comprar más memoria, verifique si un motor o método de cuantización mejor en el hardware que ya posee puede cerrar esa brecha. En la misma RTX 5090, solo el cambio en el conjunto de software aumentó la velocidad casi 4 veces.