RTX 5060 Ti 16 GB für lokale KI: Gemessene Geschwindigkeiten von LLMs, Bildern und Sprache.
RTX 5060 Ti 16 GB im Test für lokale KI: Fünf LLMs mit Geschwindigkeiten von 42 bis 116 Token pro Sekunde, Zeiten für den ersten Token bei 32 K, Geschwindigkeiten bei Bildern, Videos, 3D-Inhalten und Sprache sowie Anwendungen, die damit laufen können.
Die 16 GB RTX 5060 Ti ist die Karte, mit der viele Heim-AI-Systeme beginnen: Sie verfügt über ausreichend Video-RAM für Sprachmodelle der 27B-Klasse und kostet im Rahmen eines normalen Desktop-Budgets. Das wirft die offensichtliche Frage auf: Wie schnell ist sie, sobald tatsächlich etwas Nützliches geladen wird? Im Folgenden sind gemessene Werte für fünf Sprachmodell-Konfigurationen, zwei Bildmodelle, ein Video-Modell, ein 3D-Modell und ein Sprachmodell auf einer Karte aufgeführt, sowie welche Veränderungen eintritten, wenn man eine zweite 5060 Ti hinzufügt oder auf eine RTX 5090 upgradet.
Jeder Sprachmodell-Test verwendet dieselben Parameter: Antworten mit 512 Tokenn auf Code- und Prosa-Aufforderungen, zunächst ein Aufwärmphase, anschließend der Median mehrerer wiederholter Tests. Die Verarbeitung der Aufforderungen wird bei 2K, 8K und 32K Tokenn gemessen, und der Kontext-Test belastet jede Konfiguration, bis diese nicht mehr ausreicht.
Fünf Modelle, die in 16 GB passen
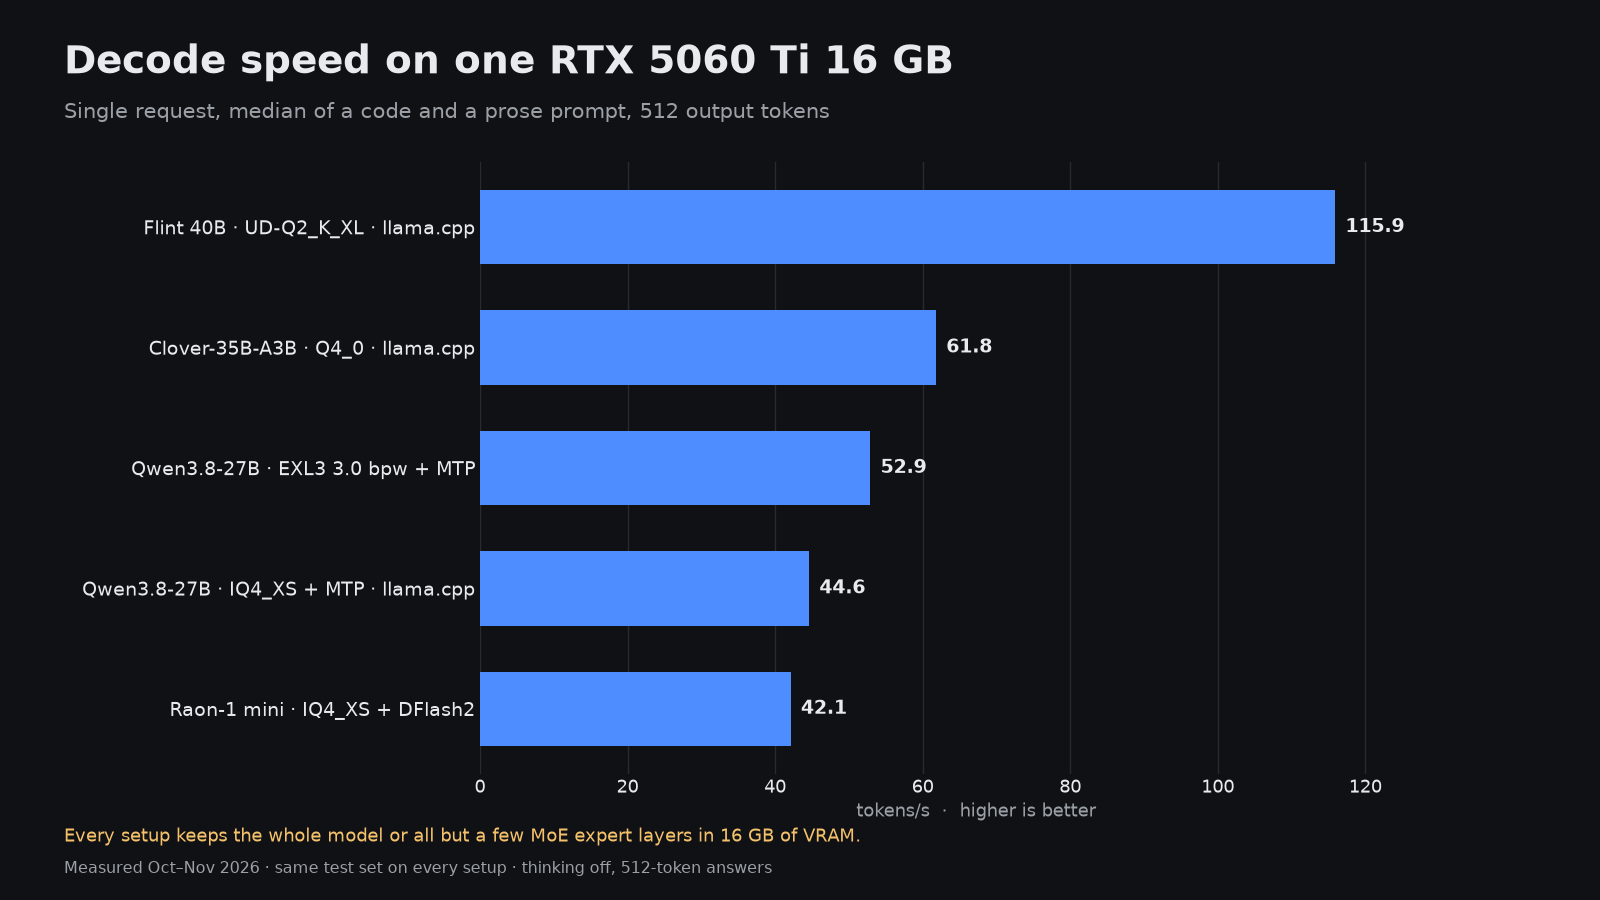
| Modell und Quantisierung | Engine | Dekodierung, Token/Sekunde | Prefill 8K, Token/Sekunde | Erstes Token bei 32K | Größter Kontext | Höchster VRAM-Verbrauch |
|---|---|---|---|---|---|---|
| Flint 40B UD-Q2_K_XL | llama.cpp | 115,9 | 2.364 | 15,6 s | 64K | 14,7 GiB |
| Clover-35B-A3B Preview Q4_0 | llama.cpp, 20 Schichten von Experten im RAM | 61,8 | 992 | 37,4 s | 128K | 14,8 GiB |
Der Unterschied von oben nach unten beträgt fast das Dreifache, und die Rangliste nach reiner Geschwindigkeit ist nicht die, die man für den täglichen Gebrauch benötigt. Nur die Qwen3.8-27B EXL3-Version weist auf dieser Karte eine vollständige Qualitätswertung auf (durchschnittlich 66,1 % bei sieben Tests). Die anderen wurden hinsichtlich Geschwindigkeit und Kontext gemessen, aber noch nicht gerankt.
Flint 40B ist schnell, weil es stark optimiert wurde
Flint 40B erreicht 115,9 Tokel pro Sekunde, wobei die Ergebnisse für Code- und Prose-Aufgaben nur 0,2 Tokel pro Sekunde voneinander abweichen. Dazu wird eine 2-Bit Unsloth-Quantisierung (UD-Q2_K_XL) verwendet, die das gesamte Modell mit 14,7 GiB in der VRAM behält – was Platz für einen Kontext von 64K und nichts weiter lässt. Auf der 5090 erzielte die NVFP4-Version desselben Modells bei den Qualitätstests 38,6 %, was der niedrigste Wert aller durchgeführten Tests mit dieser Karte ist. Betrachten Sie Flint als schnelles Modell für Entwürfe und Chats, aber nicht als geeignetes Tool für die Überprüfung von Code.
Qwen3.8-27B ist die ausgewogene Wahl
Die Qwen3.8-27B EXL3 3.0 bpw-Version aus dem one-click ExLlamaV3-Kit decodiert mit 52,9 Tokel pro Sekunde (53,6 bei Code, 52,1 bei Prose) und passt dennoch 117.760 Token an Kontextinhalt in 15,2 GiB unter. Das ist die stärkste Kombination aus Geschwindigkeit, Kontextmenge und Qualität auf einer 16-GB-Karte in dieser Gruppe.
Der ByteShape IQ4_XS GGUF desselben Modells bietet einen nützlichen Vergleich. Er behält mehr Bits pro Gewicht (3,84 bpw) bei, sodass er durch Quantisierung weniger verliert, doch seine Dekodiergeschwindigkeit liegt bei 44,6 Tok/S. Seine MTP-Vorlagen werden zu 49,3 % der Zeit akzeptiert, und die Kontextgrenze sinkt bei 15,4 GiB auf 43.008 Token. Wenn Sie hauptsächlich mit langen Dateien oder Agentensitzungen arbeiten, ist der zusätzliche Kontext der EXL3-Version wichtiger als die zusätzlichen Bits.
Wie lange es dauert, bis der erste Token erzeugt wird
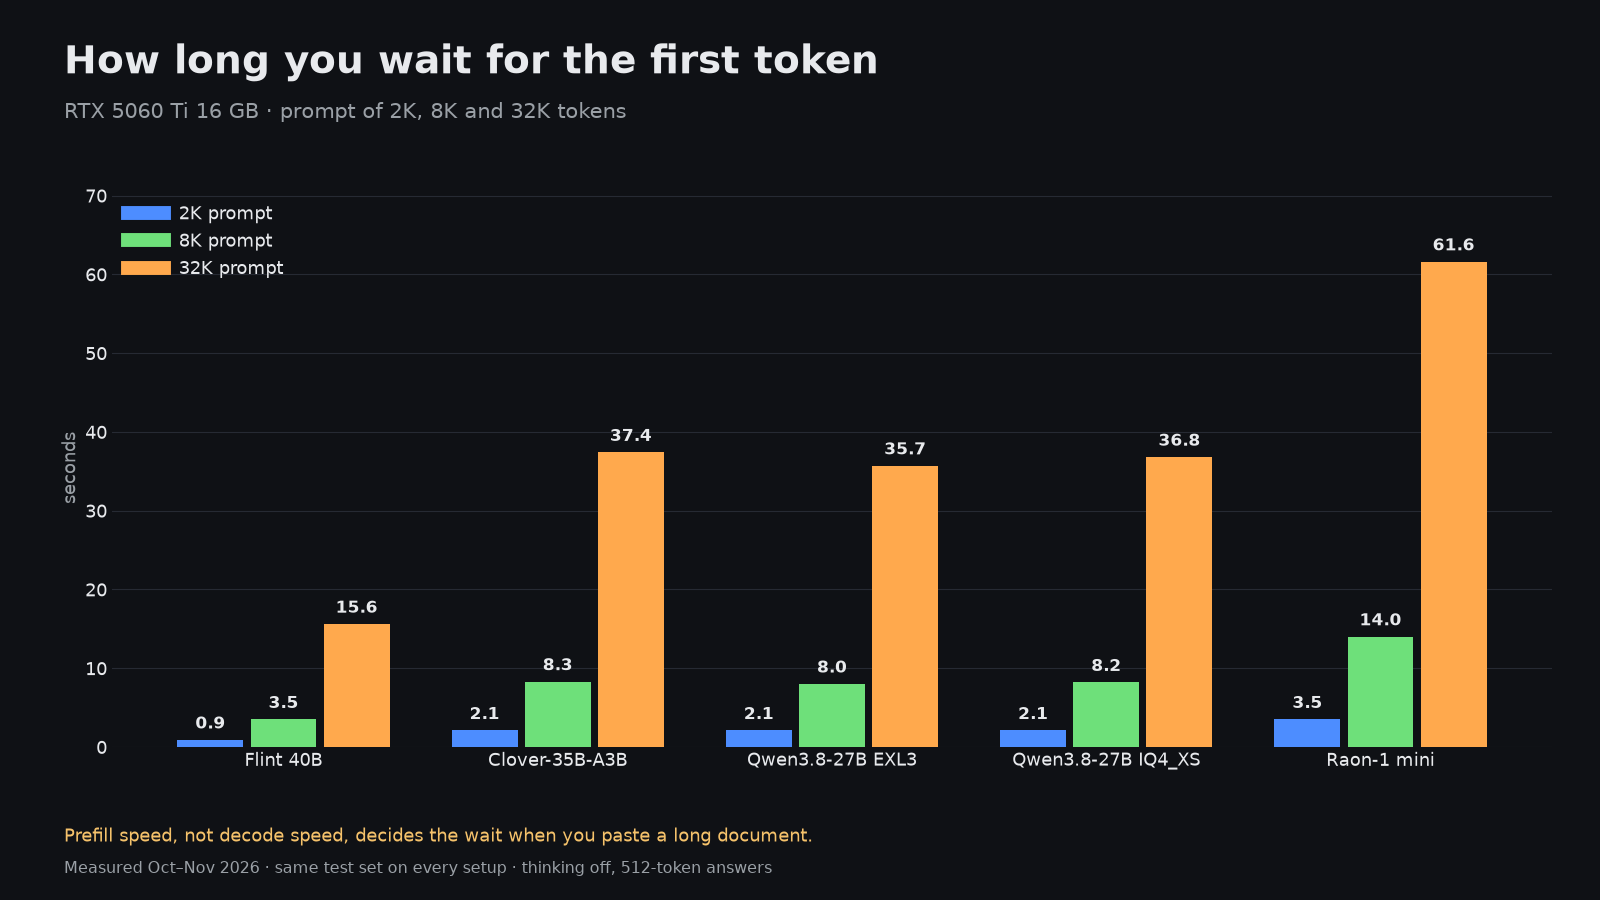
Die Dekodiergeschwindigkeit ist das, worauf sich Benchmarks konzentrieren, doch bei einer 16-GB-Karte ist die Wartezeit, bis eine Antwort erscheint, oft das größere Problem. Ein Prompt mit 32.000 Token – das etwa einer mittelgroßen Codebasis entspricht – benötigt 15,6 Sekunden auf Flint, 35,7 Sekunden auf Qwen3.8-27B und 61,6 Sekunden auf Raon-1 mini. Die Vorausbefüllung mit diesem Chip erfolgt bei einem dichten 27B-Modell mit etwa 1.027 Token pro Sekunde, sodass jedes zusätzliche 10.000 Token an Kontext etwa zehn Sekunden zusätzliche Wartezeit bedeuten.
Falls Ihre Arbeitslast aus kurzen Prompts für Chats besteht, ist die Dekodiergeschwindigkeit entscheidend. Bei RAG, Programmieragenten oder langen Dokumenten sollten Sie zunächst die Zeit für die Vorausbefüllung und die Zeit bis zum ersten Token vergleichen.
MoE-Modelle mit Experten im System-RAM
Mix-Modellien mit Experten sind die Hauptmethode, um Aufgaben zu verarbeiten, die normalerweise mehr als 16 GB Speicher erfordern würden. llama.cpp kann mithilfe von --n-cpu-moe die Gewichte der Experten in den ersten Schichten im System-RAM speichern, während die GPU den Rest übernimmt. Die Clover-35B-A3B Preview in Version Q4_0 mit 20 Expertenschichten im RAM erreicht eine Geschwindigkeit von 61,8 Tok/S, kann einen Kontextumfang von 128 K verarbeiten und nutzt auf einem Rechner mit 32 GB System-RAM maximal 14,8 GiB VRAM. Zudem skaliert die Leistung mit parallelen Anfragen: Die Gesamtleistung steigt von 46,1 Tok/S bei einer Anfrage auf 72,3 Tok/S bei vier Anfragen.
Die Raon-1 mini Preview zeigt die Folgen, wenn dieser Ansatz zu weit getrieben wird. Mit 9 Expertenschichten im RAM erreicht sie eine Dekodiergeschwindigkeit von 42,1 Tok/S, akzeptiert nur 17,7 % der von DFlash2 erzeugten Entwürfe, kann einen Kontextumfang von 16 K verarbeiten und erzielt im Durchschnitt 45,1 % bei den Qualitätstests. Das Auslagern funktioniert zwar, stellt aber einen Kompromiss dar und ist keine kostenlose Kapazitätssteigerung.
Eine Karte, zwei Karten oder eine RTX 5090
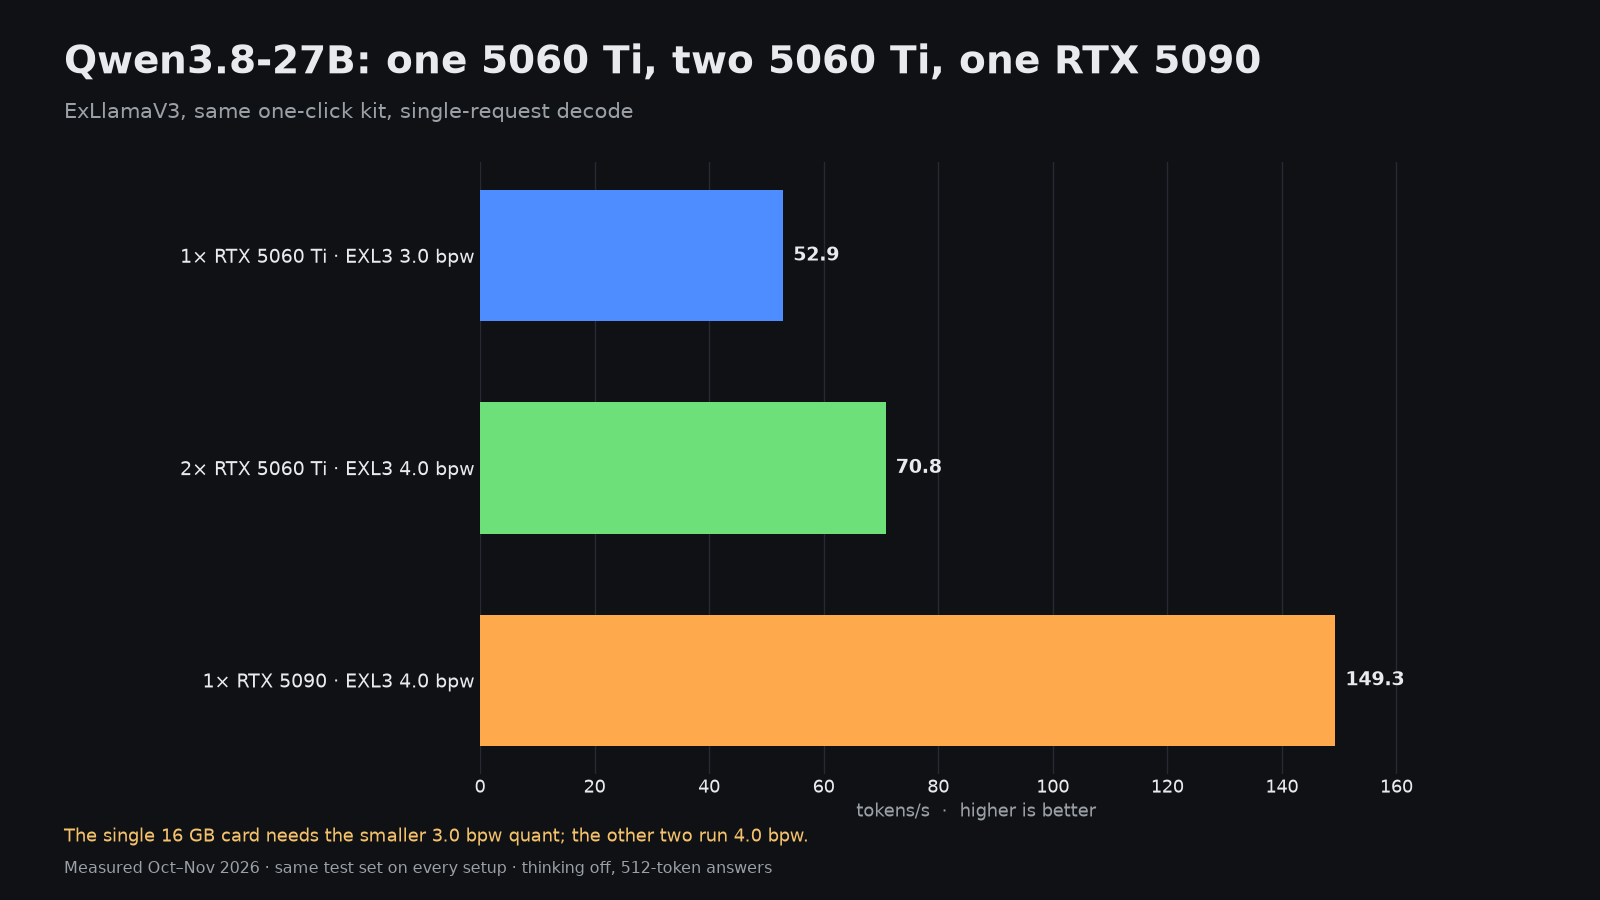
Ein weiterer 5060 Ti mit Tensor-Parallelismus steigert die Geschwindigkeit von Qwen3.8-27B auf 70,8 Tokel pro Sekunde und ermöglicht es zudem, auf die 4,0 bpw EXL3-Quantisierung mit einem 256K-Kontextumfang bei 22,4 GiB auf beiden Karten umzusteigen. Die durchschnittliche Qualität steigt dadurch auf 67,2 %. Das ist eine echte Verbesserung, doch die Geschwindigkeit ist nur etwa 34 % höher, nicht doppelt so hoch.
Die RTX 5090 arbeitet mit derselben 4,0 bpw-Konfiguration und erreicht 149,3 tok/s – das sind etwa 2,8× so viel wie eine einzelne 5060 Ti und 2,1× so viel wie zwei davon. Die Vorausbelegung bei 8K steigt von 1.027 auf 3.484 tok/s. Wenn Geschwindigkeit das Ziel ist, ist eine größere Karte besser als zwei kleinere; wenn man bereits eine 5060 Ti besitzt, bringt die zweite Karte bessere Leistung bei der Verarbeitung von Kontexten sowie eine höhere Quantisierung.
Bilder, Video, 3D und Sprache auf derselben Karte
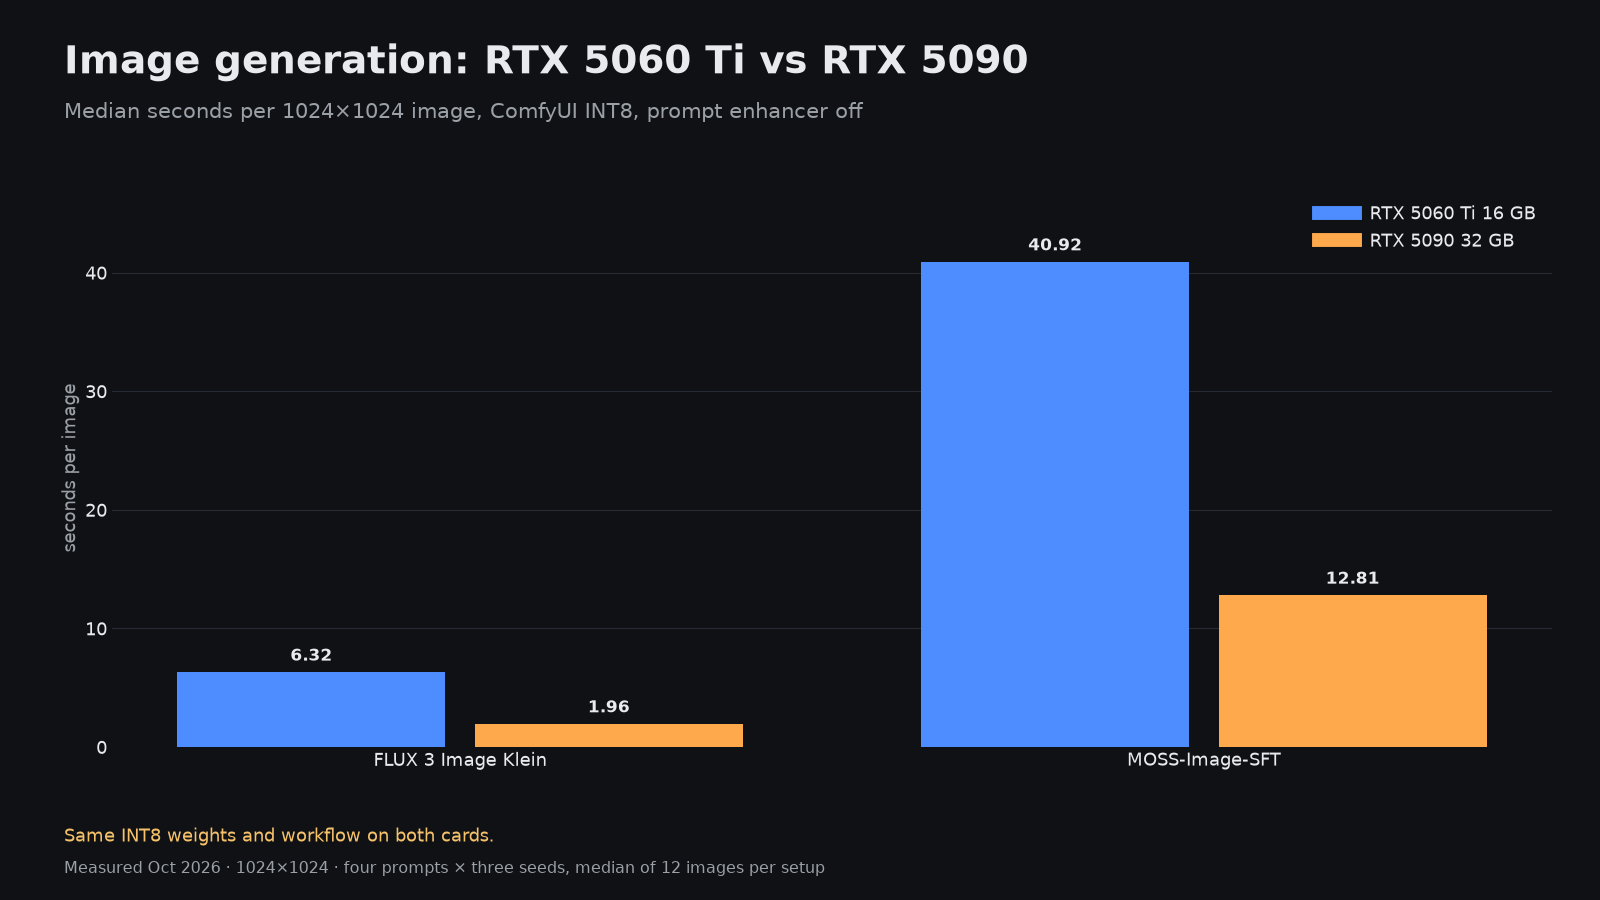
| Aufgabe | RTX 5060 Ti 16 GB | RTX 5090 32 GB |
|---|---|---|
| FLUX Klein-Bild | 6,32 s | 1,96 s |
| MOSS-Bild | 40,92 s | 12,81 s |
| Idol 3D-Modell, ein Bild zur Mesh-Generierung | 57,4 s | 14,5 s |
| HyperFlow H3 Flash, 5-sekündiger Clip mit Ton, GGUF Q4_K_M | 562,2 s | 107,1 s |
Bilder und 3D-Inhalte sind auf 16 GB vollständig nutzbar: Ein FLUX Klein-Bild in etwa sechs Sekunden eignet sich gut für Iterationen. Bei Videos kommt die Karte an ihre Grenzen. Ein 5-sekündiger HyperFlow H3 Flash-Clip in 1344×768 benötigt 562,2 s, also etwas über neun Minuten, während die 5090 mit dem gleichen Q4_K_M-File 107,1 s benötigt und die INT8-Version, die eine größere Karte erfordert, 86,8 s braucht.
Die Spracherkennung ist überraschend gut. Nemotron 3.5 Transcribe verarbeitet 59 Minuten und 39 Sekunden sauberen Testaudio von LibriSpeech in 120 Sekunden auf der 5060 Ti – das entspricht 29,8-fach der Echtzeit – mit einem Wortfehleranteil von 1,54 %. Für die Transkription reichen 16 GB mehr als aus.
Was man kaufen und was man nutzen sollte
- Für eine einzelne 16-GB-Karte eignet sich Qwen3.8-27B EXL3 3.0 bpw in ExLlamaV3: 52,9 Tokel pro Sekunde, etwa 115.000 Kontexteinträge sowie eine gute Qualitätsbewertung.
- Nutzen Sie Flint 40B für schnelles Chatten und Erstellen von Entwürfen mit 115,9 Tokel pro Sekunde und behalten Sie ein leistungsstärkeres Modell für Aufgaben, bei denen Genauigkeit wichtig ist.
- Probieren Sie Clover-35B-A3B mit Experten in RAM aus, wenn Sie 128.000 Kontexteinträge benötigen und über mindestens 32 GB System-RAM verfügen.
- Bereiten Sie sich auf langsame ersten Token bei langen Anfragen vor. Halten Sie die RAG-Blöcke sowie den Agentenkontext auf dieser Karte gering.
- Bilder, 3D-Inhalte sowie Transkriptionen werden problemlos verarbeitet. Die Videoerstellung funktioniert, ist aber aufgrund von etwa neun Minuten pro 5-Sekunden-Clip eher für Batch-Aufgaben geeignet.
- Falls Sie heute Hardware auswählen und Geschwindigkeit wichtig ist, stellt die RTX 5090 einen deutlich größeren Fortschritt gegenüber einer weiteren RTX 5060 Ti dar.
Wie die Werte ermittelt wurden
Sämtliche Tests mit 16 GB Arbeitsspeicher werden unter Linux mit einer RTX 5060 Ti 16 GB durchgeführt; der dokumentierte Host ist ein Core i7-12700K mit 32 GB RAM. Die Geschwindigkeit des Sprachmodells ergibt sich aus dem Median mehrerer wiederholter Antworten mit 512 Token nach dem Aufwärmen, die Vorausbefüllung wird an festeren Prompts in den Größen 2K, 8K und 32K gemessen, und die Kontextgrenze entspricht dem größten Prompt, der geladen und beantwortet werden kann. Die Qualität wird durch den Mittelwert von sieben identisch durchgeführten Tests auf jeder getesteten Konfiguration ermittelt. Die Zeiten für Bilder und Videos sind der mittlere Wert vom Anfordern bis zur Erstellung des fertigen Dateis.