RTX 5060 Ti 16 GB para IA local: velocidades medidas de LLM, imágenes y voz.
RTX 5060 Ti 16 GB probado para IA local: cinco LLM con velocidades de 42 a 116 tok/s, tiempos de primer token en 32K, velocidades en imágenes, video, 3D y voz, y qué se puede ejecutar con él.
La RTX 5060 Ti de 16 GB es la tarjeta con la que comienzan muchas implementaciones de IA en el hogar: cuenta con suficiente memoria de video para un modelo de lenguaje de 27 mil millones de parámetros, y su precio se ajusta al presupuesto habitual de un ordenador de escritorio. Esto plantea la pregunta obvia: ¿qué velocidad tiene una vez que se carga algo realmente útil? A continuación se presentan los valores medidos para cinco configuraciones de modelos de lenguaje, dos modelos de imágenes, un modelo de video, un modelo 3D y un modelo de voz en una sola tarjeta, además de los cambios que ocurren al añadir una segunda RTX 5060 Ti o al pasar a una RTX 5090.
Cada ejecución de un modelo de lenguaje utiliza los mismos parámetros: respuestas de 512 tokens ante un prompt de código y uno de prosa, un período de calentamiento inicial, el valor mediano de ejecuciones repetidas, y tiempo de procesamiento adicional. El procesamiento de los prompts se mide con 2K, 8K y 32K tokens, mientras que la prueba de contexto somete cada configuración hasta que ya no puede procesar más información.
Cinco modelos que caben en 16 GB
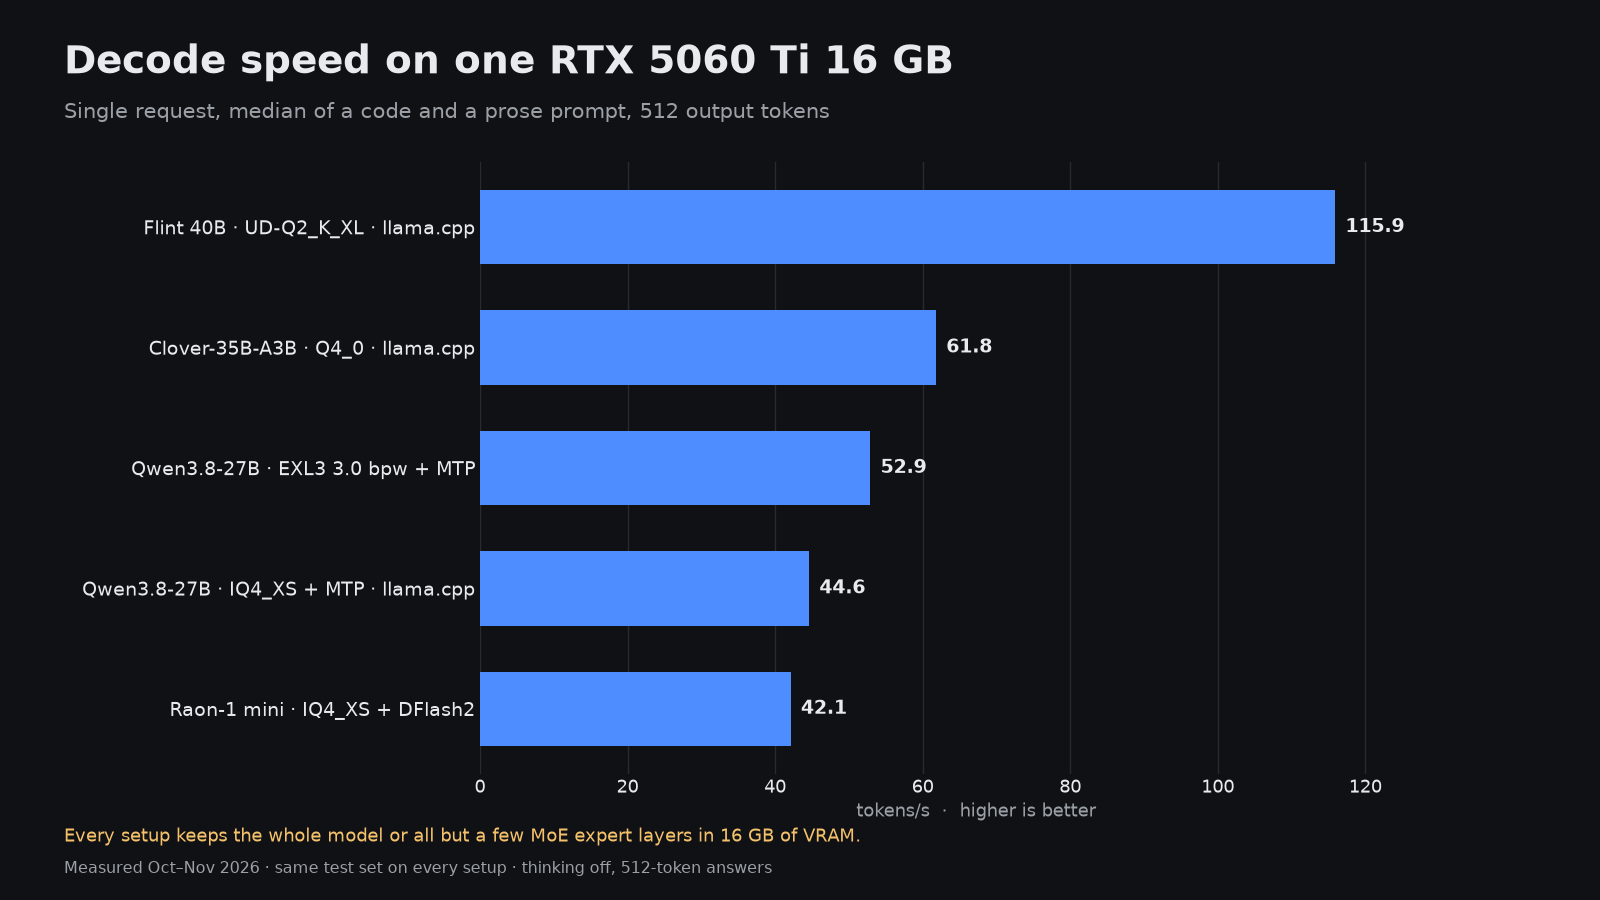
| Modelo y cuantificación | Motor | Decodificación, tok/s | Relleno previo 8K, tok/s | Primer token a 32K | Contexto más grande | VRAM máxima |
|---|---|---|---|---|---|---|
| Flint 40B UD-Q2_K_XL | llama.cpp | 115.9 | 2,364 | 15.6 s | 64K | 14.7 GiB |
| Clover-35B-A3B Preview Q4_0 | llama.cpp, 20 capas de expertos en RAM | 61.8 | 992 | 37.4 s | 128K | 14.8 GiB |
| Qwen3.8-27B EXL3 3.0 bpw | ExLlamaV3 con MTP | 52.9 | 1,027 | 35.7 s | 117,760 | 15.2 GiB |
| Qwen3.8-27B ByteShape IQ4_XS | llama.cpp con MTP | 44.6 | 998 | 36.8 s | 43,008 | 15.4 GiB |
| Raon-1 mini preview IQ4_XS | llama.cpp, 9 capas de expertos en RAM | 42.1 | 586 | 61.6 s | 16K | 12.9 GiB |
La diferencia es de casi 3 veces de arriba hacia abajo, y la clasificación por velocidad bruta no es la que se desea para el uso diario. Solo la versión Qwen3.8-27B EXL3 tiene una puntuación de calidad completa en esta prueba (66.1 % promedio en siete pruebas). Las demás se midieron en términos de velocidad y contexto, pero aún no están clasificadas.
Flint 40B es rápido porque se optimiza al máximo
Flint 40B alcanza 115.9 tok/s, con los prompts de código y prosa a 0.2 tok/s de diferencia entre sí. Lo logra gracias a una cuantización Unsloth de 2 bits (UD-Q2_K_XL) que mantiene todo el modelo en VRAM ocupando 14.7 GiB, lo que deja espacio solo para un contexto de 64K y nada más. En la tarjeta 5090, la versión NVFP4 del mismo modelo obtuvo un 38.6 % en las pruebas de calidad, el porcentaje más bajo entre todas las pruebas realizadas con esa tarjeta. Considere a Flint como un modelo rápido para bocetos y chats, pero no como el adecuado para revisar código.
Qwen3.8-27B es la opción equilibrada
La versión Qwen3.8-27B EXL3 3.0 bpw del kit ExLlamaV3 de un solo clic decodifica a 52.9 tok/s (53.6 con código y 52.1 con prosa), y aún así puede manejar 117,760 tokens de contexto ocupando 15.2 GiB. Es la combinación más sólida de velocidad, capacidad de contexto y calidad medida en una tarjeta de 16 GB de este conjunto.
El ByteShape IQ4_XS GGUF del mismo modelo constituye un buen punto de comparación. Mantiene más bits por peso (3,84 bpw), por lo que debería perder menos al ser cuantificado, pero se decodifica a 44,6 tok/s; sus borradores MTP son aceptados en el 49,3 % de los casos, y el límite de contexto disminuye a 43,008 tokens con 15,4 GiB. Si trabajas principalmente con archivos largos o sesiones de agentes, el contexto adicional de la versión EXL3 es más importante que los bits adicionales.
Tiempo que tarda en aparecer el primer token
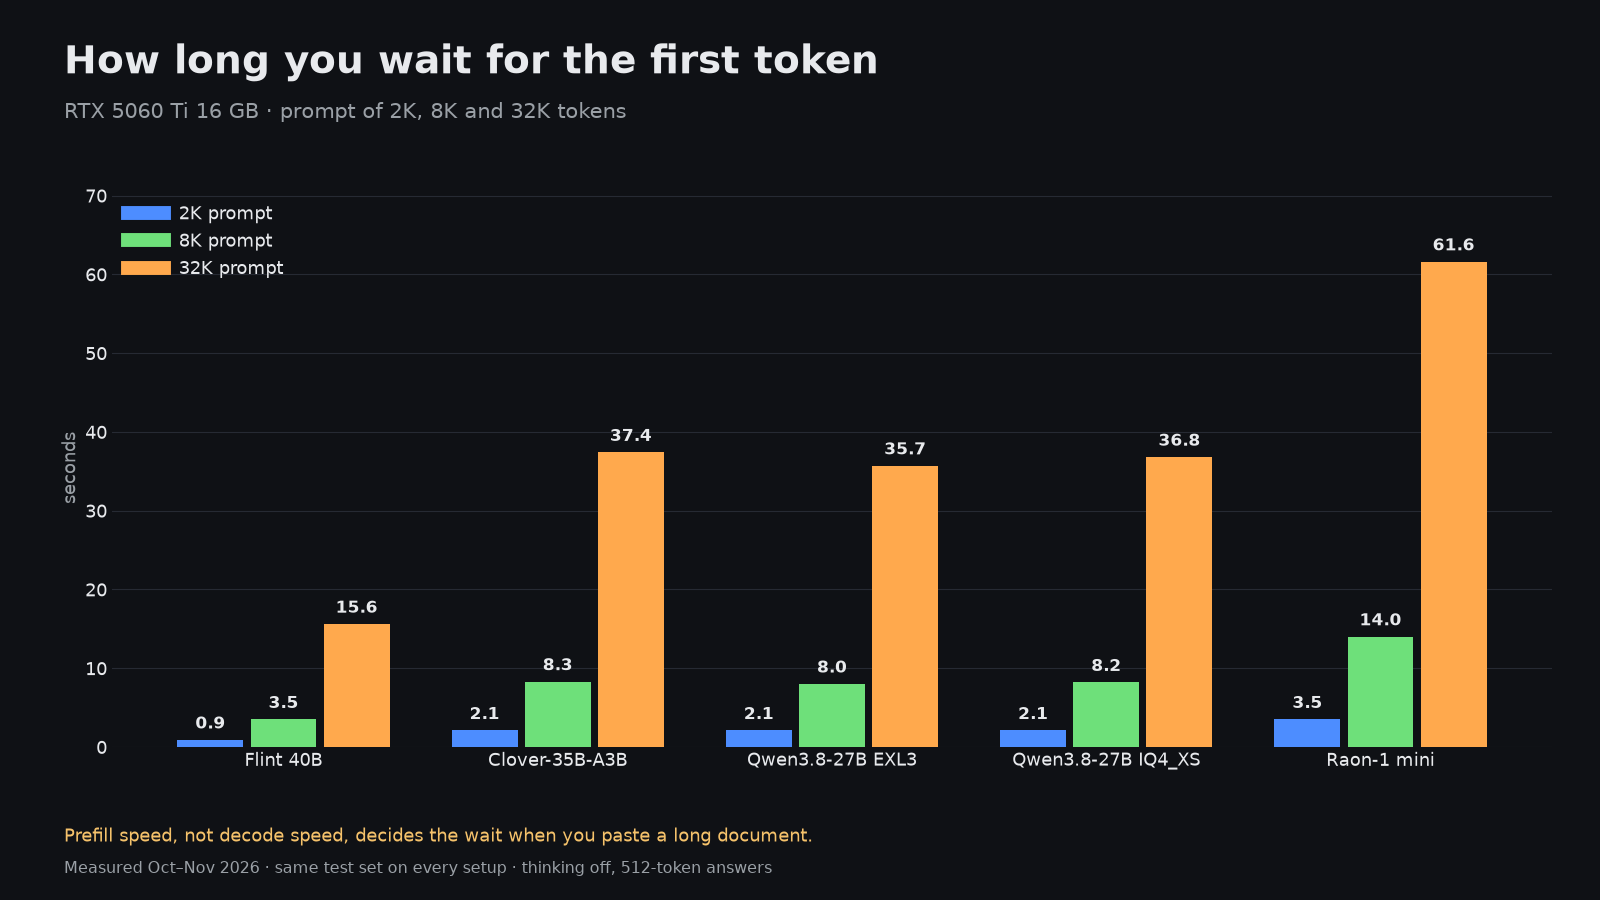
La velocidad de decodificación es lo que suelen destacar las pruebas de rendimiento, pero en una tarjeta de 16 GB, el tiempo de espera antes de que aparezca la respuesta suele ser el problema más grave. Una solicitud de 32K tokens, aproximadamente el tamaño de un conjunto de archivos de código de tamaño medio, tarda 15.6 s en Flint, 35.7 s en Qwen3.8-27B y 61.6 s en Raon-1 mini. La carga previa en esta tarjeta se realiza a una velocidad de unos 1,027 tokens/segundo para un modelo denso de 27B, por lo que cada 10K tokens adicionales de contexto añaden unos diez segundos antes de que aparezca la primera palabra.
Si su trabajo consiste en chats con solicitudes cortas, la velocidad de decodificación es el parámetro importante. Si se trata de RAG, agentes de programación o documentos largos, primero compare el tiempo de carga previa y el tiempo necesario para generar el primer token.
Modelos MoE con expertos en la RAM del sistema
Los modelos de mezcla de expertos son la forma principal de ejecutar modelos más grandes de los que normalmente permitirían 16 GB. llama.cpp puede mantener los pesos de los expertos de las primeras capas en la RAM del sistema con --n-cpu-moe, mientras que la GPU se encarga del resto. La versión de prueba de Clover-35B-A3B en Q4_0, con 20 capas de expertos en RAM, funciona a 61.8 tok/s, alcanza un contexto de 128K y llega a un máximo de 14.8 GiB de VRAM en una máquina con 32 GB de RAM del sistema. También escala con solicitudes paralelas: el rendimiento total aumenta de 46.1 tok/s por solicitud a 72.3 tok/s por cuatro solicitudes.
La versión de prueba de Raon-1 mini muestra el costo de aplicar este mismo truco cuando se excede su límite. Con 9 capas de expertos en RAM, decodifica a 42.1 tok/s, solo acepta el 17.7 % de sus borradores DFlash2, alcanza un máximo de 16K en el contexto y obtiene un promedio del 45.1 % en las pruebas de calidad. La descarga de tareas a otra unidad funciona, pero se trata de un compromiso, no de capacidad adicional gratuita.
Una tarjeta, dos tarjetas o una RTX 5090
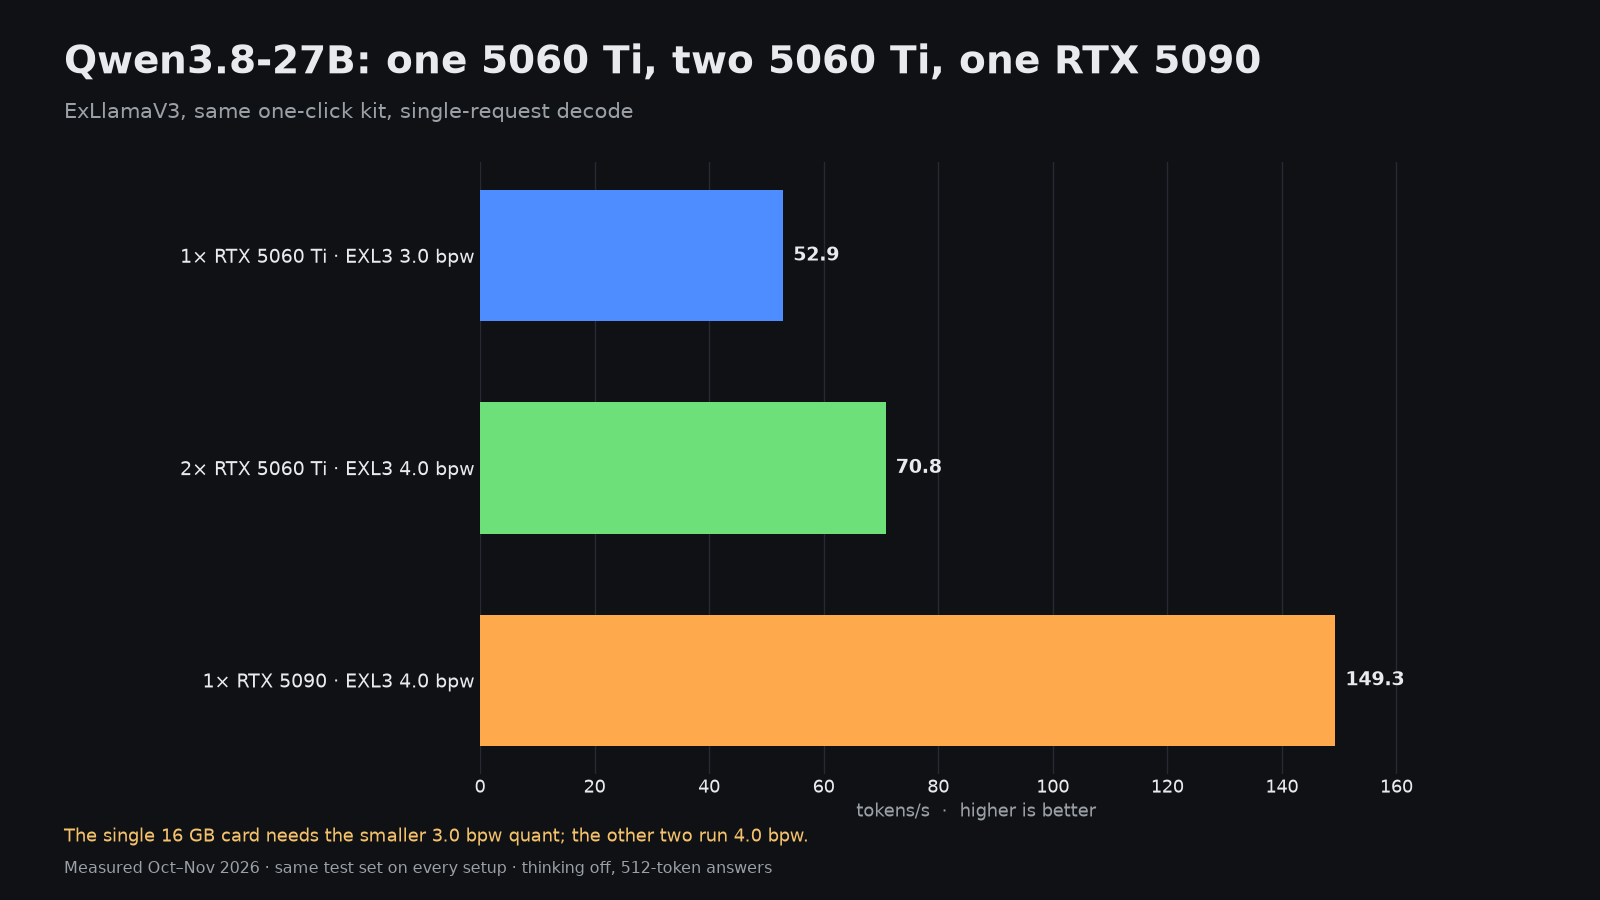
Otra RTX 5060 Ti con paralelismo tensorial eleva la velocidad de Qwen3.8-27B a 70.8 tok/s y, lo que es más importante, permite utilizar la cuantización EXL3 de 4.0 bpw con un contexto de 256K, ocupando 22.4 GiB en ambas tarjetas. El promedio de calidad aumenta al 67.2 %. Se trata de una verdadera mejora, pero solo es aproximadamente un 34 % más rápido, no el doble.
La RTX 5090 utiliza la misma configuración de 4.0 bpw y alcanza 149.3 tok/s, lo que representa aproximadamente 2.8 veces la velocidad de una sola 5060 Ti y 2.1 veces la de dos unidades juntas. La velocidad de carga previa a 8K pasa de 1,027 a 3,484 tok/s. Si lo que se busca es la velocidad, una tarjeta más grande es mejor que dos pequeñas; si ya posees una 5060 Ti, la segunda tarjeta te brinda mayor capacidad de contexto y una cuantización mejor.
Imágenes, video, 3D y voz en la misma tarjeta
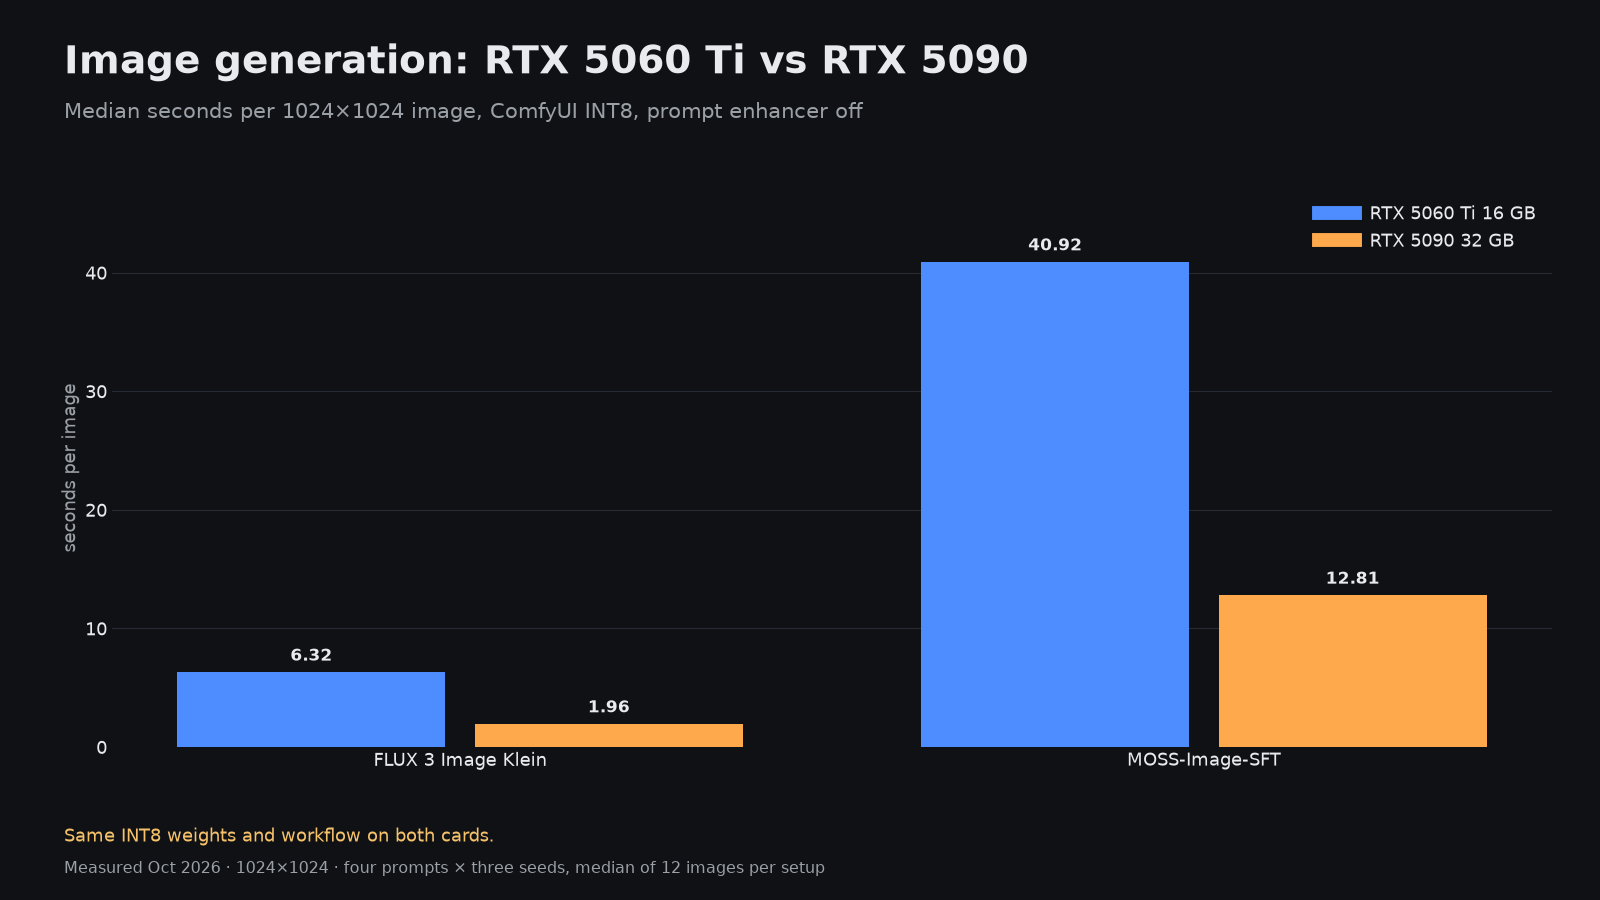
| Tarea | RTX 5060 Ti 16 GB | RTX 5090 32 GB |
|---|---|---|
| Imagen FLUX Klein | 6.32 s | 1.96 s |
| Imagen MOSS | 40.92 s | 12.81 s |
| Modelo 3D de Idol, una imagen para generar malla | 57.4 s | 14.5 s |
| HyperFlow H3 Flash, clip de 5 segundos con sonido, GGUF Q4_K_M | 562.2 s | 107.1 s |
Las imágenes y el contenido 3D son completamente utilizables con 16 GB: una imagen FLUX Klein en unos seis segundos es suficiente para iteraciones. El video es donde la tarjeta se queda sin recursos. Un clip de 5 segundos de HyperFlow H3 Flash a 1344×768 tarda 562.2 s, un poco más de nueve minutos, frente a los 107.1 s de la 5090 con el mismo archivo Q4_K_M y los 86.8 s de la versión INT8 que requiere una tarjeta más potente.
El reconocimiento de voz es sorprendente. Nemotron 3.5 Transcribe procesa 59 minutos y 39 segundos de audio limpio de prueba LibriSpeech en 120 segundos con la tarjeta 5060 Ti, a 29.8× la velocidad en tiempo real, con una tasa de error de palabras del 1.54 %. Para la transcripción, 16 GB son más que suficientes.
Qué comprar y qué ejecutar
- Para una sola tarjeta de 16 GB, comience con Qwen3.8-27B EXL3 3.0 bpw en ExLlamaV3: 52.9 tok/s, aproximadamente 115K de contexto, con calidad evaluada.
- Use Flint 40B para chats rápidos y redacción a 115.9 tok/s, y mantenga un modelo más potente para tareas donde es necesario tener precisión.
- Pruebe Clover-35B-A3B con memoria RAM adicional cuando necesite 128K de contexto y tenga al menos 32 GB de RAM en el sistema.
- Tenga en cuenta que los primeros tokens serán lentos con prompts largos. Mantenga los fragmentos RAG y el contexto del agente reducidos con esta tarjeta.
- Las imágenes, el 3D y la transcripción funcionan sin problemas. La generación de video sí funciona, pero con aproximadamente nueve minutos por clip de 5 segundos, se trata de un proceso por lotes.
- Si hoy está eligiendo hardware y la velocidad es importante, una RTX 5090 representa un salto mucho mayor que otra RTX 5060 Ti.
Cómo se obtuvieron las cifras
Todas las pruebas con 16 GB utilizan una RTX 5060 Ti de 16 GB bajo Linux; el equipo utilizado en los registros es un Core i7-12700K con 32 GB de RAM. La velocidad del modelo de lenguaje corresponde a la mediana de respuestas repetidas de 512 tokens después de un período de calentamiento; la carga previa se mide con prompts fijos de 2K, 8K y 32K, y el límite de contexto es el prompt más largo que se puede cargar y procesar. La calidad se calcula como el promedio de siete pruebas realizadas de manera idéntica en cada configuración evaluada. Los tiempos para imágenes y videos son las medias obtenidas desde la solicitud hasta que se genera el archivo final.