RTX 5060 Ti 16 GB для локального ШІ: виміряні швидкості обробки моделей LLM, зображень та аудіо.
RTX 5060 Ti 16 GB, протестований для локального ШІ: п’ять моделей LLM зі швидкістю обробки від 42 до 116 токенів/с, час обробки першого токену при обсязі 32K, швидкість обробки зображень, відео, 3D-даних та аудіо, а також те, що можна на ньому запускати.
Карта 16 GB RTX 5060 Ti є основою для багатьох домашніх систем штучного інтелекту: у неї достатньо видеопам’яті для мовних моделей класу 27 мільярдів параметрів, а ціна вписується у звичайний бюджет на настільний комп’ютер. Це піднімає очевидне питання: наскільки швидко вона працює після завантаження чогось корисного? Нижче наведені результати тестів для п’яти мовних моделей, двох моделей обробки зображень, однієї відеомоделі, однієї 3D-моделі та однієї моделі обробки мовлення на одній карті, а також зміни, які відбуваються при додаванні другої карти 5060 Ti чи переході на RTX 5090.
При кожній роботі з мовною моделлю використовується один і той самий набір параметрів: відповіді довжиною 512 токенів на кодові та прозові запити, спочатку етап підготовки, медіана результатів кількох повторних запусків. Обробка запитів тестується при обсязі 2K, 8K та 32K токенів, а тест контексту змушує кожну систему працювати до межі її можливостей.
П’ять моделей, які вміщуються у 16 GB
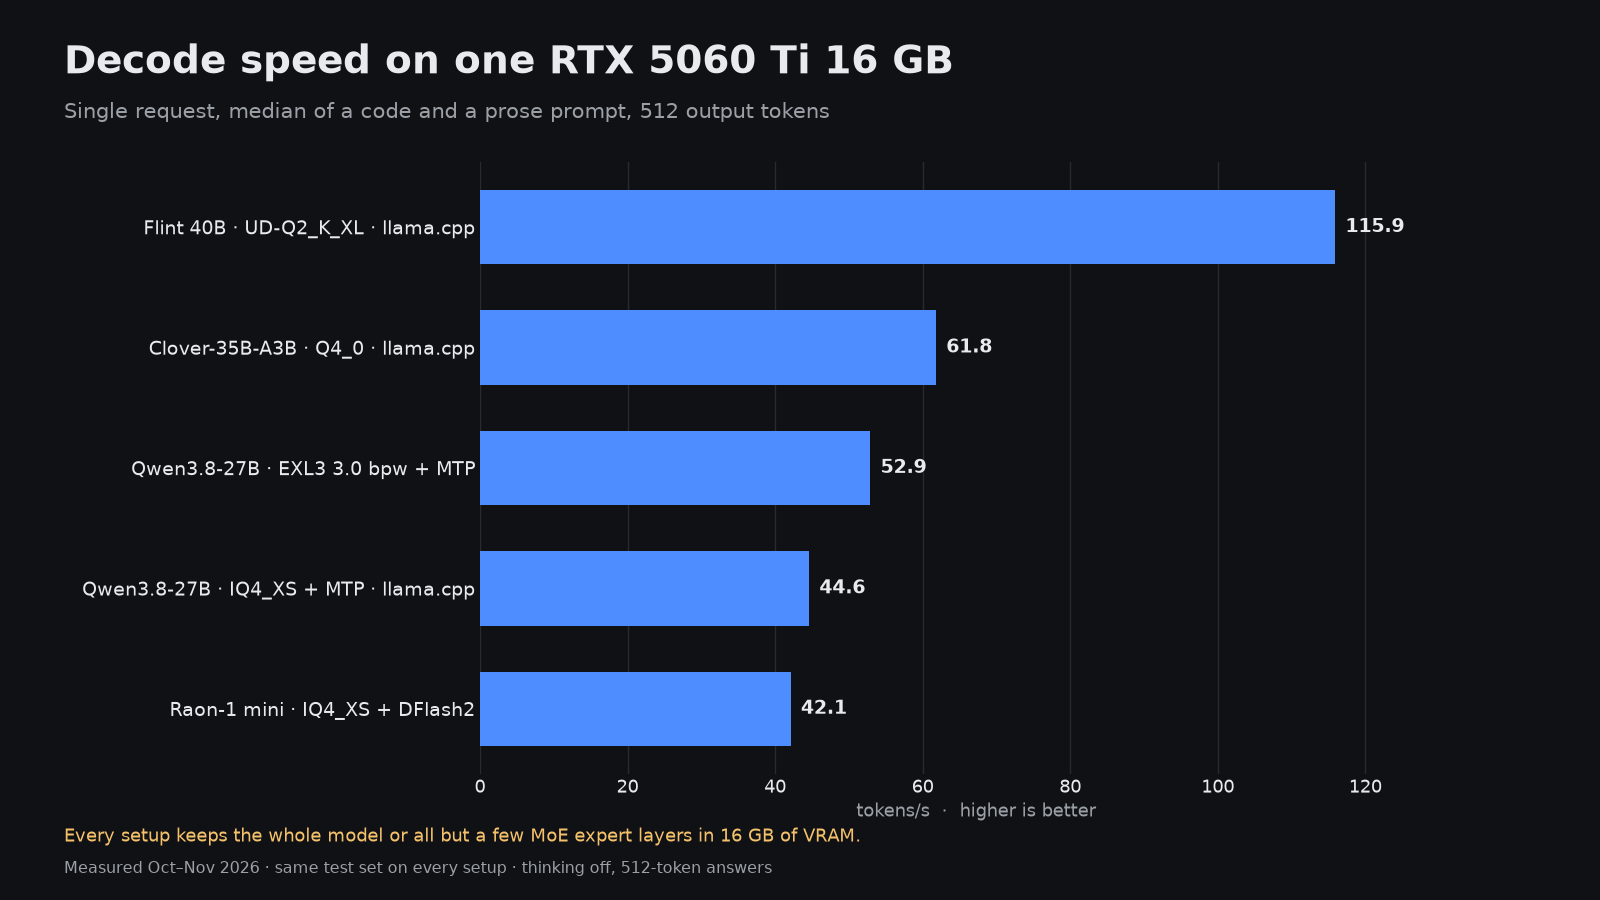
| Модель та формат квантування | Движок | Швидкість декодування, токенів/с | Швидкість заповнення пам’яті 8K, токенів/с | Час отримання першого токену при 32K | Максимальний обсяг контексту | Максимальна кількість VRAM |
|---|---|---|---|---|---|---|
| Flint 40B UD-Q2_K_XL | llama.cpp | 115,9 | 2 364 | 15,6 с | 64K | 14,7 GiB |
| Clover-35B-A3B Preview Q4_0 | llama.cpp, 20 шарів експертів у RAM | 61,8 | 992 | 37,4 с | 128K | 14,8 GiB |
| Qwen3.8-27B EXL3 3.0 bpw | ExLlamaV3 з MTP | 52.9 | 1,027 | 35.7 с | 117,760 | 15.2 ГіБ |
| Qwen3.8-27B ByteShape IQ4_XS | llama.cpp з MTP | 44.6 | 998 | 36.8 с | 43,008 | 15.4 ГіБ |
| Raon-1 mini preview IQ4_XS | llama.cpp, 9 шарів експертів у RAM | 42.1 | 586 | 61.6 с | 16K | 12.9 ГіБ |
Різниця між найкращим та найгіршим результатом становить майже 3 рази, а ранжування за чистою швидкістю не є оптимальним для щоденного використання. Лише версія Qwen3.8-27B EXL3 має повну оцінку якості на цій картці (66.1 % у середньому за сім тестів). Інші моделі були протестовані за швидкістю та здатністю обробки контексту, але ще не ранжовані.
Flint 40B є швидким через інтенсивну оптимізацію
Flint 40B досягає швидкості обробки 115,9 ток/с, причому час обробки коду та прози відрізняється на 0,2 ток/с. Це досягається за допомогою 2-бітного квантування Unsloth (UD-Q2_K_XL), яке дозволяє зберігати весь модель у VRAM об’ємом 14,7 ГБ, що залишає місце лише для контексту обсягом 64 КБ. На карті 5090 версія моделі з підтримкою NVFP4 набрала 38,6% у тестах якості, що є найнижчим показником серед усіх тестів на цій карті. Вважайте Flint швидким моделлю для створення чернеток та чатування, а не тією, якій можна довіряти з перевіркою коду.
Qwen3.8-27B — збалансований вибір
Версія Qwen3.8-27B EXL3 3.0 bpw з набору ExLlamaV3 одним кліком декодує текст зі швидкістю 52,9 ток/с (53,6 для коду та 52,1 для прози) та все ще може обробляти контекст обсягом 117 760 токенів у об’ємі 15,2 ГБ. Це найкраще поєднання швидкості, обсягу контексту та якості серед усіх моделей у цьому наборі на карті об’ємом 16 ГБ.
ByteShape IQ4_XS GGUF того ж моделювання є корисним контрастом. Він зберігає більше бітів на одну вагу (3,84 bpw), тому має менше втрат під час квантування, але декодується зі швидкістю 44,6 токенів/секунду; його проєкти у форматі MTP приймаються у 49,3% випадків, а ліміт контексту знижується до 43 008 токенів при об’ємі 15,4 ГБ. Якщо ви переважно працюєте з довгими файлами чи сеансами агентів, додатковий контекст версії EXL3 має більше значення, ніж додаткові біти.
Скільки часу займає перший токен
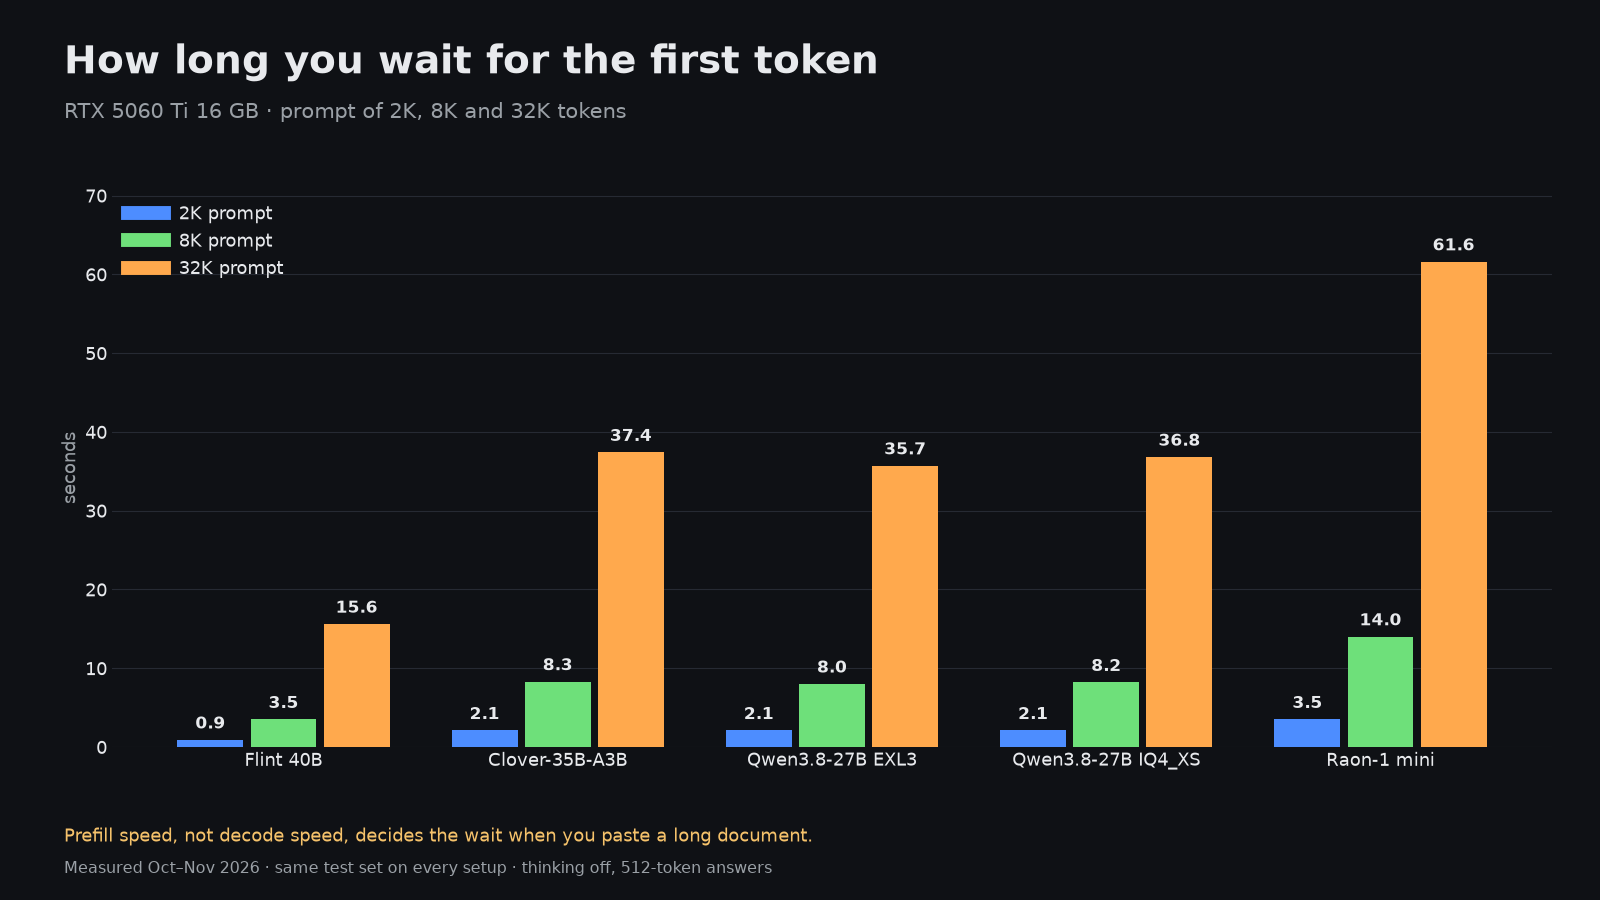
Швидкість декодування — це те, на що звертають увагу у тестах продуктивності, але на карті об’ємом 16 ГБ часто більшою проблемою є час очікування перед отриманням результату. Запит на 32K токенів, що приблизно відповідає невеликому файлу коду, займає 15,6 секунди на Flint, 35,7 секунди на Qwen3.8-27B та 61,6 секунди на Raon-1 mini. Швидкість попереднього заповнення на цій карті становить близько 1 027 токенів/секунду для щільної моделі об’ємом 27 мільярдів параметрів, тож кожні додаткові 10K токенів контексту збільшують час очікування перед першим словом приблизно на десять секунд.
Якщо ваша робота полягає у чаті з короткими запитами, то важливою є швидкість декодування. Якщо ж йдеться про RAG, агентів для програмування чи довгі документи, спочатку порівняйте час попереднього заповнення та час отримання першого токена.
Моделі MoE з експертами в оперативній пам’яті системи
Моделі зі змішуванням експертів є основним способом обробки даних об’ємом, більшим, ніж той, який зазвичай дозволяють 16 ГБ пам’яті. llama.cpp може зберігати ваги експертів перших шарів у оперативній пам’яті системи за допомогою параметра --n-cpu-moe, а решту обробляє GPU. Прев’ю Clover-35B-A3B Preview версії Q4_0 із 20 шарами експертів у RAM працює зі швидкістю 61,8 ток/с, підтримує контекст обсягом 128 Кб та досягає максимуму у 14,8 Гб VRAM на пристрої з 32 ГБ оперативної пам’яті системи. Його продуктивність також зростає з кількістю паралельних запитів: загальна швидкість зростає з 46,1 ток/с для одного запиту до 72,3 ток/с для чотирьох.
Прев’ю Raon-1 mini демонструє наслідки надмірного використання цього підходу. Із 9 шарами експертів у RAM він декодує зі швидкістю 42,1 ток/с, приймає лише 17,7% своїх проєктів у форматі DFlash2, підтримує контекст обсягом 16 Кб та у тестах якості досягає в середньому 45,1%. Офлоадинг дійсно ефективний, але це компроміс, а не безкоштовна додаткова потужність.
Одна карта, дві карти чи RTX 5090
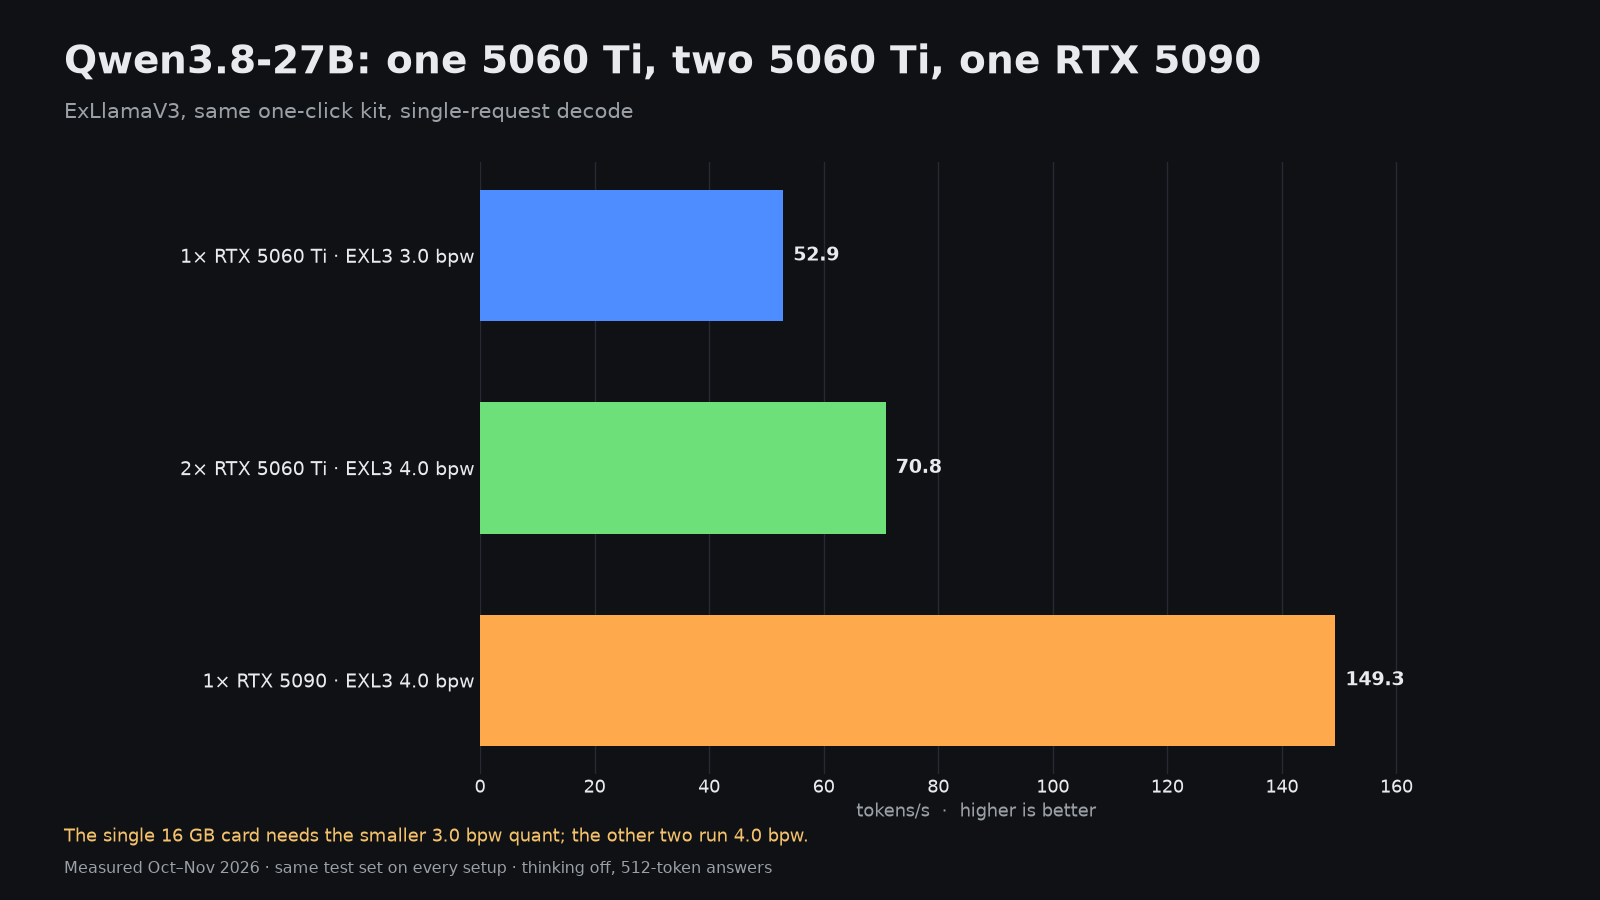
Додаткова картка 5060 Ti з підтримкою тензорного паралелізму підвищує швидкість роботи Qwen3.8-27B до 70,8 tok/s, а ще важливіше — дозволяє використовувати формат квантування EXL3 з роздільною здатністю 4,0 біт/позиція та контекстом обсягом 256K, що займає 22,4 GiB на обидві картки. Середній рівень якості підвищується до 67,2%. Це справжнє покращення, але швидкість зростає приблизно на 34%, а не вдвічі.
RTX 5090 працює за тією самою конфігурацією 4.0 bpw зі швидкістю 149,3 tok/s, що приблизно в 2,8 рази більше, ніж у однієї картки 5060 Ti, та в 2,1 рази — ніж у двох таких карток. Швидкість обробки даних у форматі 8K зростає з 1 027 до 3 484 tok/s. Якщо мета — швидкість, то одна більша картка краща за дві менші; якщо у вас вже є одна картка 5060 Ti, друга картка дозволить отримати кращі результати обробки контексту та кращу якість квантування.
Зображення, відео, 3D та аудіо на одній картці
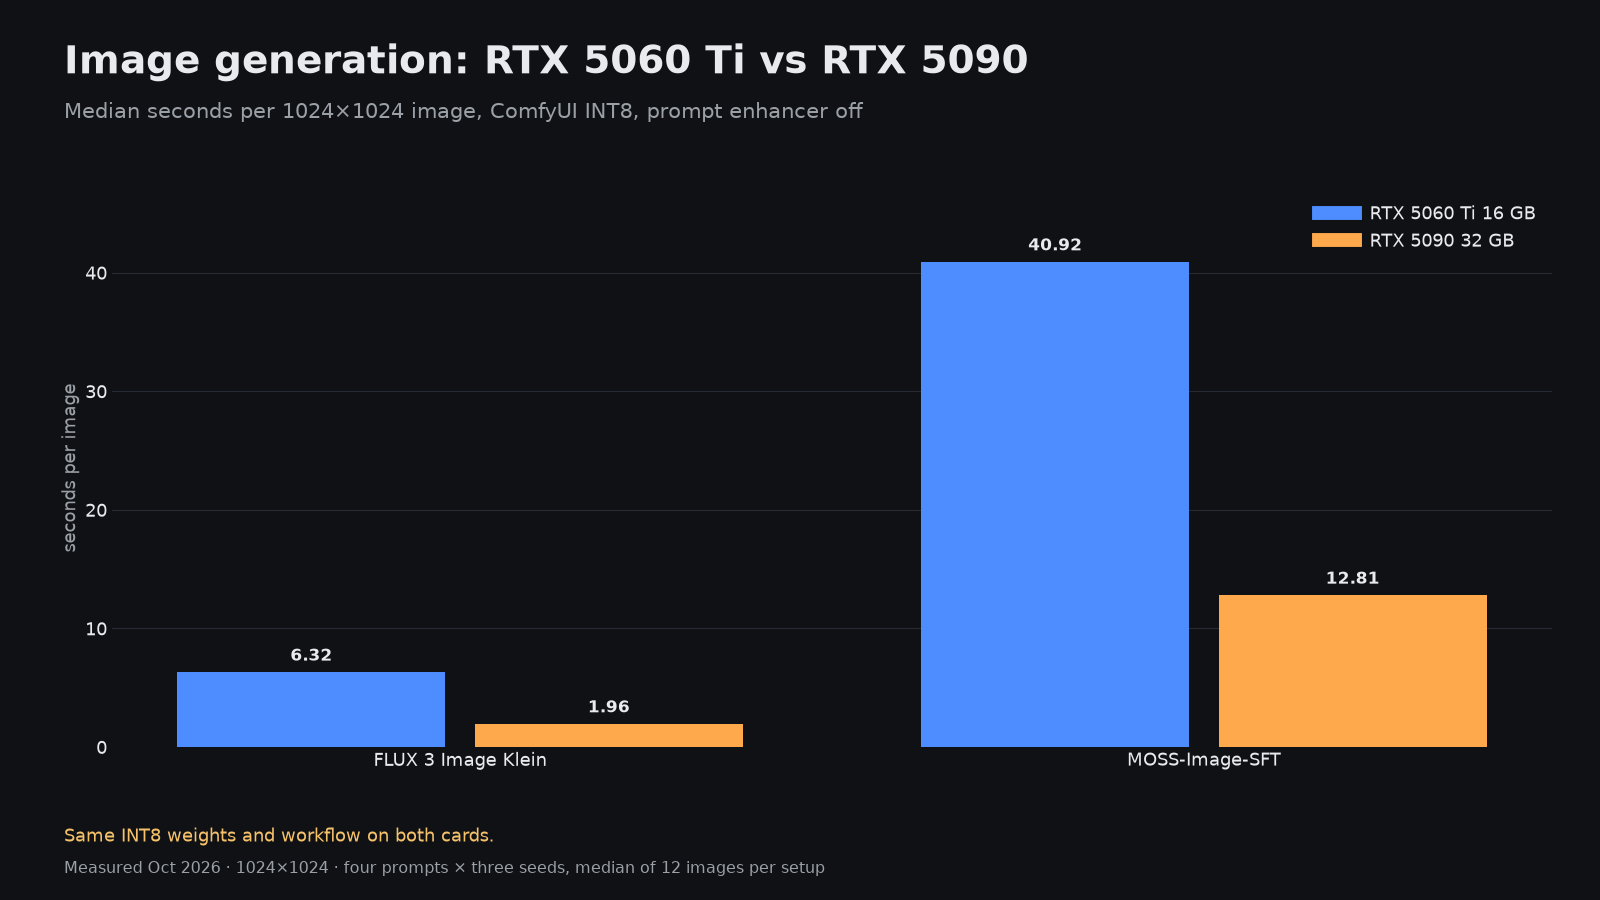
| Завдання | RTX 5060 Ti 16 GB | RTX 5090 32 GB |
|---|---|---|
| Обробка зображення FLUX Klein | 6,32 с | 1,96 с |
| Зображення MOSS | 40,92 с | 12,81 с |
| 3D-модель Idol, одна картинка для створення мешу | 57,4 с | 14,5 с |
| HyperFlow H3 Flash, 5-секундний кліп із звуком, формат GGUF Q4_K_M | 562,2 с | 107,1 с |
Зображення та 3D-контент цілком можна обробляти на картці з 16 ГБ: зображення FLUX Klein, яке готується приблизно за шість секунд, підходить для ітерацій. Проблеми виникають із відео — картка не встигає його обробити. Один 5-секундний кліп HyperFlow H3 Flash у роздільній здатності 1344×768 вимагає 562,2 с, тобто трохи більше дев’яти хвилин, на відміну від 107,1 с у картці 5090 з тим самим файлом у форматі Q4_K_M та 86,8 с у версії INT8, яка потребує потужнішої картки.
Розпізнавання мовлення є справжнім сюрпризом. Nemotron 3.5 Transcribe обробляє 59 хвилин 39 секунд чистого аудіо з тесту LibriSpeech за 120 секунд на відеокарті 5060 Ti, зі швидкістю 29,8× від реального часу, з рівнем помилок у словах 1,54%. Для транскрипції 16 ГБ цілком достатньо.
Що купувати та що використовувати
- Для однієї картки на 16 ГБ почніть із Qwen3.8-27B EXL3 3.0 bpw у ExLlamaV3: швидкість обробки 52,9 tok/с, обсяг контексту близько 115 К, якість оцінюється високо.
- Використовуйте Flint 40B для швидкого чату та створення проєктів зі швидкістю 115,9 tok/с, а для завдань, де важлива точність, залиште більш потужну модель.
- Спробуйте Clover-35B-A3B із моделями в оперативній пам’яті, якщо вам потрібен обсяг контексту 128 К та є принаймні 32 ГБ оперативної пам’яті.
- Очікуйте повільної обробки перших токенів при довгих запитах. На цій картці тримайте обсяги даних RAG та контекст агента мінімальними.
- Обробка зображень, 3D-даних та транскрипції відбувається ефективно. Генерація відео працює, але з часом приблизно дев’ять хвилин на кожен 5-секундний фрагмент, тож це операція пакетного оброблення.
- Якщо ви сьогодні обираєте обладнання та для вас важлива швидкість, то RTX 5090 є значно кращим вибором, ніж ще один пристрій моделі 5060 Ti.
Як були отримані ці цифри
У всіх тестах на обсязі 16 ГБ використовується один пристрій RTX 5060 Ti 16 ГБ під управлінням Linux; основним процесором є Core i7-12700K з 32 ГБ оперативної пам’яті. Швидкість роботи мовної моделі визначається як медіана кількості відповідей довжиною 512 токенів після розігріву, заповнення контексту вимірюється для фіксованих запитів розміром 2K, 8K та 32K, а обмеження контексту — це найбільший запит, який може бути оброблений та на який може бути надана відповідь. Якість оцінюється як середнє значення семи тестів, проведених однаково на кожній тестовій конфігурації. Час обробки зображень та відео визначається як медіана часу від моменту звернення до моменту створення готового файлу.