用于本地AI的RTX 5060 Ti 16 GB:实测的大语言模型、图像处理及语音处理速度数据。
针对本地AI场景测试的RTX 5060 Ti 16 GB:5种大语言模型的生成速度在42至116个token/秒之间,首个token的生成时间在32K级别,同时涵盖了图像、视频、3D内容及语音处理的处理速度,以及适合在该显卡上运行的应用。
16 GB版的RTX 5060 Ti是许多家庭级AI系统的首选显卡:它拥有足以运行270亿参数级别语言模型的视频内存,价格也符合普通台式机的预算范围。这就引出了一个显而易见的问题:实际加载有用内容时它的速度究竟如何?下文展示了在同一张显卡上运行五种语言模型、两种图像模型、一种视频模型、一种3D模型以及一种语音模型时的测试数据,同时还说明了再增加一张5060 Ti或升级到RTX 5090后性能的变化情况。
所有语言模型测试都使用相同的测试条件:针对代码提示和散文提示生成512个标记长度的回复,先进行预热测试,取多次运行结果的中位数,然后停止思考。提示词处理测试分别在2K、8K和32K标记长度下进行,而上下文测试则不断增加数据量,直到系统无法继续处理为止。
16 GB内存可容纳的五种模型
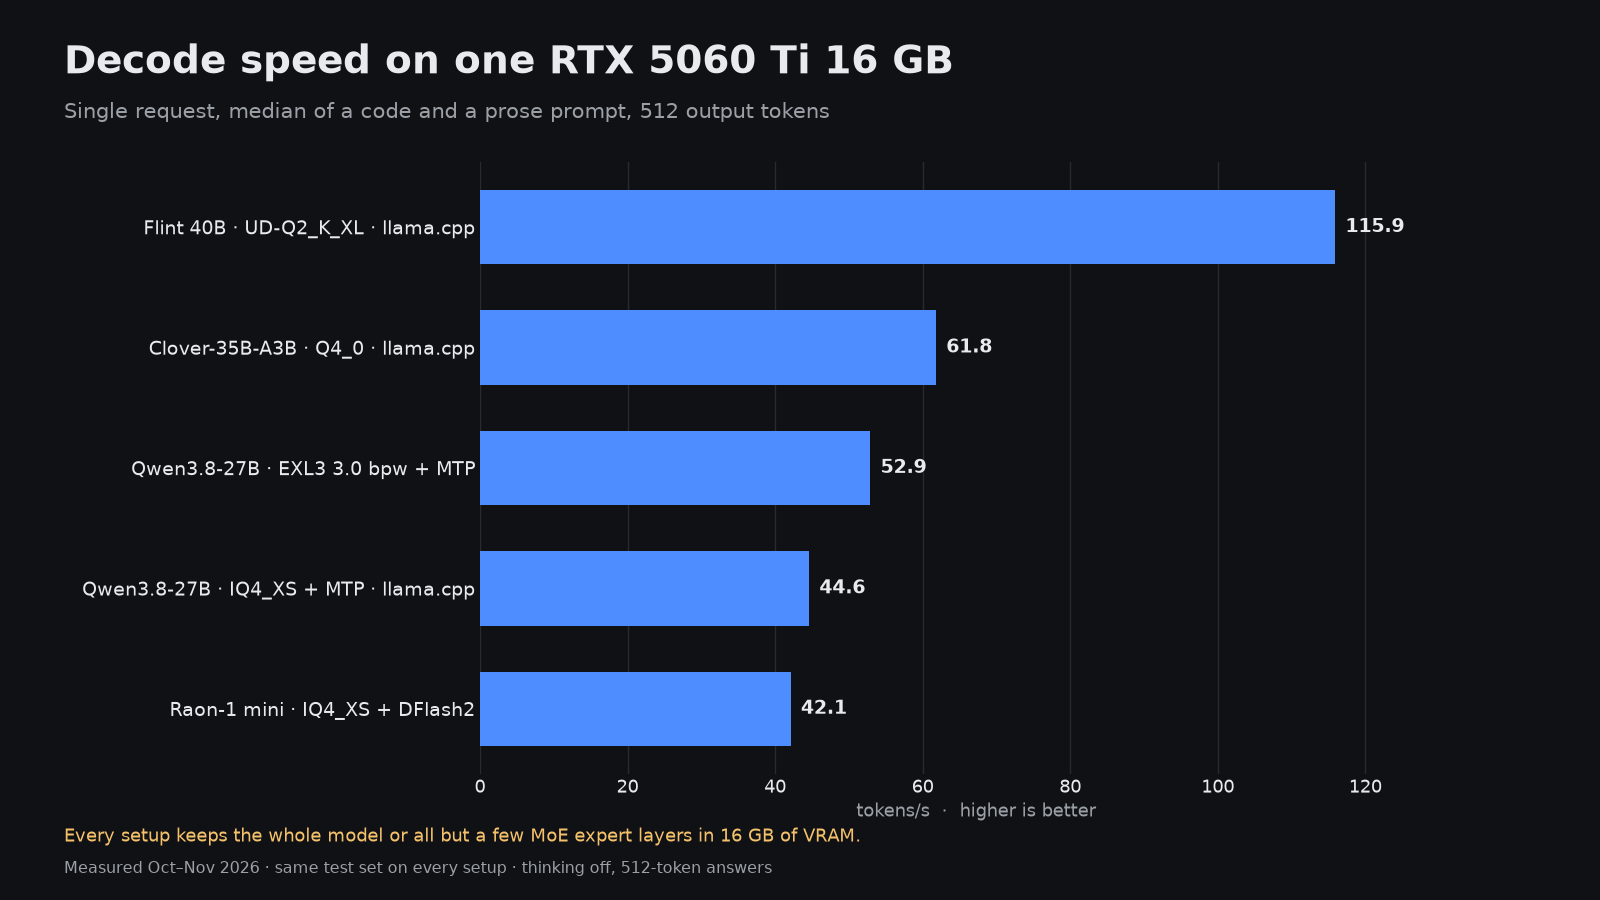
| 模型及量化版本 | 引擎 | 解码速度,标记/秒 | 8K预填充速度,标记/秒 | 32K上下文下的首个标记生成时间 | 最大上下文长度 | 峰值显存使用量 |
|---|---|---|---|---|---|---|
| Flint 40B UD-Q2_K_XL | llama.cpp | 115.9 | 2,364 | 15.6 秒 | 64K | 14.7 GiB |
| Clover-35B-A3B Preview Q4_0 | llama.cpp,20层专家网络运行在RAM中 | 61.8 | 992 | 37.4 秒 | 128K | 14.8 GiB |
从上到下的数值差异接近3倍,仅以原始速度排序并不能反映实际使用中的表现。在这组测试中,只有Qwen3.8-27B EXL3版本获得了完整的质量评分(七次测试的平均值为66.1%),其余版本仅针对速度和上下文容量进行了测试,尚未进行排名。
Flint 40B之所以速度快,是因为对其进行了极致优化
Flint 40B的生成速度为115.9 tok/s,代码提示与普通文本提示的生成速度相差不到0.2 tok/s。它通过2位Unsloth量化格式(UD-Q2_K_XL)实现这一速度,整个模型占用VRAM 14.7 GiB,仅能容纳64K的上下文量。在5090显卡上,同一模型的NVFP4版本在质量测试中的得分仅为38.6%,是该显卡上所有测试结果中最低的。应将Flint视为快速草稿生成和聊天用的模型,而不适合用于代码审查。
Qwen3.8-27B是最佳平衡选择
通过一键式ExLlamaV3工具包获得的Qwen3.8-27B EXL3 3.0 bpw版本,解码速度为52.9 tok/s(代码为53.6,普通文本为52.1),在15.2 GiB的显存下仍可容纳117,760个标记的上下文量。在這组16 GB显存的产品中,它是速度、上下文容量与质量表现最均衡的选项。
同一模型的ByteShape IQ4_XS GGUF版本可作为有益的对比。它的每个权重所保留的比特数更多(3.84 bpw),因此量化带来的损失应该更小,但其解码速度仅为44.6 tok/s,其MTP草稿的通过率仅为49.3%,且在15.4 GiB的显存下上下文长度上限降至43,008个标记。如果您主要处理长文件或代理会话,EXL3版本带来的额外上下文优势比额外的比特数更为重要。
生成第一个标记所需的时间
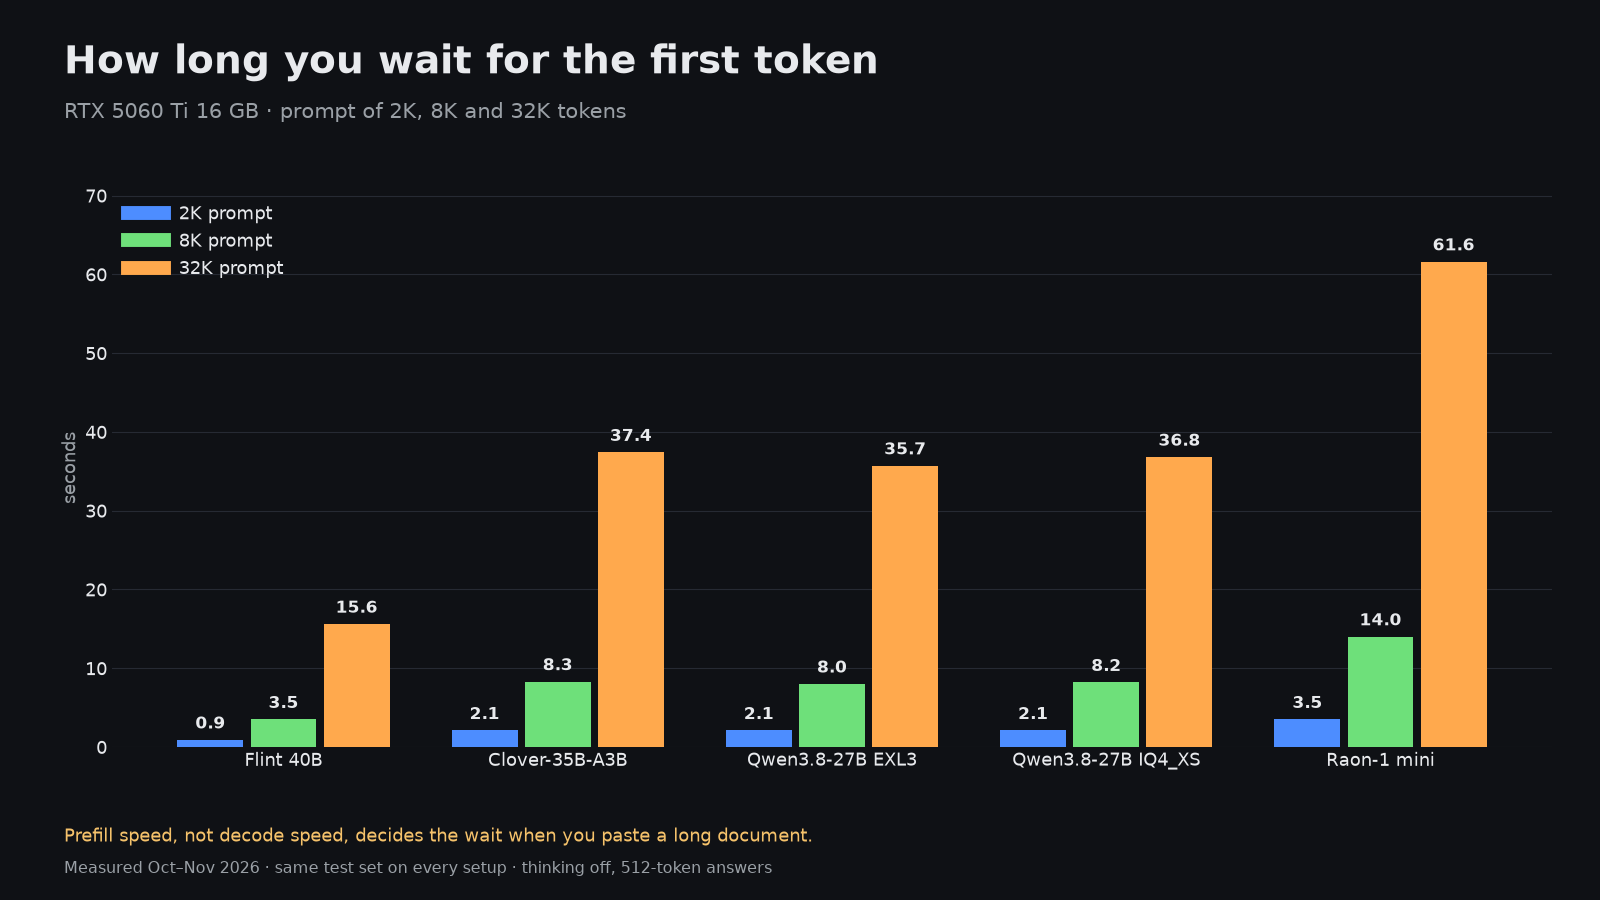
基准测试通常强调解码速度,但对于16 GB的显卡而言,等待结果出现的时间往往才是更严重的问题。一个包含32K个标记的提示语——大致相当于一个中等规模的代码库文件——在Flint上的处理时间为15.6秒,在Qwen3.8-27B上为35.7秒,在Raon-1 mini上则为61.6秒。对于这种显卡而言,处理密集型27B模型的预填充速度约为1,027个标记/秒,因此每多10K个上下文标记,就需要多等待大约十秒才能得到第一个词。
如果你的工作负载是使用简短提示语的聊天,那么解码速度就是需要关注的关键指标;如果是RAG、编程助手或处理长文档,那么应首先比较预填充时间和第一个词出现的时间。
将专家模型存储在系统RAM中的MoE架构
专家混合模型是处理超过16 GB内存通常所能承载规模数据的主要方式。通过--n-cpu-moe选项,llama.cpp可将前几层的专家权重保留在系统RAM中,其余部分则由GPU处理。在配备32 GB系统RAM的硬件上,Q4_0版本的Clover-35B-A3B预览版将20层专家权重存储在RAM中,运行速度可达61.8 tok/s,上下文长度可达128K,VRAM使用量最高为14.8 GiB。其处理效率还会随并行请求数量增加而提升:单个请求时的总吞吐量为46.1 tok/s,而四个请求时则可提升至72.3 tok/s。
Raon-1 mini预览版展示了过度使用相同策略所带来的弊端。当仅将9层专家权重存储在RAM中时,其解码速度为42.1 tok/s,仅能接受DFlash2生成的草稿的17.7%,上下文长度最高为16K,质量测试的平均通过率为45.1%。虽然通过卸载任务可以改善性能,但这属于权衡之计,并非免费的额外容量。
单张显卡、两张显卡还是RTX 5090?
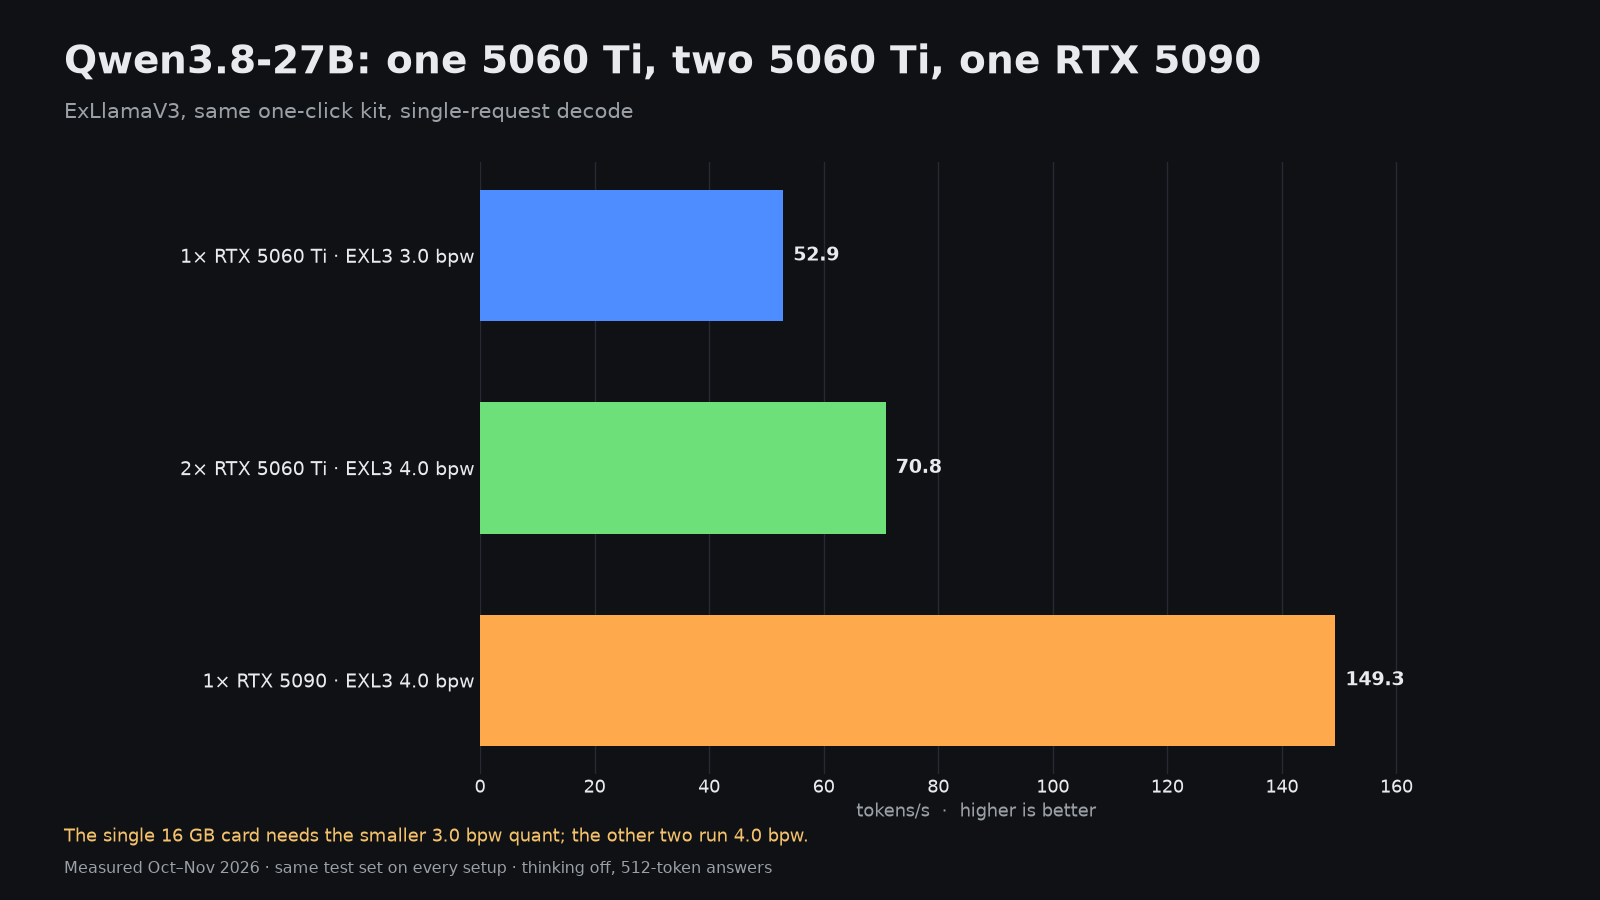
通过张量并行技术,第二块5060 Ti可将Qwen3.8-27B的解码速度提升至70.8 tok/s;更重要的是,它支持在两块显卡上共同使用256K上下文、4.0 bpw EXL3量化格式,内存占用为22.4 GiB,其质量平均值可提升至67.2%。这确实是一次显著的升级,但速度提升约为34%,而非两倍。
RTX 5090采用相同的4.0 bpw架构,运算速度为149.3 tok/s,约为单块5060 Ti的2.8倍,也是两块5060 Ti组合速度的2.1倍。在8K分辨率下的预填充速度从1,027 tok/s提升至3,484 tok/s。如果追求速度,一块大显卡比两块小显卡更高效;如果您已经拥有一块5060 Ti,再买一块则能提升上下文处理能力并获得更好的量化效果。
同一张显卡处理图像、视频、3D内容及语音任务
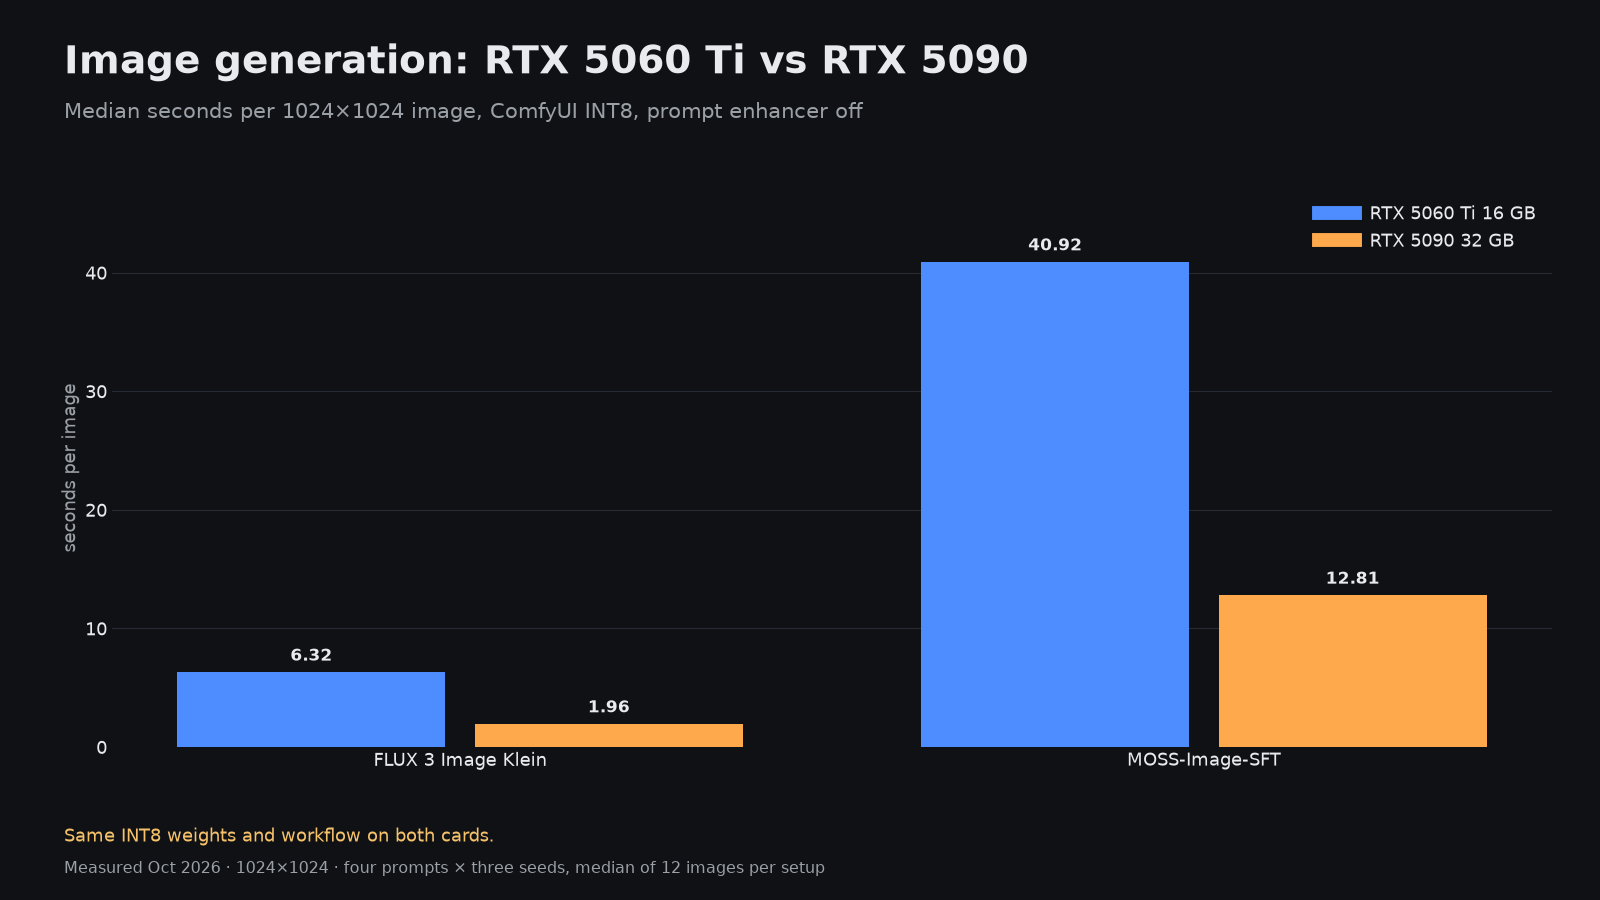
| 任务类型 | RTX 5060 Ti 16 GB | RTX 5090 32 GB |
|---|---|---|
| FLUX Klein图像生成 | 6.32秒 | 1.96 秒 |
| MOSS 图像 | 40.92 秒 | 12.81 秒 |
| Idol 3D 模型,单张图片生成网格 | 57.4 秒 | 14.5 秒 |
| HyperFlow H3 Flash,带声音的5秒片段,GGUF Q4_K_M 格式 | 562.2 秒 | 107.1 秒 |
16 GB 显存完全能够处理图像和3D内容:处理一张 FLUX Klein 图像大约需要6秒,足以用于迭代设计。但在处理视频时,这款显卡就力不从心了。一个1344×768分辨率、时长5秒的HyperFlow H3 Flash片段需要562.2秒,即九分多钟,而5090显卡处理相同Q4_K_M格式的文件仅需107.1秒,需要更大显存的INT8版本则需要86.8秒。
语音识别效果令人惊喜。在5060 Ti显卡上,Nemotron 3.5 Transcribe仅需120秒即可处理59分39秒的LibriSpeech测试音频,实时处理速度达29.8倍,单词错误率为1.54%。对于文本转录而言,16GB内存完全足够。
该购买什么以及运行什么
- 若仅使用1张16GB的显卡,可先选用ExLlamaV3中的Qwen3.8-27B EXL3 3.0 bpw模型:处理速度为52.9个token/秒,上下文长度约为115K,质量评分较高。
- 如需快速聊天和草拟内容,可使用Flint 40B模型,处理速度为115.9个token/秒;对于要求更高的任务,则应选用更强大的模型。
- 当需要128K的上下文长度且系统内存至少为32GB时,可尝试配备足够RAM的Clover-35B-A3B模型。
- 对于较长的输入提示,初始处理速度会较慢,建议在此类显卡上控制RAG片段和智能体上下文的大小。
数据统计方式
所有16 GB内存的测试均在Linux系统下使用单块RTX 5060 Ti 16 GB显卡进行;测试主机为配备32 GB内存的Core i7-12700K处理器。语言模型速度为预热后的多次512个标记响应的中位数,预填充效果则在固定的2K、8K和32K长度的提示语上进行测试,而上下文长度则指能够加载并生成响应的最大提示语长度。质量评分则是针对每套测试环境重复进行的七次测试的结果平均值。图片和视频的生成时间则为从请求发送到文件生成完成的时间的中位数。