RTX 5060 Ti 16 GB do lokalnej sztucznej inteligencji: zmierzone prędkości modeli LLM, obrazów i dźwięku.
RTX 5060 Ti 16 GB przetestowany pod kątem lokalnej sztucznej inteligencji: pięć modeli LLM o prędkości od 42 do 116 toków na sekundę, czasy obliczenia pierwszego tokena na poziomie 32K, prędkość przetwarzania obrazów, wideo, treści 3D oraz dźwięku, oraz to, co można na nim uruchomić.
Karta 16 GB RTX 5060 Ti jest tą, od której zaczyna się wiele domowych systemów AI: ma wystarczającą ilość pamięci wideo do obsługi modeli językowych klasy 27B, a jej cena mieści się w zwykłym budżecie na komputer stacjonarny. To rodzi oczywiste pytanie: jak szybka jest, gdy faktycznie załadujemy coś przydatnego? Poniżej przedstawiono uzyskane wartości dla pięciu konfiguracji modeli językowych, dwóch modeli obrazów, jednego modelu wideo, jednego modelu 3D oraz jednego modelu mowy na jednej karcie, a także informacje o zmianach po dodaniu drugiej karty 5060 Ti lub przejściu na RTX 5090.
Każdy test modelu językowego wykorzystuje ten sam zestaw zadań: odpowiedzi składające się z 512 tokenów na prompty kodowe i prozatorskie, najpierw fazę rozgrzewkową, uśrednienie wyników z powtórzonych testów oraz czas na przetworzenie informacji. Przetwarzanie promptów mierzone jest przy ilości 2K, 8K i 32K tokenów, a test kontekstowy sprawdza każdą konfigurację, aż ten przestanie być wystarczający.
Pięć modeli, które mieszczą się w 16 GB
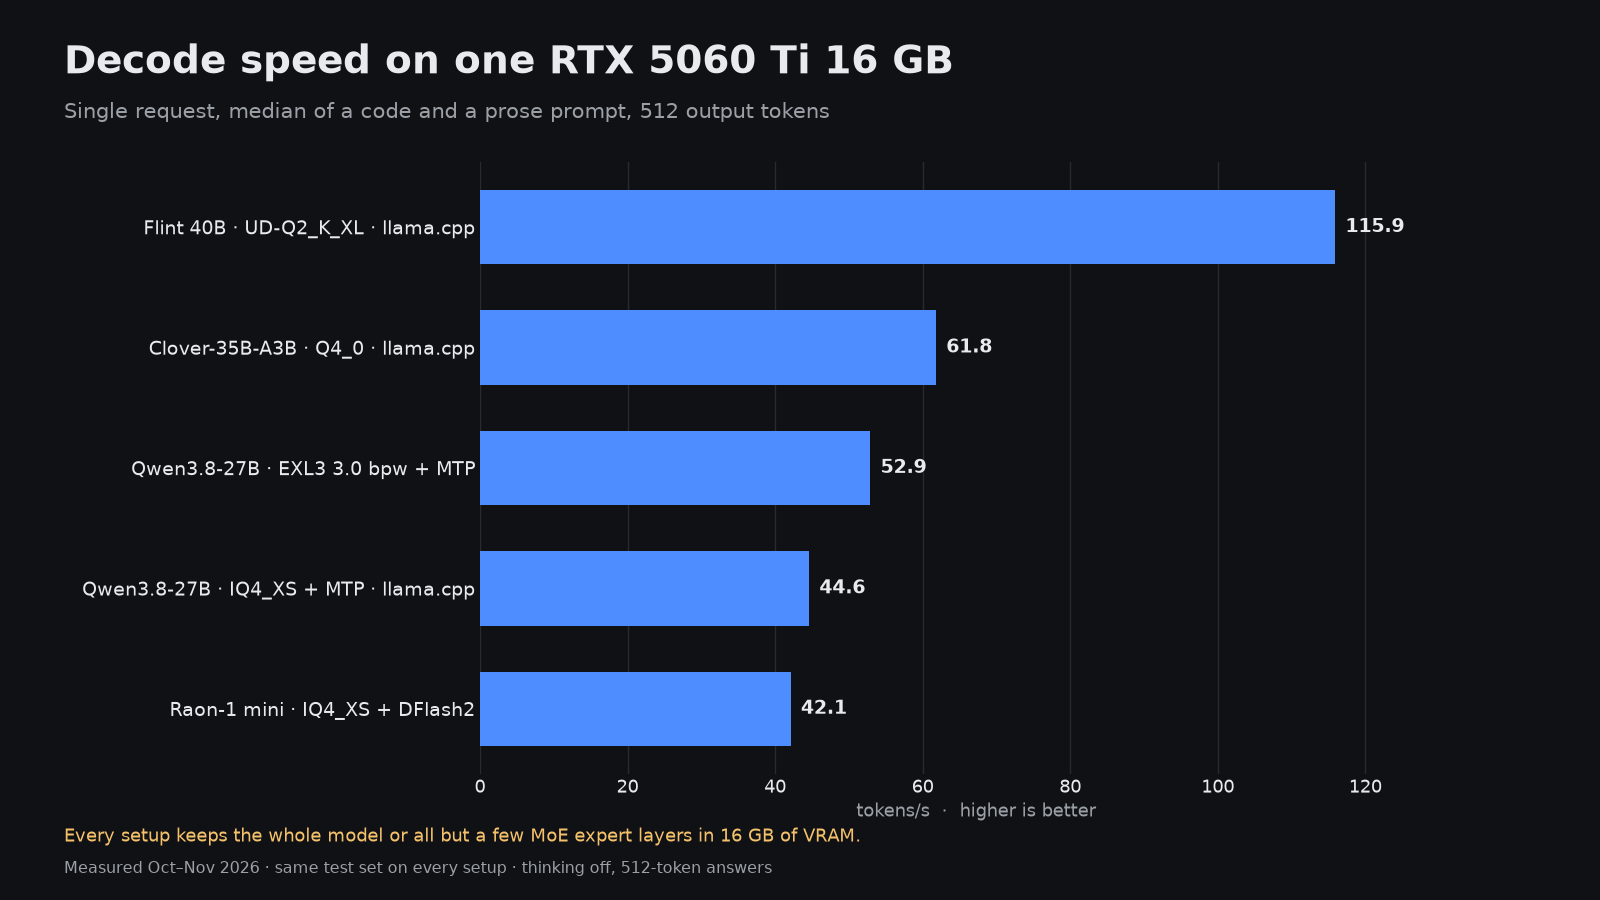
| Model i kwantyzacja | Motor | Decodowanie, tok/s | Prefill 8K, tok/s | Pierwszy token przy 32K | Największy kontekst | Maksymalna ilość VRAM |
|---|---|---|---|---|---|---|
| Flint 40B UD-Q2_K_XL | llama.cpp | 115,9 | 2 364 | 15,6 s | 64K | 14,7 GiB |
| Clover-35B-A3B Preview Q4_0 | llama.cpp, 20 warstw ekspertów w RAM | 61,8 | 992 | 37,4 s | 128K | 14,8 GiB |
| Qwen3.8-27B EXL3 3.0 bpw | ExLlamaV3 z MTP | 52.9 | 1,027 | 35.7 s | 117,760 | 15.2 GiB |
| Qwen3.8-27B ByteShape IQ4_XS | llama.cpp z MTP | 44.6 | 998 | 36.8 s | 43,008 | 15.4 GiB |
| Raon-1 mini preview IQ4_XS | llama.cpp, 9 warstw ekspertów w RAM | 42.1 | 586 | 61.6 s | 16K | 12.9 GiB |
Różnica między wynikami od góry do dołu wynosi prawie 3 razy, a ranking oparty wyłącznie na szybkości nie jest tym, który chcemy przy codziennym użyciu. Tylko wersja Qwen3.8-27B EXL3 ma pełną ocenę jakości na tej liście (66,1 % średnio z siedmiu testów). Pozostałe zostały zmierzone pod kątem szybkości i obszaru kontekstowego, ale jeszcze nie zostały sklasyfikowane.
Flint 40B jest szybki, ponieważ jest intensywnie optymalizowany
Flint 40B osiąga prędkość 115,9 tok/s, przy czym szybkość przetwarzania zapytań tekstowych i kodu różni się o zaledwie 0,2 tok/s. Umożliwia to osiągnięcie tej prędkości dzięki 2-bitowej kwantyzacji Unsloth (UD-Q2_K_XL), która umożliwia przechowywanie całego modelu w VRAM o pojemności 14,7 GiB, co pozostawia miejsce na kontekst o długości 64K i nic więcej. Na karcie 5090 wersja NVFP4 tego samego modelu osiągnęła 38,6% wyniku w testach jakości, co jest najgorszym wynikiem spośród wszystkich testów przeprowadzonych na tej karcie. Traktuj Flint jako szybki model do szybkiego projektowania i rozmów, a nie jako narzędzie do sprawdzania kodu.
Qwen3.8-27B to optymalny wybór
Wersja Qwen3.8-27B EXL3 3.0 bpw z zestawu ExLlamaV3 jednym kliknięciem dekoduje tekst z prędkością 52,9 tok/s (53,6 przy kodzie, 52,1 przy tekście prozatorskim) i nadal może przechowywać 117 760 tokenów kontekstu w pamięci o pojemności 15,2 GiB. To najsilniejsza kombinacja prędkości, pojemności kontekstu i jakości wśród modeli na kartach o pojemności 16 GB w tym zestawie.
Model ByteShape IQ4_XS GGUF z tego samego rodzaju stanowi przydatny punkt porównawczy. Zachowuje więcej bitów na wagę (3,84 bpw), więc powinien tracić mniej podczas kwantyzacji, ale dekoduje z prędkością 44,6 tok/s, jego projekty MTP są akceptowane w 49,3% przypadków, a górna granica kontekstu spada do 43 008 tokenów przy 15,4 GiB. Jeśli pracujesz głównie z długimi plikami lub sesjami agentów, dodatkowy kontekst w wersji EXL3 ma większe znaczenie niż dodatkowe bity.
Ile czasu zajmuje pierwszy token
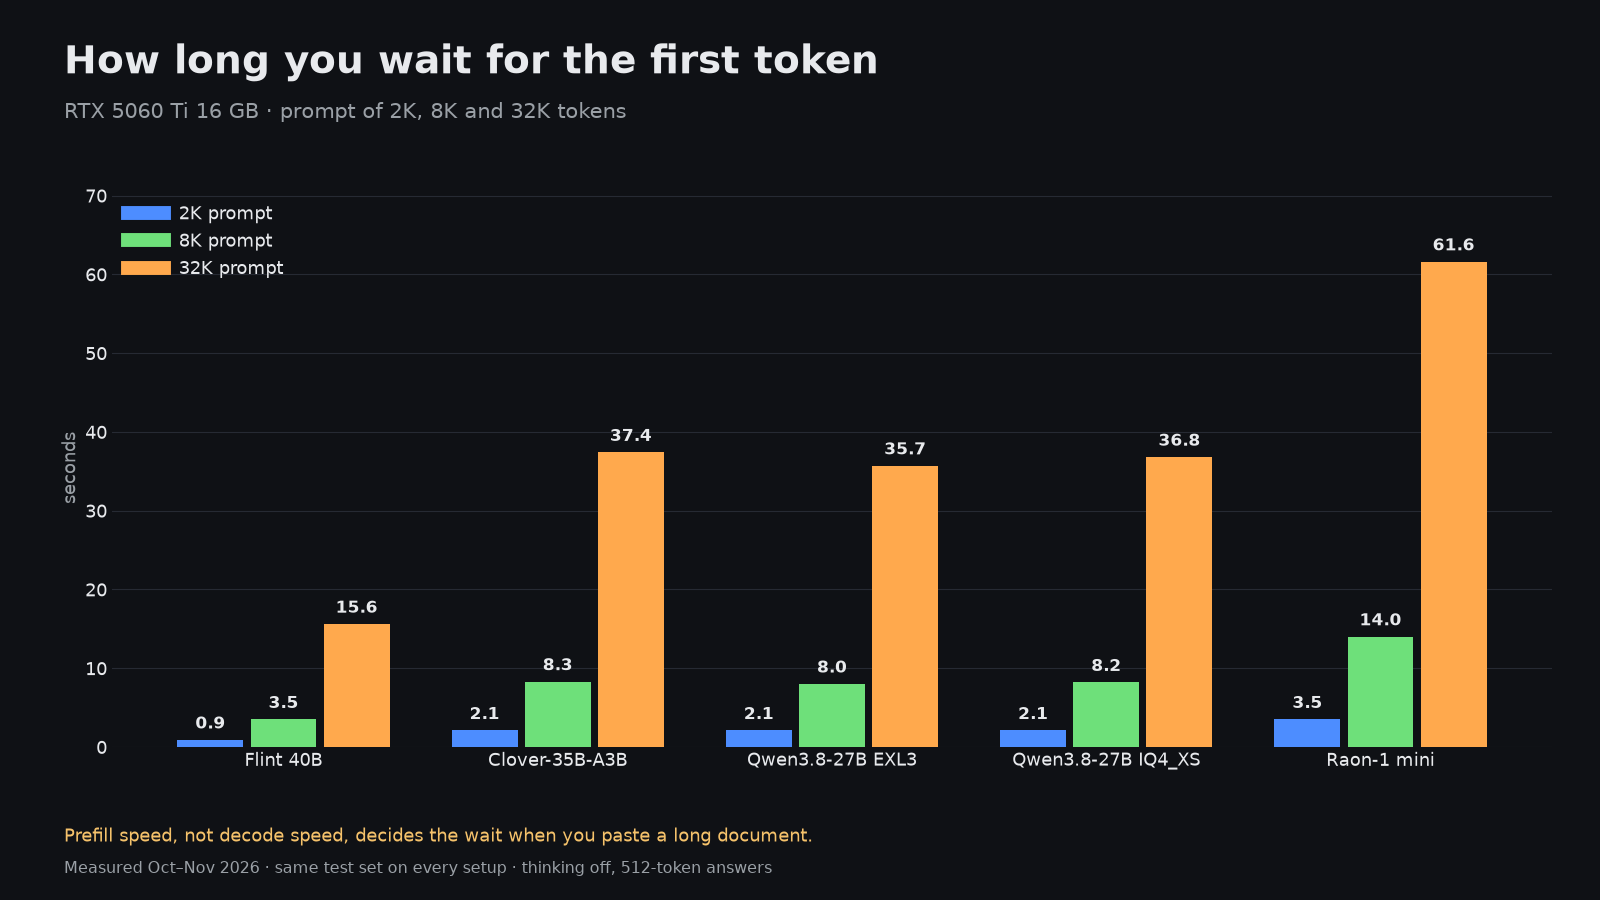
Szybkość dekodowania jest tematem głównym testów wydajności, ale w karcie o pojemności 16 GB większym problemem często jest czas oczekiwania przed otrzymaniem odpowiedzi. Zapytanie zawierające 32K tokenów, co odpowiada mniej więcej średniej wielkości plikowi kodowemu, zajmuje 15,6 s w przypadku Flint, 35,7 s w przypadku Qwen3.8-27B oraz 61,6 s w przypadku Raon-1 mini. Proces wypełniania początkowego kontekstu na tej karcie odbywa się z prędkością około 1 027 tokenów na sekundę dla gęstego modelu 27B, więc każde dodatkowe 10K tokenów kontekstu kosztuje około dziesięciu sekund przed pojawieniem się pierwszego słowa.
Jeśli twoja praca polega na rozmowach z krótkimi zapytaniami, kluczową jest szybkość dekodowania. Jeśli chodzi o RAG, agenty programistyczne lub długie dokumenty, najpierw porównaj czas wypełniania początkowego kontekstu oraz czas generowania pierwszego tokena.
Modele MoE z ekspertami w pamięci RAM systemowej
Modele typu Mixture-of-experts to główne rozwiązanie umożliwiające obsługę obiektów większych niż te, które normalnie dałoby się przetworzyć przy 16 GB pamięci. llama.cpp może przechowywać wagi ekspertów pierwszych warstw w pamięci RAM systemu za pomocą flagi --n-cpu-moe, a resztę obliczeń przejmuje karta GPU. Wersja próbna Clover-35B-A3B Preview w wersji Q4_0 z 20 warstwami ekspertów w RAM działa z prędkością 61,8 tok/s, obsługuje kontekst o długości 128K i osiąga maksymalnie 14,8 GiB pamięci VRAM na urządzeniu z 32 GB pamięci RAM systemu. Przepustowość rośnie również wraz z liczbą równoległych zapytań: z 46,1 tok/s przy jednym zapytaniu do 72,3 tok/s przy czterech.
Wersja próbna Raon-1 mini pokazuje konsekwencje nadmiernego wykorzystania tego samego podejścia. Przy 9 warstwach ekspertów w RAM dekoduje z prędkością 42,1 tok/s, przyjmuje jedynie 17,7% swoich wersji roboczych typu DFlash2, obsługuje kontekst o długości 16K i osiąga średnio 45,1% wyników w testach jakości. Przenoszenie obliczeń na inne urządzenia faktycznie pomaga, ale jest to kompromis, a nie dodatkowa, bezpłatna przepustowość.
Jedna karta, dwie karty czy RTX 5090
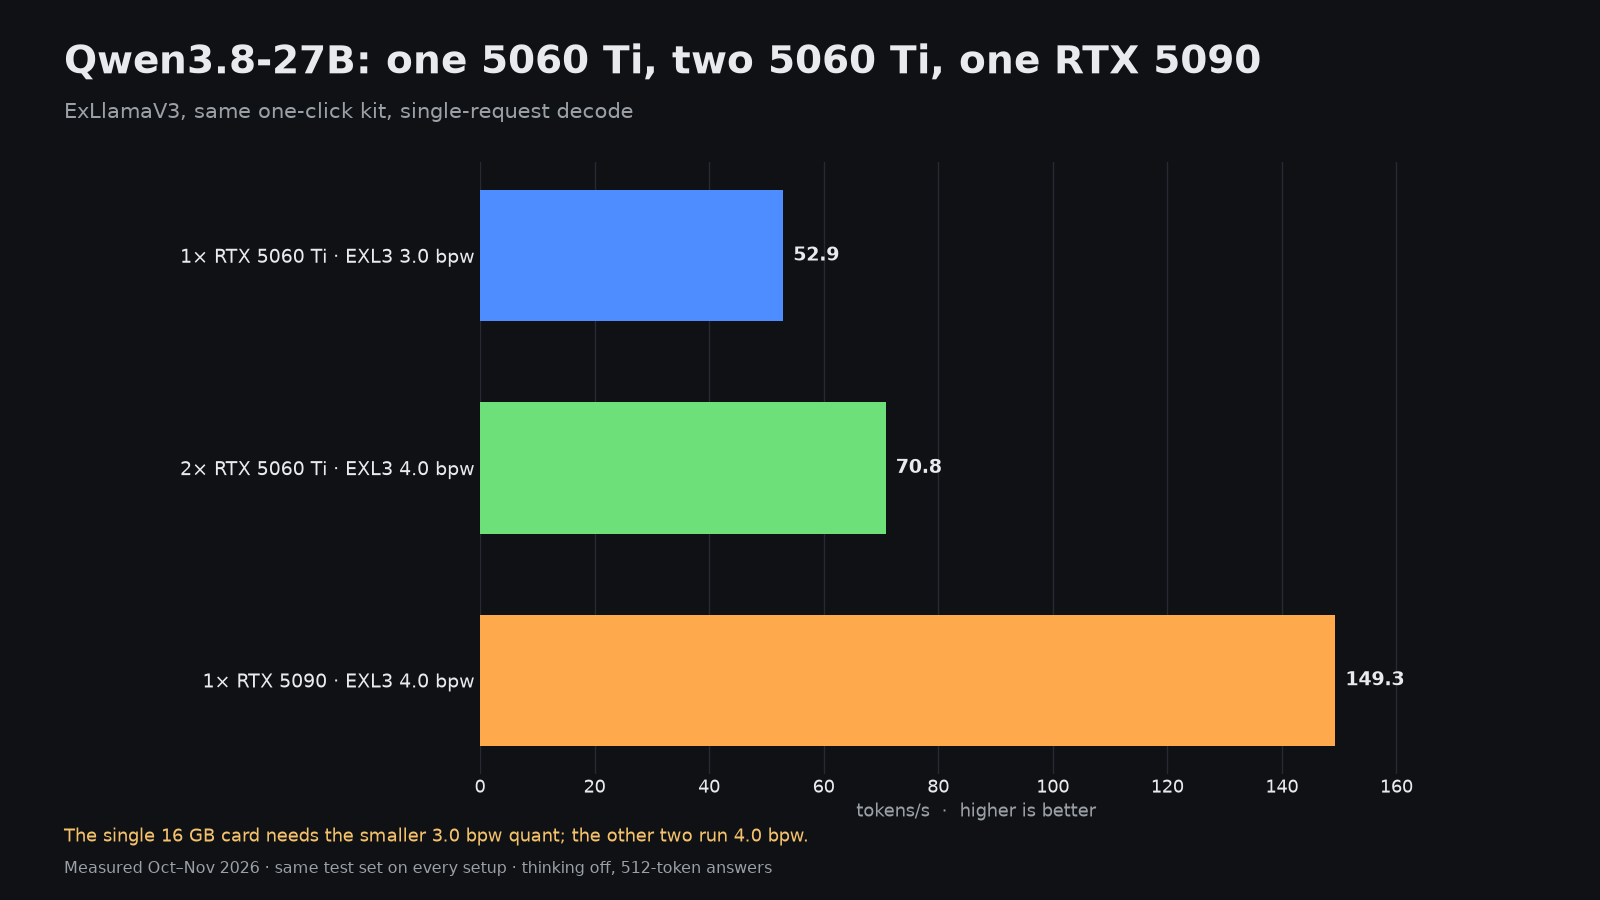
Druga karta 5060 Ti z obsługą paralelizmu tensorowego podnosi szybkość dekodowania Qwen3.8-27B do 70,8 tok/s, a co ważniejsze, umożliwia użycie kwantyzacji EXL3 o rozdzielczości 4,0 bpw z kontekstem 256K, co daje 22,4 GiB pamięci na obie karty. Średnia jakość wyników wzrasta do 67,2%. To rzeczywiste ulepszenie, ale szybkość jest o około 34% wyższa, a nie dwukrotnie wyższa.
RTX 5090 działa z tą samą konfiguracją 4,0 bpw, osiągając prędkość 149,3 tok/s, co stanowi około 2,8× szybszość pojedynczej karty 5060 Ti i 2,1× szybszość dwóch kart. Prędkość generowania obrazów w rozdzielczości 8K wzrasta z 1 027 do 3 484 tok/s. Jeśli celem jest szybkość, jedna większa karta jest lepsza od dwóch mniejszych; jeśli już posiadasz kartę 5060 Ti, druga karta zapewnia lepsze możliwości przetwarzania kontekstu oraz lepszą jakość kwantyzacji.
Obrazy, wideo, 3D i mowa na jednej karcie
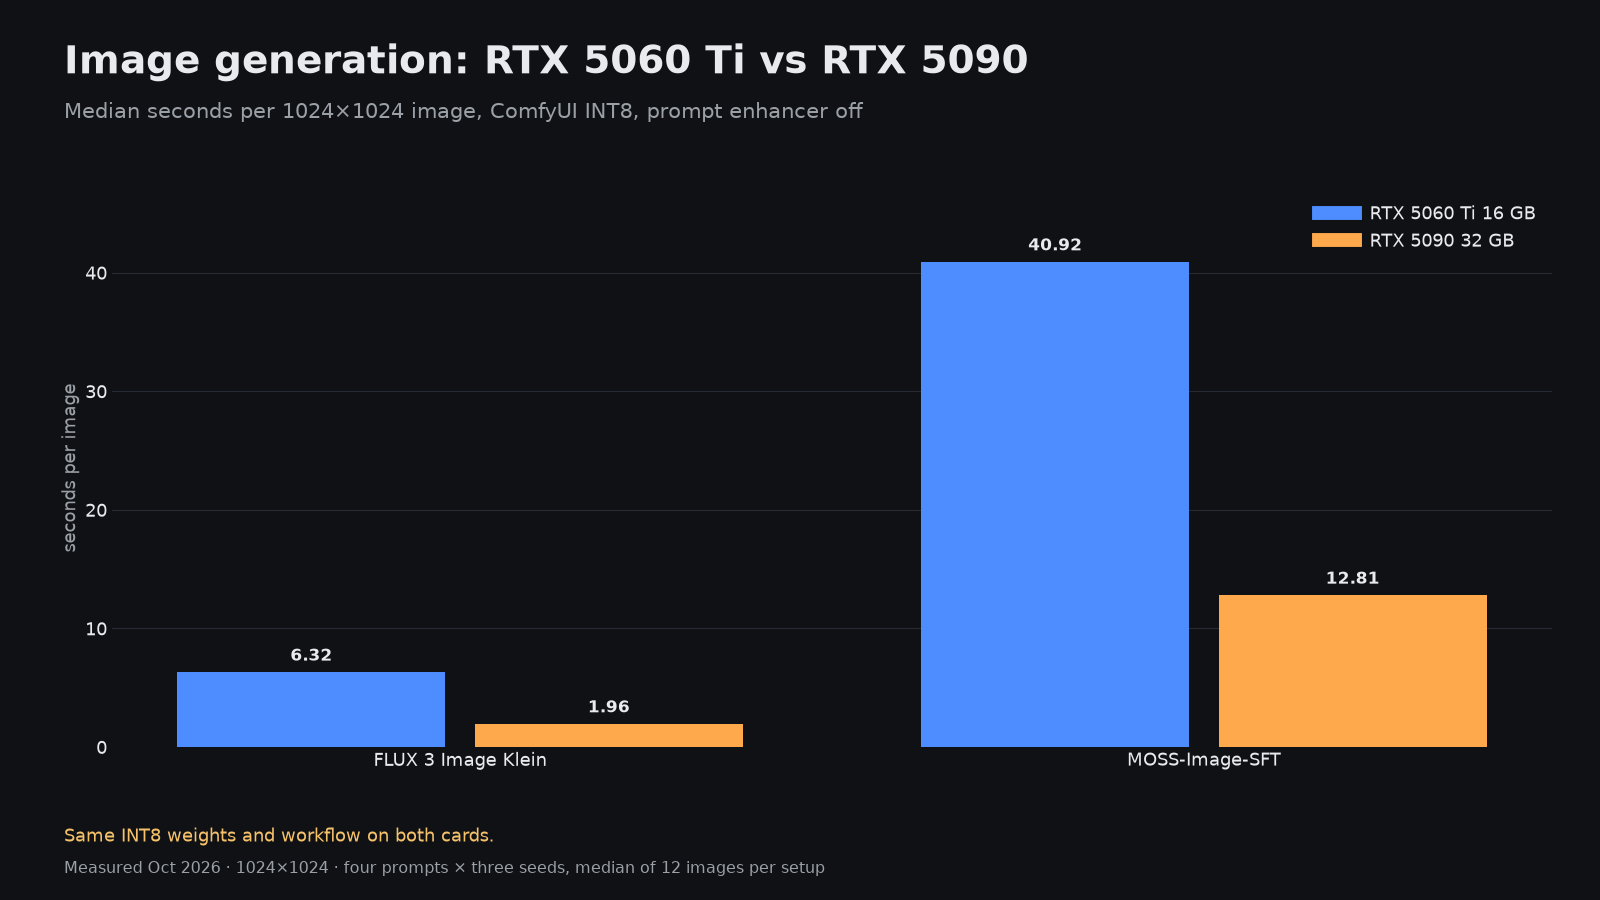
| Zadanie | RTX 5060 Ti 16 GB | RTX 5090 32 GB |
|---|---|---|
| Generowanie obrazu FLUX Klein | 6,32 s | 1,96 s |
| Zdjęcie MOSS | 40,92 s | 12,81 s |
| Model 3D Idol, jedno zdjęcie na siatkę | 57,4 s | 14,5 s |
| HyperFlow H3 Flash, 5-sekundowy klip z dźwiękiem, GGUF Q4_K_M | 562,2 s | 107,1 s |
Zdjęcia i treści 3D nadają się w pełni na karcie 16 GB: obraz FLUX Klein w ciągu około sześciu sekund nadaje się do iteracji. To w przypadku wideo karta traci wydajność. Jeden 5-sekundowy klip HyperFlow H3 Flash w rozdzielczości 1344×768 zajmuje 562,2 s, czyli nieco ponad dziewięć minut, podczas gdy karta 5090 z tym samym plikiem Q4_K_M potrzebuje 107,1 s, a wersja INT8 wymagająca większej karty – 86,8 s.
Rozpoznawanie mowy jest zaskakujące. Nemotron 3.5 Transcribe przetwarza 59 minut i 39 sekund czystego audio z testu LibriSpeech w ciągu 120 sekund na karcie 5060 Ti, z prędkością 29,8× szybszą od czasu rzeczywistego, przy stopie błędów w słowach wynoszącej 1,54%. Do transkrypcji 16 GB pamięci jest więcej niż wystarczające.
Co kupić i co uruchomić
- Dla pojedynczej karty o pojemności 16 GB rozpocznij od Qwen3.8-27B EXL3 3.0 bpw w ExLlamaV3: 52,9 tok/s, około 115K kontekstu, jakość oceniona wysoko.
- Użyj Flint 40B do szybkiej korespondencji i tworzenia tekstów z prędkością 115,9 tok/s, a dla zadań wymagających większej dokładności zachowaj silniejszy model.
- Wypróbuj Clover-35B-A3B z modelami w pamięci RAM, gdy potrzebujesz 128K kontekstu i masz co najmniej 32 GB pamięci RAM w systemie.
- Przy długich zapytaniach spodziewaj się wolnego generowania pierwszych tokenów. Na tej karcie należy zachować małą ilość fragmentów RAG oraz kontekstu agenta.
- Zdjęcia, treści 3D oraz transkrypcja działają bez problemów. Generowanie wideo jest możliwe, ale przy czasie około dziewięciu minut na 5-sekundowy klip jest to zadanie przeprowadzane partiami.
- Jeśli dziś wybierasz sprzęt, a szybkość ma znaczenie, RTX 5090 to znacznie lepszy wybór niż drugi model 5060 Ti.
Sposób uzyskiwania danych
We wszystkich testach z użyciem 16 GB pamięci użyto jednego układu RTX 5060 Ti 16 GB w systemie Linux; dokumentowany komputer host to Core i7-12700K z 32 GB pamięci RAM. Szybkość modelu językowego to wartość medianowa z powtarzanych odpowiedzi składających się z 512 tokenów po fazie rozgrzewki, prefill mierzony jest przy stałych promptach o rozdzielczości 2K, 8K i 32K, a limit kontekstu to najdłuższy prompt, który może zostać załadowany i na który można udzielić odpowiedzi. Jakość oceniana jest jako średnia z siedmiu testów przeprowadzonych identycznie na każdym zestawieniu. Czas przetwarzania obrazów i wideo to wartość medianowa od momentu złożenia żądania do uzyskania gotowego pliku.