RTX 5060 Ti 16 GB pour l’IA locale : vitesses mesurées pour les modèles LLM, les images et la parole.
Test de la RTX 5060 Ti 16 GB pour l’IA locale : cinq modèles LLM avec des vitesses allant de 42 à 116 tok/s, temps de génération du premier token à 32K, vitesses pour les images, vidéos, 3D et la parole, ainsi que les applications compatibles.
La carte 16 GB RTX 5060 Ti est celle avec laquelle de nombreuses installations d’IA domestique commencent : suffisamment de mémoire vidéo pour un modèle de langage de l’ordre de 27 milliards de paramètres, et un prix adapté au budget d’un ordinateur de bureau ordinaire. Cela soulève la question évidente : à quelle vitesse fonctionne-t-elle une fois qu’on y charge réellement quelque chose d’utile ? Ci-dessous figurent des valeurs mesurées pour cinq configurations de modèles de langage, deux modèles d’images, un modèle vidéo, un modèle 3D et un modèle de parole sur une seule carte, ainsi que les changements qui surviennent lorsqu’on ajoute une deuxième carte 5060 Ti ou qu’on passe à une RTX 5090.
Chaque exécution de modèle de langage utilise les mêmes paramètres : des réponses de 512 tokens en réponse à des prompts en code et en prose, un temps de démarrage préalable, la valeur médiane des exécutions répétées, sans temps de réflexion supplémentaire. Le traitement des prompts est mesuré pour 2 K, 8 K et 32 K tokens, et le test de contexte pousse chaque configuration jusqu’à ce que le contexte ne puisse plus être stocké.
Cinq modèles qui tiennent dans 16 GB
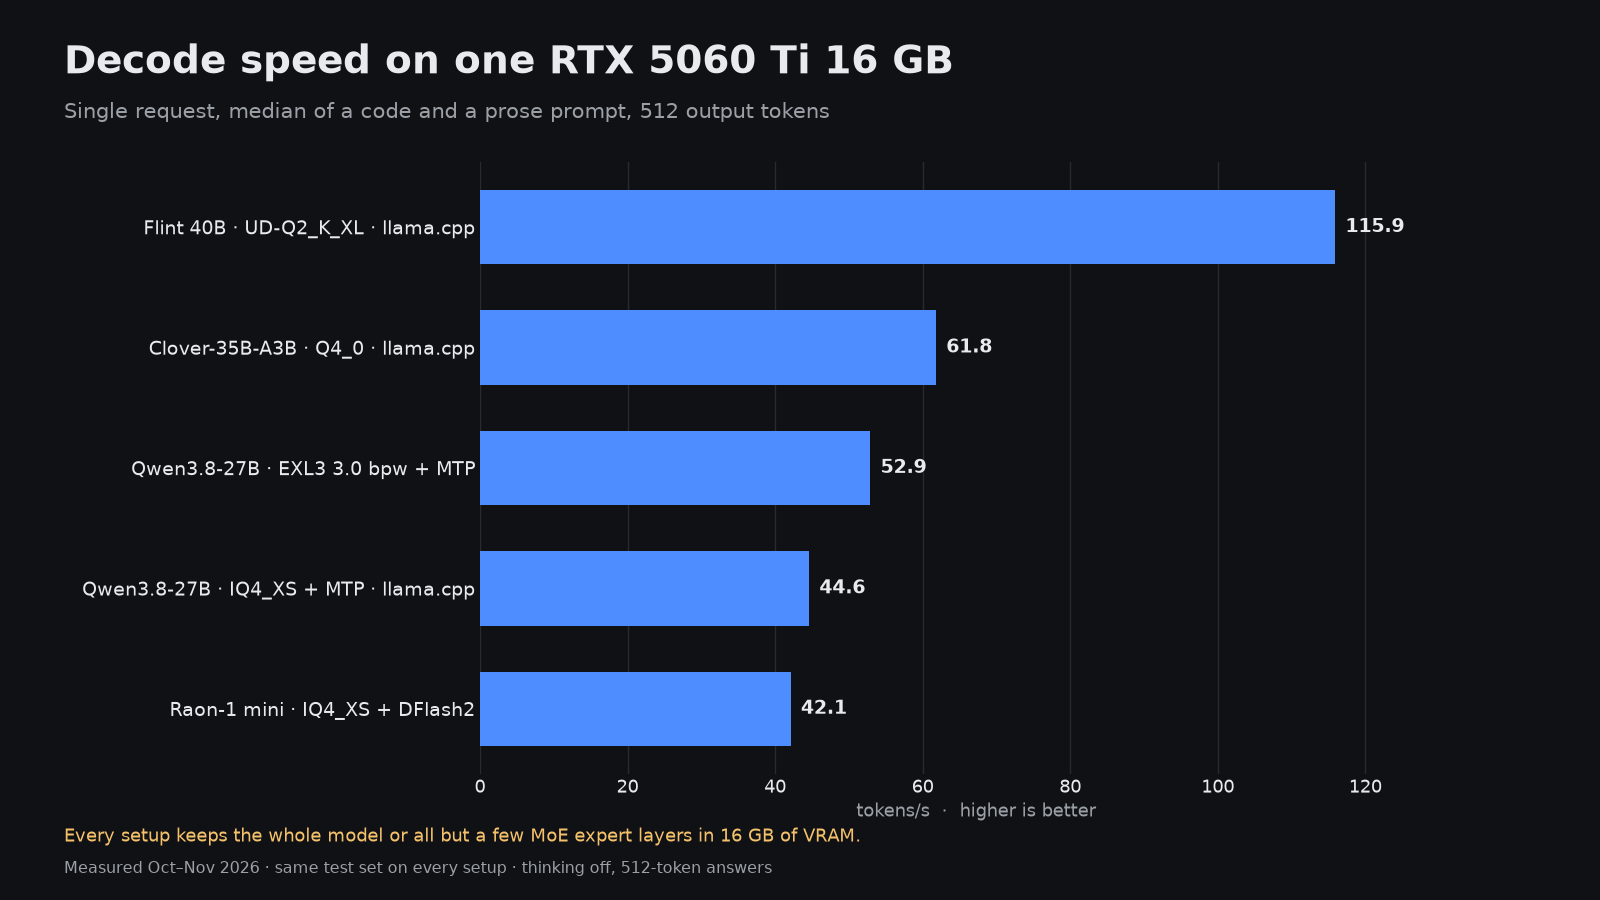
| Modèle et quantification | Moteur | Décodage, tok/s | Prefill 8K, tok/s | Premier token à 32K | Contexte maximal | VRAM maximale |
|---|---|---|---|---|---|---|
| Flint 40B UD-Q2_K_XL | llama.cpp | 115,9 | 2 364 | 15,6 s | 64K | 14,7 GiB |
| Clover-35B-A3B Preview Q4_0 | llama.cpp, 20 couches d’experts en RAM | 61,8 | 992 | 37,4 s | 128K | 14,8 GiB |
| Qwen3.8-27B EXL3 3.0 bpw | ExLlamaV3 avec MTP | 52.9 | 1,027 | 35.7 s | 117,760 | 15.2 GiB |
| Qwen3.8-27B ByteShape IQ4_XS | llama.cpp avec MTP | 44.6 | 998 | 36.8 s | 43,008 | 15.4 GiB |
| Raon-1 mini preview IQ4_XS | llama.cpp, 9 couches d’experts en RAM | 42.1 | 586 | 61.6 s | 16K | 12.9 GiB |
L’écart va presque jusqu’à 3 fois de haut en bas, et le classement selon la vitesse brute n’est pas celui que l’on souhaite pour une utilisation quotidienne. Seule la version Qwen3.8-27B EXL3 possède une note de qualité complète sur cette carte (66,1 % en moyenne sur sept tests). Les autres ont été mesurés en termes de vitesse et de capacité de contexte, mais n’ont pas encore été classés.
Flint 40B est rapide parce qu’il est fortement optimisé
Flint 40B atteint 115,9 tok/s, avec des temps de réponse pour les prompts en code et en prose à 0,2 tok/s d’écart. Il y parvient grâce à une quantification Unsloth à 2 bits (UD-Q2_K_XL) qui permet de garder l’ensemble du modèle en VRAM avec 14,7 GiB, ce qui laisse juste de la place pour un contexte de 64K et rien de plus. Sur la 5090, la version NVFP4 du même modèle a obtenu 38,6 % aux tests de qualité, le score le plus bas parmi toutes les exécutions sur cette carte. Considérez Flint comme un modèle rapide pour la rédaction rapide et les conversations, mais pas comme celui à qui on confie la révision de code.
Qwen3.8-27B est le choix équilibré
La version Qwen3.8-27B EXL3 3,0 bpw issue du kit ExLlamaV3 en un clic décode à 52,9 tok/s (53,6 pour le code, 52,1 pour la prose) et parvient encore à gérer 117 760 tokens de contexte avec 15,2 GiB. C’est la combinaison la plus performante en termes de vitesse, de capacité de contexte et de qualité mesurée sur une carte de 16 GB dans cet ensemble.
Le ByteShape IQ4_XS GGUF du même modèle constitue un bon point de comparaison. Il conserve plus de bits par poids (3,84 bpw), ce qui devrait lui permettre de subir moins de pertes lors de la quantification. Cependant, sa vitesse de décodage est de 44,6 tok/s, ses propositions MTP ne sont acceptées que dans 49,3 % des cas, et la limite de contexte diminue à 43 008 tokens avec 15,4 GiB. Si vous travaillez principalement avec de gros fichiers ou des sessions d’agent, le contexte supplémentaire offert par la version EXL3 est plus important que les bits supplémentaires.
Durée nécessaire pour obtenir le premier token
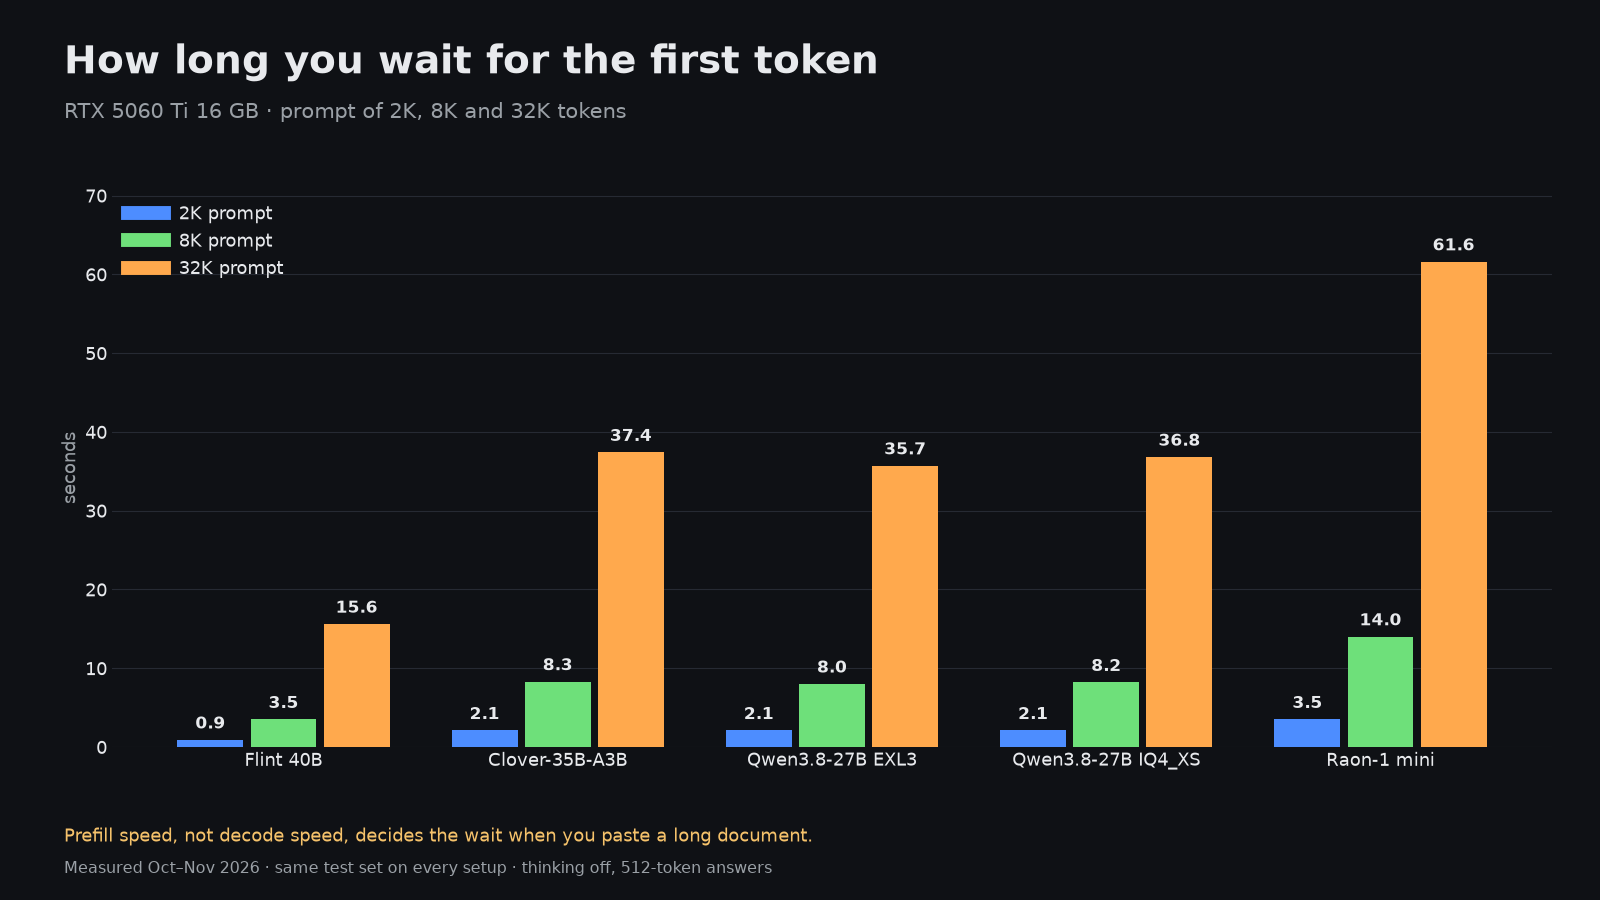
La vitesse de décodage est ce qui fait l’objet des tests de performance, mais sur une carte de 16 GB, le temps d’attente avant que la réponse ne commence est souvent le problème majeur. Une requête de 32 K de tokens, correspondant à peu près à un ensemble de fichiers de code de taille moyenne, nécessite 15,6 s sur Flint, 35,7 s sur Qwen3.8-27B et 61,6 s sur Raon-1 mini. Le préremplissage sur cette carte atteint environ 1 027 tokens/seconde pour un modèle dense de 27 B, de sorte que chaque 10 K de tokens de contexte supplémentaire ajoute environ dix secondes avant l’apparition du premier mot.
Si votre travail consiste en des conversations avec des requêtes courtes, la vitesse de décodage est le paramètre à surveiller. S’il s’agit de RAG, d’agents de codage ou de documents longs, comparez d’abord le temps de préremplissage et le temps nécessaire pour générer le premier token.
Modèles MoE avec des experts en mémoire RAM du système
Les modèles de type mixture-of-experts constituent le principal moyen de traiter des données dépassant les 16 GB que permettrait normalement la mémoire. llama.cpp permet de conserver les poids des experts des premières couches en RAM système à l’aide de l’option --n-cpu-moe, tandis que la GPU gère le reste. La version d’essai de Clover-35B-A3B Preview à Q4_0, avec 20 couches d’experts en RAM, atteint une vitesse de 61,8 tok/s, un contexte de 128 K et un usage maximal de 14,8 GiB de VRAM sur un ordinateur disposant de 32 GB de RAM système. Ce système s’adapte également aux requêtes parallèles : le débit total passe de 46,1 tok/s pour une seule requête à 72,3 tok/s pour quatre requêtes.
La version d’essai de Raon-1 mini montre les conséquences négatives de l’emploi excessif de cette technique. Avec 9 couches d’experts en RAM, il décode à 42,1 tok/s, ne conserve que 17,7 % des versions préliminaires générées par DFlash2, atteint un contexte maximal de 16 K et obtient en moyenne 45,1 % de résultats positifs aux tests de qualité. Le transfert de charges vers d’autres composants fonctionne, mais il s’agit d’un compromis et non d’une capacité supplémentaire gratuite.
Une carte, deux cartes ou une RTX 5090
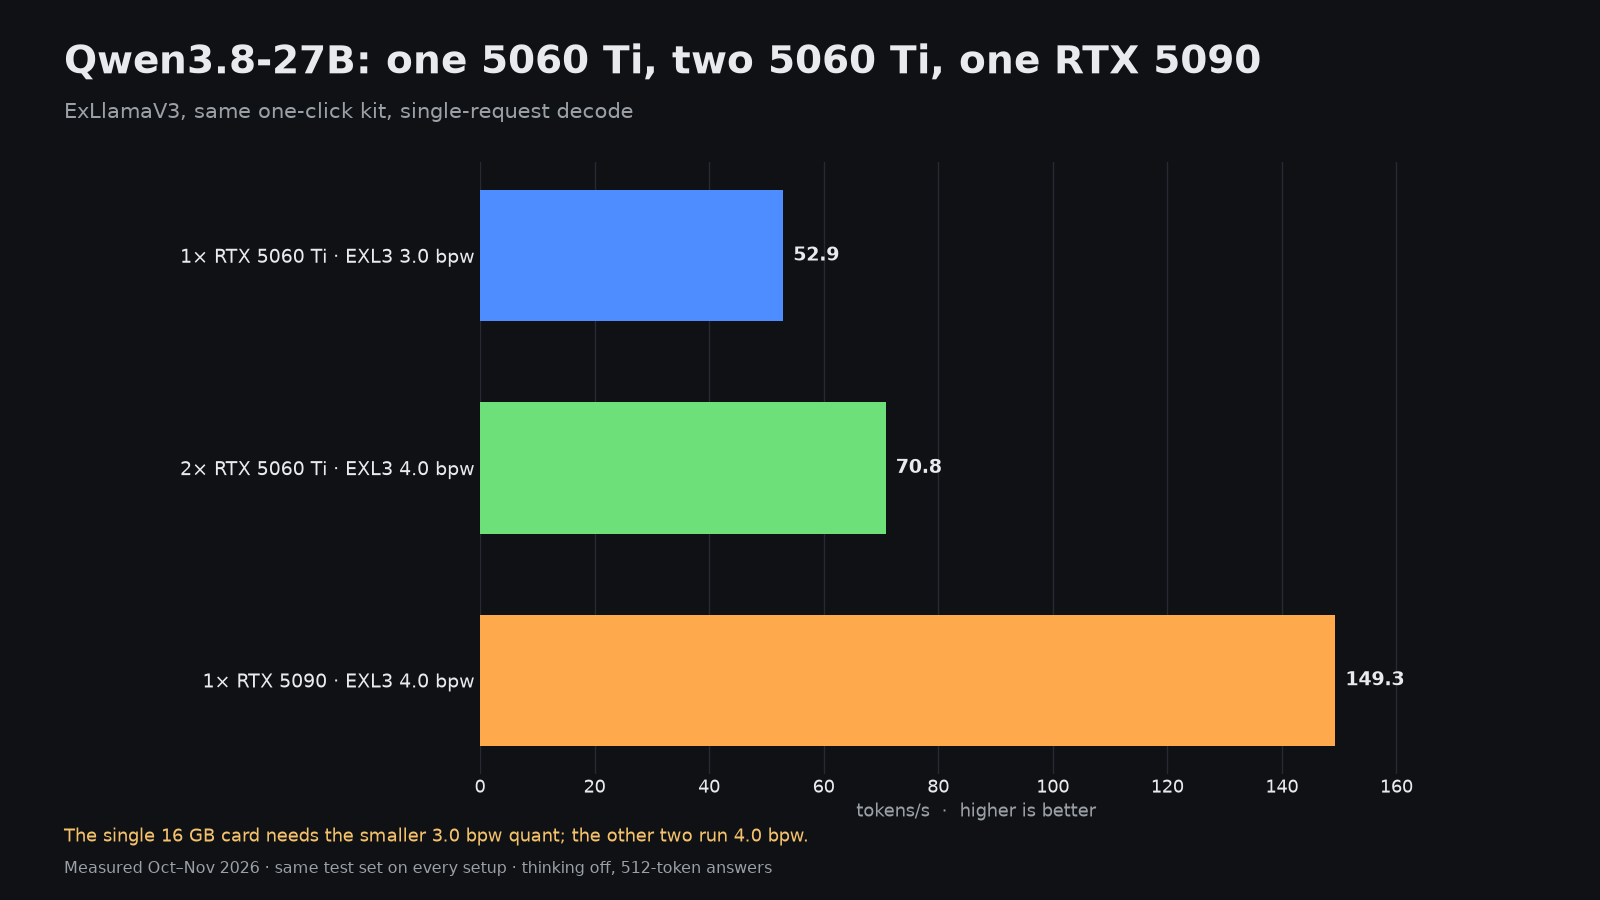
Une deuxième carte 5060 Ti grâce au parallélisme tensoriel permet d’atteindre 70,8 tok/s pour Qwen3.8-27B ; plus important encore, cela permet d’utiliser une quantification EXL3 de 4,0 bpw avec un contexte de 256K, consommant 22,4 GiB sur les deux cartes. La qualité moyenne augmente alors à 67,2 %. Il s’agit bien d’une amélioration réelle, mais la vitesse est seulement environ 34 % supérieure, et non le double.
La RTX 5090 fonctionne avec la même configuration 4,0 bpw, atteignant 149,3 tok/s, soit environ 2,8 fois plus que la 5060 Ti seule et 2,1 fois plus que deux cartes de ce type. La vitesse de précharge en 8K passe de 1 027 à 3 484 tok/s. Si la vitesse est l’objectif, une carte plus grande est préférable à deux cartes plus petites ; si vous possédez déjà une 5060 Ti, la deuxième carte vous offre davantage de contexte et une quantification meilleure.
Images, vidéo, 3D et reconnaissance vocale sur la même carte
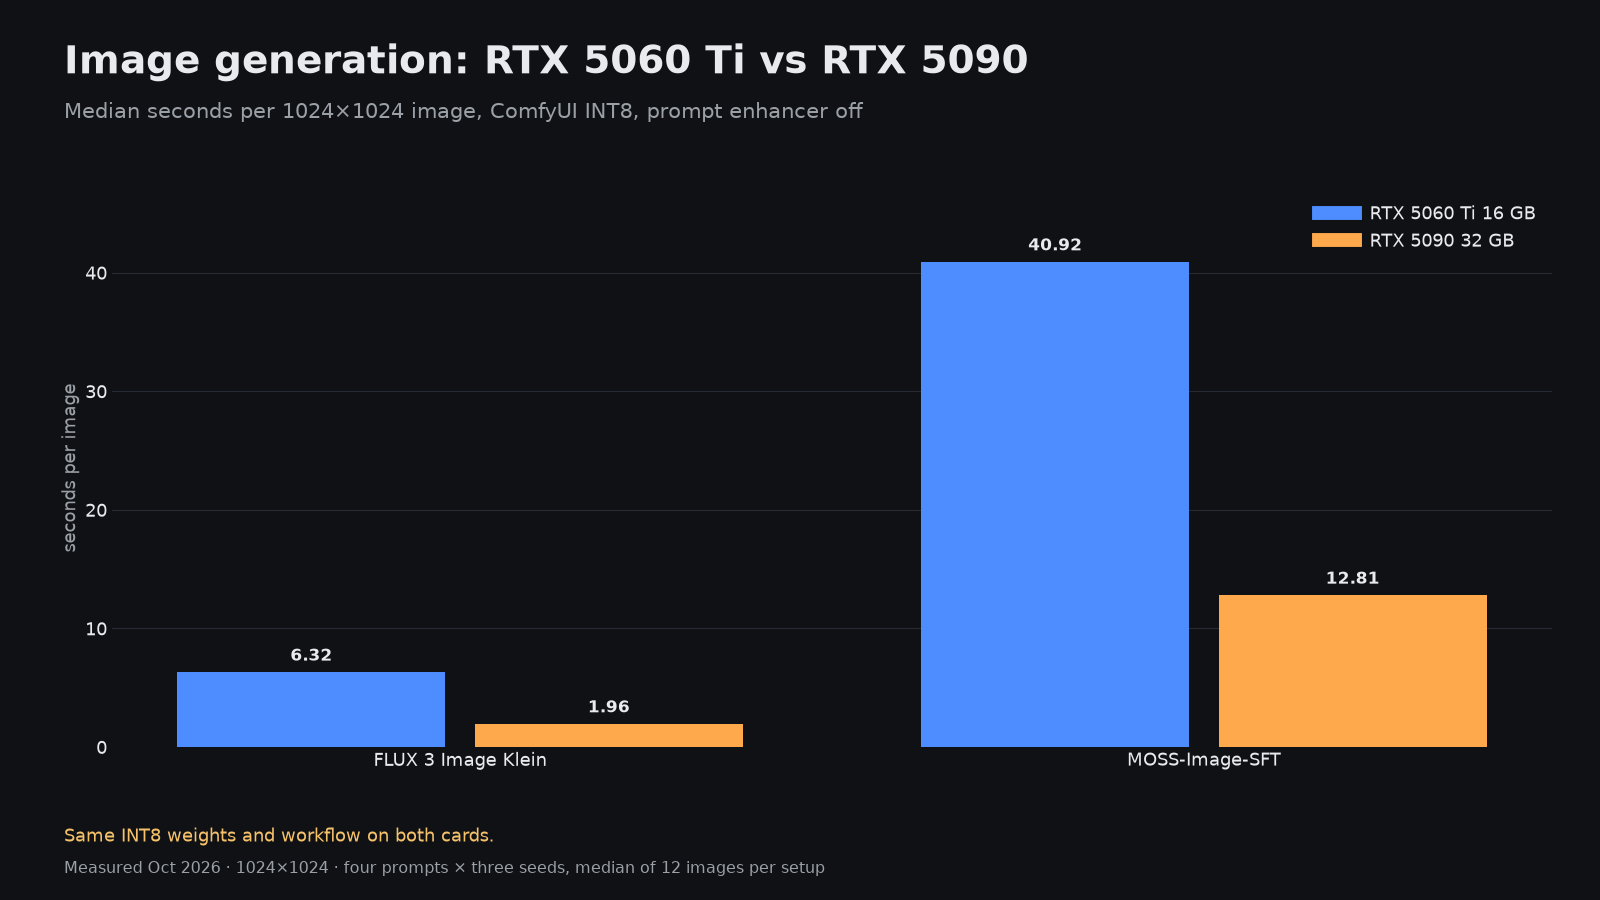
| Tâche | RTX 5060 Ti 16 GB | RTX 5090 32 GB |
|---|---|---|
| Image FLUX Klein | 6,32 s | 1,96 s |
| Image MOSS | 40,92 s | 12,81 s |
| Modèle 3D d’Idol, une image pour générer le maillage | 57,4 s | 14,5 s |
| HyperFlow H3 Flash, clip de 5 secondes avec son, GGUF Q4_K_M | 562,2 s | 107,1 s |
Les images et les modèles 3D sont entièrement utilisables avec 16 GB : une image FLUX Klein en environ six secondes convient bien pour les itérations. C’est avec la vidéo que la carte rencontre des difficultés. Un clip HyperFlow H3 Flash de 5 secondes en résolution 1344×768 nécessite 562,2 s, soit un peu plus de neuf minutes, contre 107,1 s avec la carte 5090 et le même fichier Q4_K_M, et 86,8 s avec la version INT8 qui exige une carte plus puissante.
La reconnaissance vocale est surprenante : Nemotron 3.5 Transcribe parvient à traiter 59 minutes 39 secondes d’audio nettoyé LibriSpeech en 120 secondes sur la 5060 Ti, soit 29,8 fois en temps réel, avec un taux d’erreur de 1,54 % sur les mots. 16 GB suffisent amplement pour la transcription.
Que choisir et quoi exécuter
- Pour une seule carte de 16 GB, commencez avec Qwen3.8-27B EXL3 3.0 bpw dans ExLlamaV3 : 52,9 tok/s, environ 115 K de contexte, qualité évaluée.
- Utilisez Flint 40B pour des conversations et des rédactions rapides à 115,9 tok/s, et conservez un modèle plus puissant pour tout ce qui exige une grande précision.
- Essayez Clover-35B-A3B avec des experts en mémoire vive lorsque vous avez besoin de 128 K de contexte et disposez d’au moins 32 GB de RAM système.
- Prévoyez des délais de génération lents pour de longs prompts. Restez modéré avec les blocs RAG et le contexte de l’agent sur cette carte.
- Les images, la modélisation 3D et la transcription fonctionnent correctement. La génération de vidéos est possible, mais avec environ neuf minutes par clip de 5 secondes, il s’agit d’une opération par lots.
- Si vous choisissez du matériel aujourd’hui et que la vitesse est importante, une RTX 5090 représente une amélioration bien plus significative qu’une seconde carte RTX 5060 Ti.
Comment les chiffres ont été obtenus
Tous les tests avec 16 GB utilisent une RTX 5060 Ti 16 GB sous Linux ; l’ordinateur hôte indiqué est un Core i7-12700K équipé de 32 GB de RAM. La vitesse du modèle de langage correspond à la médiane des réponses composées de 512 tokens obtenues après un temps d’échauffement, la pré-remplissage est mesuré sur des prompts fixes de 2K, 8K et 32K, et la limite de contexte correspond au plus long prompt qui peut être chargé et traité. La qualité est la moyenne de sept tests effectués de manière identique sur chaque configuration testée. Les temps de traitement des images et des vidéos représentent la médiane temporelle allant de la demande jusqu’à la génération du fichier final.